

PHP实现数据血缘图谱_展示字段级别的血缘关系【介绍】
PhpStorm 是 JetBrains 推出的专业 PHP 集成开发环境,可在 Mac 上完成代码编写、智能检查、重构、调试、测试和数据库管理。它支持主流 PHP 框架、Composer、Git、Docker 与远程解释器。
使用SQL解析器进行AST遍历提取字段级血缘关系,构建字段到字段的二维映射边,注意别名、子查询递归解析及不确定来源标注。前端展示采用扁平节点与边结构,字段ID格式为库名.表名.字段名,确保全局唯一。
PHP解析SQL提取字段级血缘关系,这个问题看起来技术性很强,但实际踩过坑的人都知道,真正难的并不是写代码本身,而是怎么避免把关系连错、连丢、连成死循环。不少人觉得用正则就能搞定SQL字段提取,但真正深入到字段级血缘这个层面,就会发现正则这条路走不通——尤其遇到子查询、CTE、JOIN别名嵌套的时候,漏连和错连几乎是必然的。
先说一个核心判断:必须用SQL解析器做语法树遍历,而不是字符串扫描。目前PHP生态里比较靠谱的选择是 php-sql-parser 库(v5+),它能把SQL转成结构化的AST,表别名、列别名、嵌套层级这些关键上下文都能保留住。
举个例子,像这种SQL:
use PHPSQLParser\PHPSQLParser;
$sql = "SELECT a.id, b.name FROM users a JOIN profiles b ON a.id = b.user_id";
$parser = new PHPSQLParser($sql);
// $parser->parsed 包含完整AST,字段节点带 parent_table、alias、base_expr 等字段
拿到AST之后,具体的解析逻辑其实可以拆成几个关键步骤:
- SELECT子句里的每个
colref节点,需要向上追溯——先看有没有表前缀(比如a.id),再查这个前缀在FROM/JOIN里对应的真实表和别名映射 - 如果字段没有前缀(比如直接写
id),那就得结合FROM和JOIN的表顺序+列唯一性做模糊推断。但要注意,这种场景必须标为“不确定来源”,不能强行绑定 - 遇到子查询,需要递归解析它的SELECT AST,然后把外层对子查询的引用(比如
sub.x)映射到子查询内部的输出字段上
这里有一个容易忽略的点:很多人在第二步会选择“猜一个最可能的表”,但这么做会让血缘关系的可信度大打折扣。该标注“不确定来源”的,不能强行绑定;该做递归解析的,不能偷懒停在一层。
如何构建字段→字段的血缘边
血缘图谱的核心是“字段级”,这意味着 users.id → orders.user_id 是一条独立的边,而 users → orders 只是它的一个聚合视图。这就好比你要记录的是每一粒米从哪个粮仓搬到了哪个碗里,而不是简单地记录“粮仓A的东西流向了粮仓B”。
PHP中需要用二维映射来存储这种关系:
$lineage = [
    'orders.user_id' => ['users.id'],
    'reports.total'  => ['orders.amount', 'orders.tax'],
];
这里有几个细节需要特别注意:
- 每条边必须记录来源字段的完整标识符(含库名、表名、字段名),避免同名字段混淆——比如
log.user_id和users.id虽然都叫user_id,但来源完全不同 - JOIN条件中的等值表达式(
a.id = b.user_id)理论上可以拆成双向边,但实际操作中最好根据数据流向来判断。如果是ETL场景,目标表字段由源表派生,那就只记录单向边 - 表达式字段(比如
CONCAT(first_name, ' ', last_name) AS full_name)的处理方式要简单直接:把整个表达式字符串作为来源标识,不要去拆解函数内部的逻辑。拆得越细,出错的可能性越大
为什么不能只靠SHOW CREATE TABLE或INFORMATION_SCHEMA
这个问题很多人问过,答案其实很简单:这些元数据只描述了物理结构,并不包含逻辑依赖。比如一个视图字段 active_users,它的实际来源是 SELECT COUNT(*) FROM users WHERE status='active',但 INFORMATION_SCHEMA.VIEWS 里只存了SQL文本,字段级映射根本看不到。
具体来说,靠元数据解决不了这么几个问题:
- 必须执行SQL解析才能知道
COUNT(*)对应哪些基表字段,否则就会误判为“无来源” - 存储过程或者应用层拼接的SQL(比如
"SELECT * FROM ".$table),元数据完全无法分析,这类场景需要配合代码静态扫描或运行时Hook才能解决 - MySQL 8.0+ 的
performance_schema.table_io_waits_summary_by_table只反映了访问频次,跟血缘关系没有任何关联
前端展示时PHP后端应该返回什么结构
图谱可视化(比如用Cytoscape.js或AntV G6)需要的是一种扁平的节点+边的数据结构,而不是嵌套树。PHP后端应该输出标准JSON,并且字段ID必须保证全局唯一:
[
  {"data": {"id": "users.id", "label": "id", "type": "column", "table": "users"}},
  {"data": {"id": "orders.user_id", "label": "user_id", "type": "column", "table": "orders"}},
  {"data": {"source": "users.id", "target": "orders.user_id", "label": "JOIN"}}
]
这里再说几点实践经验:
- 节点
id推荐用{database}.{table}.{column}的格式(比如mydb.users.id),跨库的时候就不会冲突 - 不要返回“中间节点”比如
subquery_1.full_name,除非它被上层SQL显式引用。临时别名不构成真实血缘节点,放进去只会让图谱变得混乱 - 大模型生成的伪血缘(比如基于注释或命名猜测的结果)必须和解析得出的硬血缘分开标记,前端用不同颜色或线型来区分。混在一起会让使用者对血缘的可信度产生怀疑
字段级血缘真正的难点其实不在解析SQL本身,而在于处理别名链、UNION分支合并、窗口函数引用,以及当同一个字段被多次重命名时如何保持溯源路径不中断。这些情况都要在AST遍历过程中做显式的路径栈管理,单层映射根本应付不来。从实践经验来看,能把这套逻辑理清楚的项目,数据治理的成熟度通常不会太低。
详细介绍如何使用PHP PDO扩展连接MySQL数据库,包含完整的代码示例、DSN配置方法及异常处理技巧,帮助开发者快速建立稳定安全的数据库连接。
深入解析在PHP中递归遍历多级目录文件的两种核心方案:基于SPL标准库的RecursiveDirectoryIterator高效流式迭代,与基于scandir/opendir的自定义递归函数实现,剖析执行机制、内存表现与实战避坑指南。
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
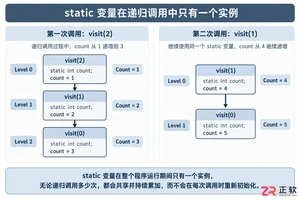
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
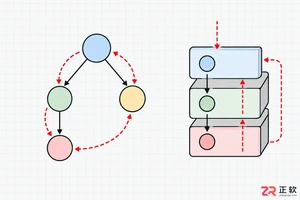
解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
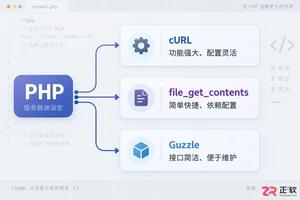
详解PHP中发送HTTP请求的常用方法,包括原生cURL配置、file_get_contents流操作及Guzzle库的使用,提供GET/POST请求的完整代码示例与注意事项。
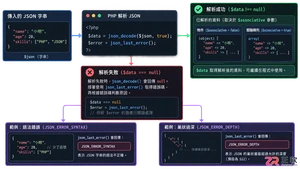
本文详解PHP中json_decode处理嵌套JSON数据的机制,对比对象与数组模式的取值差异,提供防止空指针错误的健壮代码示例,帮助开发者快速定位解析失败原因。
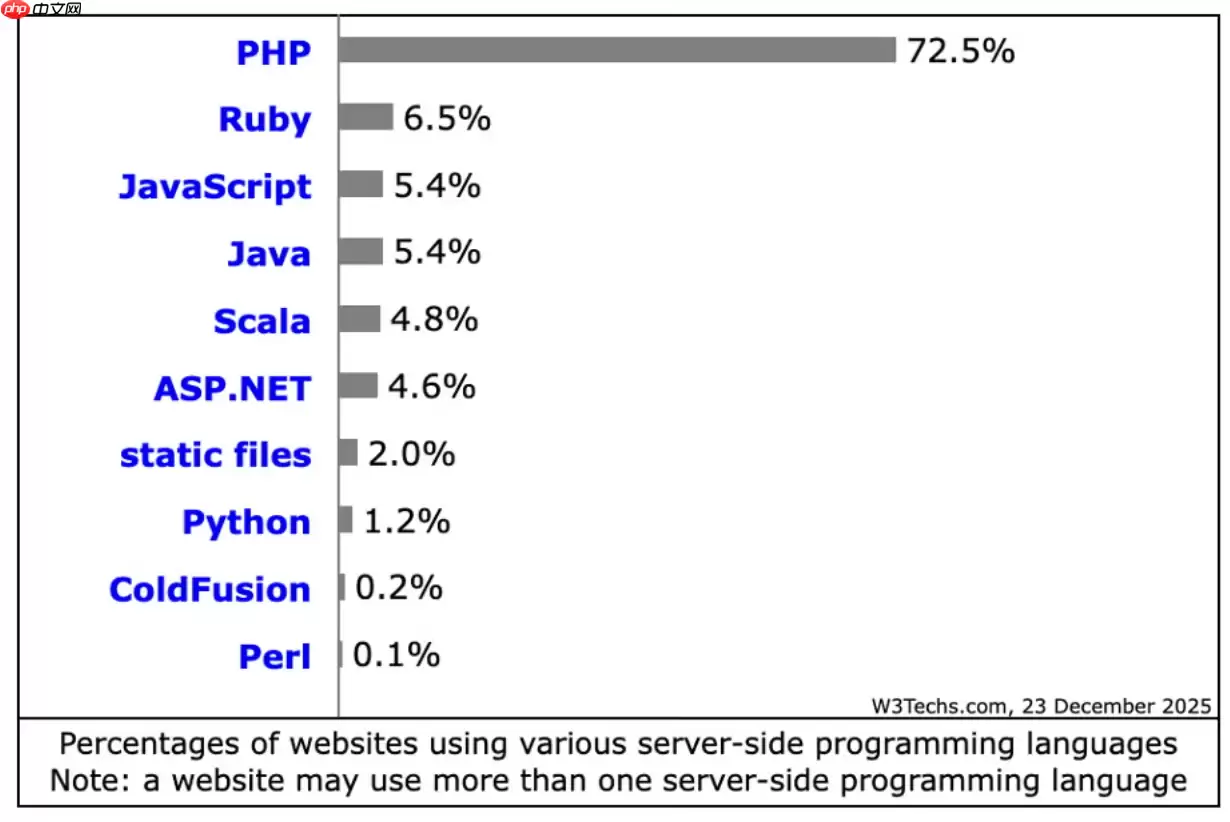
PHP在2026年仍适用于现代网站构建,在常规Web服务和内容密集型站点中较Python、Java等保持优势。其JIT编译优化性能,安全补丁及时,全面支持云原生,拥有成熟框架生态,整体成本较低。
在Debian系统上为PHP配置SSL加密,通常涉及以下几个步骤:安装SSL证书:首先,你需要一个SSL证书。你可以从Let’s Encrypt免费获取,或者购买一个商业证书。使用Let’s Encrypt:sudo apt updatesudo apt install certbotsudo ce



IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


