

如何自定义Filebeat的日志处理规则
Filebeat日志处理规则的自定义涵盖配置结构、多行与JSON日志解析、处理器条件编排及输出路由。支持通过测试命令校验配置,可组合输入、处理器和输出实现清洗。Kubernetes环境中利用注解动态下发采集规则,实现容器日志自动发现与解析。
自定义 Filebeat 日志处理规则的实用指南
先说说最基本的配置结构和生效方式。
默认情况下,配置文件位于 /etc/filebeat/filebeat.yml(rpm/deb 安装方式),旁边还有一个完整的参考示例 /etc/filebeat/filebeat.reference.yml,可以随时拿来对照。建议把自定义规则拆成三个部分来维护:inputs 负责输入,processors 负责处理,output 负责输出。如果用到模块,modules.d 目录下统一管理。改完配置之后,别急着重启,先跑一遍语法校验和连通性测试,确保万无一失再上线。
常用操作其实就那么几条:
- 语法和配置测试:
filebeat test config -e - 输出连通性测试:
filebeat test output - 服务管理(systemd):
sudo systemctl start|enable|status filebeat - 看运行日志:
journalctl -u filebeat -f - 模块管理:在 modules.d 目录执行
filebeat modules enable nginx mysql,或者用filebeat modules list查看已启用的模块
输入与多行 JSON 配置
基础的文件输入配置,核心参数就那么几个:paths 指定采集路径,tags 打业务标签,fields 和 fields_under_root 控制自定义字段是否提升到顶层,encoding 处理编码问题,ignore_older 忽略旧文件,tail_files 从文件尾部开始读取。不过 tail_files 首次导入时要慎用,否则容易丢掉第一条日志。
那多行日志怎么处理呢?比如 Ja va 的堆栈信息,一行根本说不清。用 multiline 配置就能把多行合并成一条事件。常见的策略是“以非行首模式匹配的行作为上一行的延续”,再设置一个超时时间,确保聚合不会无限等待下去。
JSON 日志的处理也不复杂。行内 JSON 可以用 json.keys_under_root、json.overwrite_keys、json.add_error_key、json.message_key 这几个参数,把 JSON 解析到顶层字段,而且还能配合行过滤和多行策略一起使用。
举个例子,看看多行、JSON 和字段增强怎么组合在一起:
filebeat.inputs:
- type: log
  enabled: true
  paths:
    - /var/log/myapp/*.log
  tags: ["myapp", "json"]
  fields:
    app_id: myapp-prod
    env: prod
  fields_under_root: true
  multiline:
    pattern: '^\\[?\\d{4}-\\d{2}-\\d{2}'  # 以日期或 [ 开头的行作为新事件起点
    negate: true
    match: after
    timeout: 5s
  json.keys_under_root: true
  json.overwrite_keys: true
  json.add_error_key: true
  json.message_key: message

processors:
  - timestamp:
      source: datetime
      target: "@timestamp"
      layouts:
        - "2006-01-02T15:04:05.999999999Z07:00"  # 注意这是 Go 时间格式,必须和日志中的时间格式一致

output.elasticsearch:
  hosts: ["http://localhost:9200"]
  index: "filebeat-%{[agent.version]}-%{+yyyy.MM.dd}"
有几个细节需要注意:如果 JSON 顶层没有 message 字段,调整 json.message_key 或者直接移除这个选项;多行和 JSON 解析的先后顺序由配置顺序决定;如果还不够,后面还可以用 processors 继续清洗和增强。
处理器与条件编排
常用处理器其实就那么几个:add_fields、rename、drop_fields、convert 负责字段的增删改和类型转换;decode_json_fields 可以把字符串字段解码成结构化 JSON;timestamp 用来解析时间字段,注意时区要和日志格式匹配;fingerprint 生成事件指纹,常用于去重或者作为文档 ID;add_tags 和 drop_event 则基于条件来打标签或丢弃事件。
条件处理这块,用 when 关键字做判断,支持 equals、contains、regexp 等方式。比如“按日志级别分流处理”,就是典型的应用场景。
来看一个条件打标加去重的例子:
processors:
  - add_tags:
      tags: ["error"]
      when:
        equals:
          log.level: "ERROR"
  - fingerprint:
      fields: ["message", "host.name"]
      target_field: "@metadata._id"
      method: "sha256"
处理器的编排顺序建议遵循一个原则:先解析和标准化(timestamp/json),再丰富和路由(add_fields/tags),最后清理和去重(drop_fields/fingerprint)。这样能减少重复计算,也避免歧义。
输出路由与索引管理
输出到 Elasticsearch 是最直接的方式。通过 index 模板控制索引名,如果需要更复杂的解析和转换,可以在 ES 端配置 pipeline(摄取节点管道),或者在 Filebeat 内部用处理器做轻量清洗。
output.elasticsearch:
  hosts: ["http://es:9200"]
  index: "myapp-%{+yyyy.MM.dd}"
  pipeline: "myapp-ingest-pipeline"
输出到 Kafka 则适合高吞吐、多下游的场景,起到缓冲和解耦的作用。
output.kafka:
  hosts: ["kafka1:9092", "kafka2:9092"]
  topic: "logs-myapp"
  required_acks: 1
  compression: gzip
  partition.round_robin.reachable_only: false
索引和模板方面,用 setup.template.name 和 setup.template.pattern 自定义索引模板。如果用了 ILM(索引生命周期管理),可以结合 setup.ilm.enabled 和 rollover_alias 等参数。如果完全自定义索引名和模板,通常把 setup.template.enabled 设为 false,自己管理模板和 ILM。
Kubernetes 环境的提示式自动发现
在 Kubernetes 或 Docker 环境中,通过 annotations 或 labels 前缀 co.elastic.logs/ 就能动态下发采集规则,完全不用改 Filebeat 主配置。
常用的 hints 包括:
co.elastic.logs/enabled:控制是否采集该容器日志,设为"false"就直接忽略co.elastic.logs/module和fileset.stdout/fileset.stderr:指定模块和标准输出/错误输出文件集co.elastic.logs/json.*:JSON 解析选项,比如message_key、add_error_keyco.elastic.logs/include_lines/exclude_lines:按正则包含或排除行co.elastic.logs/multiline.*:多行合并策略
举个例子,把容器日志按 JSON 解析并指定 message 键:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp
spec:
  template:
    metadata:
      annotations:
        co.elastic.logs/module: nginx
        co.elastic.logs/fileset.stdout: access
        co.elastic.logs/fileset.stderr: error
        co.elastic.logs/json.message_key: "log"
        co.elastic.logs/json.add_error_key: "true"
这些 hints 会被自动发现机制读取,并转换成对应的输入和解析配置。在容器平台上,按服务或命名空间动态采集,这种方式非常灵活,值得推荐。
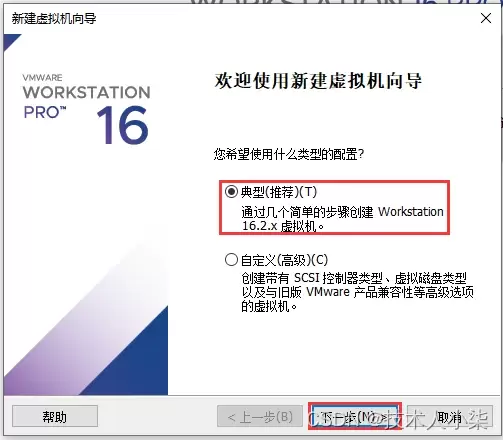
本文详细讲解如何在VMware Workstation中从零开始安装CentOS 7虚拟机。内容涵盖ISO镜像准备、典型配置创建、硬件参数分配(磁盘与内存)、安装器操作及首次启动后的版本与网络验证。通过规范化的步骤指引,帮助读者快速搭建稳定可用的Linux学习环境,并解决常见的启动与网络故障。
在CentOS系统上管理Python依赖库需先更新系统并安装Python3、pip及开发工具。安装方式包括pip(推荐)、yum/dnf(系统级)和conda。通过虚拟环境隔离依赖、用requirements.txt记录版本可避免冲突。卸载通过pip或yum/dnf完成。常见问题涉及权限、缺失系统依赖及版本兼容性。
在CentOS编译Java乱码时,需检查系统编码设为UTF-8,编译用-encodingUTF-8,运行设-Dfile.encoding=UTF-8,确保源文件编码一致,调整IDE编码,中文显示异常则安装中文字体。
通过升级JDK版本、启用增量编译与并行编译、优化JVM参数、利用构建工具高级特性、改进代码结构、进行系统级调优及持续监控分析,可显著提升CentOS环境下Java编译性能,减少重复编译,优化内存使用,从而缩短构建时间,提高开发效率。
在CentOS上编译Java程序时,需安装JDK并正确设置JAVA_HOME环境变量,通过命令查找安装路径并配置到~/.bashrc或/etc/profile中。同时关注编译器错误消息,修复代码语法或逻辑错误,确保Maven或Gradle等构建工具正确安装配置。
在CentOS上编译Golang程序,常见问题包括环境变量配置错误、依赖包管理混乱、glibc版本不兼容、编译器工具链缺失、代码或缓存异常、Go版本不匹配及权限不足,可通过逐一排查对应方法解决。
在CentOS上编译Golang:先安装开发工具包、wget和git;下载Go源码压缩包并解压至/usr/local;配置GOROOT和PATH环境变量(如添加至~/.bashrc),执行source生效;运行goversion验证安装成功。
在CentOS上提升Golang编译速度,可通过优化编译选项(如并行编译、去除调试信息)、将缓存目录指向SSD并定期清理,拆分代码为小包、消除循环依赖、使用vendor本地依赖,升级多核CPU、16GB以上内存和SSD,以及设置GOPROXY、采用PGO优化、升级Go版本等方式实现。
在CentOS编译Go程序时,需正确配置GOROOT、GOPATH等环境变量,使用GoModules管理依赖,注意Glibc版本兼容性,根据需求设置CGO_ENABLED=0实现静态链接,合理配置交叉编译参数,优化二进制文件大小,解决权限问题,并确保Go版本与项目要求一致。



iMazing macOS版是一款面向iPhone、iPad和iPod用户的本地设备管理工具,可在Mac上完成增量备份、资料迁移以及照片、信息、音乐、应用和文件的浏览与导出,并支持USB或局域网连接。
Mercalli macOS版是一款面向视频创作者的独立防抖与畸变校正工具,可分析手持、运动相机及无人机素材,修复抖动、果冻效应和鱼眼变形,并以ProRes或H.264等常用格式导出。
Path Finder 是一款面向 macOS 的专业文件管理器,提供双栏浏览、暂存拖放、文件夹比较与同步、批量重命名、文件筛选及空间分析等工具,适合经常整理素材、归档项目或管理大量文件的用户。
JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,
PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,
PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


