

云上Index:看「简墨」如何为云原生打造全新索引
拓数派首款数据计算引擎 PieCloudDB Database 是一款全新的云原生虚拟数仓。为了提升用户使用体验,提高查询效率,在实现存算分离的同时,PieCloudDB 设计与打造了全新的存储引擎「简墨」等模块,并针对云场景和分析型场景设计了高效的「Data Skipping」索引。本文将详细介绍
拓数派首款数据计算引擎 PieCloudDB Database 是一款全新的云原生虚拟数仓。为了提升用户使用体验,提高查询效率,在实现存算分离的同时,PieCloudDB 设计与打造了全新的存储引擎「简墨」等模块,并针对云场景和分析型场景设计了高效的「Data Skipping」索引。本文将详细介绍 PieCloudDB 的存储和索引的设计与打造过程,并将通过示例来演示 PieCloudDB 如何使用 Data Skipping 索引加速查询的效率。
PieCloudDB作为一款云原生虚拟数仓,依赖云计算提供的基础设施服务,例如大规模分布式集群、虚拟机、容器等。借助这些服务,PieCloudDB能够更好地适应动态变化的工作负载需求,实现高可用、易扩展、异地多活和弹性伸缩等特性。
索引是数据库系统提升查询效率的关键技术,其设计与存储息息相关。为了更好地适应云原生和分析型场景的要求,PieCloudDB 必须使用合理的存储架构及技术,打造一款全新的存储引擎,并实现高效的云上索引技术,满足用户查询需求。PieCloudDB 的存储作为将应用程序和用户数据连接起来的关键桥梁,是云原生虚拟数仓应用的核心组成部分。PieCloudDB 全新存储引擎「简墨」是一款专为云原生和分析型场景设计的高效存储引擎,旨在提供优异的查询性能和灵活的索引技术,以满足用户在云上的数据查询需求。其命名源自「竹简墨书」。

在介绍云上 Index 「Data Skipping」之前,我们先了解一下 PieCloudDB 存储的设计逻辑。
1 存储的详细设计
为了让 PieCloudDB 能够满足不同类型的应用程序要求,PieCloudDB 所打造的存储被分为持久层和数据层两个存储层次:
- 持久层:持久层是 PieCloudDB 中的底层存储,通常采用分布式文件系统或对象存储系统 等云原生存储,如 AWS S3、Azure Blob Storage 等。持久层具有高可用性、持久性等特点,能够安全地保持数据并保证数据的长期存储。
- 数据层:数据层是 PieCloudDB 的上层抽象,提供面向应用程序的标准访问接口,包括半结构化数据、结构化数据和支持 SQL 的无结构化数据存储。
基于上述存储层设计,PieCloudDB 可以满足许多不同类型的应用程序需求。同时,在云计算基础设施的帮助下,PieCloudDB 已实现容器化部署、自动化运维、微服务架构等功能,这样的架构设计为企业用户提供更高效、更可靠、更灵活以及成本更低的解决方案。
1.1 PieCloudDB 数据的持久化设计
对于数据的持久化的设计,通常有如下三种形式:
- N 元存储模型(即通常所说的行存)
- 分解存储模型(即通常所说的列存)
- 混合存储模型
PieCloudDB 采用了第三种:混合存储模型。混合存储模型是将一组数据水平分组,然后将它们的属性垂直划分为列。通过这样的存储模型,PieCloudDB 得以获得列式存储高效处理和压缩友好等优势,同时保留行存储的空间局部性优势,降低数据重组的开销。这一存储模型的选择也影响了 PieCloudDB 中的索引设计,后文将详细介绍。
1.2 PieCloudDB 存储底座
PieCloudDB 使用对象存储技术作为云原生虚拟数仓存储底层。对象存储可以带来可伸缩性、弹性扩展和高度容错性等优点。然而,在实际的使用过程中往往也遇到一些限制,主要包括以下几个方面:
- 延迟:与传统的块存储技术相比,对象存储技术往往具有较高的延迟,因此在某些应用场景下,可能会对数据库的性能产生一定影响。
- 大规模重写操作难以支持:对象存储基于分布式系统实现,而复杂的存储操作(如大规模数据的重写)实现起来是比较困难的,但是,这类操作在关系型数据库中常常会遇到。
- 事务管理:对象存储通常提供了乐观并发控制等简单的事务管理机制,但是它们在处理分布式事务时很复杂,并且由于分散在多处,难以跨所有节点维护一个全局锁或者其他的协调机制。
- 数据一致性:尽管对象存储具有高可靠性和冗余性,但其异步特性意味着分布式数据的一致性需要通过额外的手段来维护,远比其他的分布式数据库解决方案更为复杂,同时也存在较高的管理成本。
PieCloudDB 在存储的打造过程中进行了大量设计来弥补这些限制,保证用户的使用体验。例如针对其中第二个方面,PieCloudDB 的持久化文件在生成后无法进行原地修改。因此,PieCloudDB 在 update/delete删除时,会生成新的文件,在新文件中将包含未修改的数据和新增的修改后的数据,并将保留旧的数据文件。相关细节将在未来的技术文章中进行说明,欢迎关注。
2 PieCloudDB 中的索引
基于云的基础设施的特点和 PieCloudDB 的存储设计思路,PieCloudDB 的存储具有以下两个重要的特性。
- 使用混合存储模型
- 持久化的文件不会被修改
这些特性也决定了 PieCloudDB 索引的打造思路。在详细介绍 PieCloudDB 的索引特性前,我们先了解一下索引的常见类型。
2.1 索引的常见类型
在OLTP场景下,数据库通常要处理大量短期事务,需要高效执行单个记录的读写操作。为避免全量扫描数据,采用基于树的索引结构(如B+Tree)能加速少量数据的查询。这些索引就像超市货架上的分类标签,能帮助数据库引擎快速定位到特定记录,从而提升读写性能。随着数据的增量更新,索引也得跟着更新,以保持数据的一致性和性能。
而在 OLAP 场景中,数据库通常面对大量数据的分析查询,例如数据仓库和数据分析。在这种情况下,很少涉及单个记录的查找,而是涉及到对大量数据的聚合、过滤和分析。传统的索引结构可能不再适用,因为对大规模数据集的全量扫描可能会变得非常耗时。
为了加速 OLAP 查询的执行,PieCloudDB 采用数据跳跃(Data Skipping)技术。数据跳跃是一种先进的优化技术,用于尽可能减少扫描数据时的 I/O 开销。它的主要思想是在执行查询时,跳过对那些不符合查询条件的数据块或分区的扫描。这样可以有效地减少 I/O 操作,从而加速查询的执行速度。
2.2 PieCloudDB 中的 Data Skipping 索引
Zone Map 索引和 BRIN(Block Range INdex)索引是在 OLAP 场景中常见的数据跳跃(Data Skipping)技术的具体实现方式。它们都利用了预先计算的统计信息来跳过不符合查询条件的数据块,从而加速查询的执行。
Zone Map 是通过存储每个数据块的选定列的预先计算统计信息,例如最小值和最大值,以及其他聚合信息。在查询期间,数据库可以使用这些统计信息来裁减要访问的数据块,从而减少不必要的 I/O 操作,提高查询性能。这在 OLAP 场景中对大规模数据集的查询非常有用。
在 PieCloudDB 中,每个数据块即是一组记录的列存数据。在数据导入时,每个文件将会统计对应数据块所需列的统计信息,得益于数据存储的实现,每列的统计过程和存储也变得更为简单高效。
2.3 示例
在 PieCloudDB 中,当用户进行查询时,对于每一个数据块,首先会通过查询条件对应列的统计信息判断是否满足条件,如果满足则访问该数据块,如果不满足则跳过该数据块。接下来我们将通过一个示例为大家详细演示 PieCloudDB 的 Data Skipping 功能。
首先,创建一张表,分次导入一些测试数据。
create table dataskip (a int, b int);
insert into dataskip select i, i*2 from generate_series(1, 1000)i;
insert into dataskip select i, i*2 from generate_series(1001, 2000)i;
insert into dataskip select i, i*2 from generate_series(2001, 3000)i;
insert into dataskip select i, i*2 from generate_series(3001, 4000)i;
insert into dataskip select i, i*2 from generate_series(4001, 5000)i;
insert into dataskip select i, i*2 from generate_series(5001, 6000)i;
insert into dataskip select i, i*2 from generate_series(6001, 7000)i;
insert into dataskip select i, i*2 from generate_series(7001, 8000)i;
insert into dataskip select i, i*2 from generate_series(8001, 9000)i;
insert into dataskip select i, i*2 from generate_series(9001, 10000)i;
现在来执行查询:
demo=# explain analyze select * from dataskip where a < 10;
                                  QUERY PLAN
---------------------------------------------------------------------------------
Gather Motion 3:1 (slice1; segments: 3) (cost=2.00..10.21 rows=3 width=8) (actual time=34.361..36.928 rows=9 loops=1)
-> Bitmap Heap Scan on dataskip (cost=2.00..10.17 rows=1 width=8) (actual time=16.189..31.790 rows=5 loops=1)
    Recheck Cond: (a < 10)
    Rows Removed by Index Recheck: 316
    -> Bitmap Index Scan on dataskip (cost=0.00..2.00 rows=333 width=0) (actual time=2.908..2.910 rows=1 loops=1)
    Index Cond: (a < 10)
Planning Time: 4.259 ms
  (slice0) Executor memory: 159K bytes.
  (slice1) Executor memory: 32972K bytes avg x 3 workers, 32972K bytes max (seg0).
Memory used: 128000kB
Optimizer: Postgres query optimizer
Execution Time: 55.895 ms
(12 rows)
如果关闭Data Skipping查询
demo=# set enable_bitmapscan = off;
SET
demo=# explain analyze select * from dataskip where a < 10;
                                  QUERY PLAN
---------------------------------------------------------------------------------
Gather Motion 3:1 (slice1; segments: 3) (cost=0.00..51.71 rows=3 width=8) (actual time=129.916..140.925 rows=9 loops=1)
    -> Seq Scan on dataskip (cost=0.00..51.67 rows=1 width=8) (actual time=2.939..132.546 rows=5 loops=1)
    Filter: (a < 10)
    Rows Removed by Filter: 3292
Planning Time: 0.099 ms
  (slice0) Executor memory: 123K bytes.
  (slice1) Executor memory: 32825K bytes avg x 3 workers, 32825K bytes max (seg0).
Memory used: 128000kB
Optimizer: Postgres query optimizer
Execution Time: 154.416 ms
(10 rows)
可以看到,当关闭 Data Skipping 时,可以看到执行时间是使用时的三倍。
这里还面临查询优化器的一个挑战,在复杂的 join 查询条件下,需要尽可能的将 join 条件或 where 条件下推到扫描节点上来尽可能的利用 Data Skipping。在这一点上,PieCloudDB 远胜于其他的产品。
demo=# explain analyze select * from dataskip join jtbl on dataskip.a = jtbl.a and jtbl.a < 10;
                                    QUERY PLAN
---------------------------------------------------------------------------------
Gather Motion 3:1 (slice1; segments: 3) (cost=2.00..15.47 rows=3 width=16) (actual time=33.638..33.712 rows=9 loops=1)
    -> Nested Loop (cost=2.00..15.43 rows=1 width=16) (actual time=33.300..33.405 rows=5 loops=1)
    Join Filter: (dataskip.a = jtbl.a)
    Rows Removed by Join Filter: 20
    -> Redistribute Motion 3:3 (slice2; segments: 3) (cost=0.00..5.21 rows=2 width=8) (actual time=0.003..0.013 rows=5 loops=1)
    Hash Key: jtbl.a
    -> Seq Scan on jtbl (cost=0.00..5.17 rows=2 width=8) (actual time=3.144..20.979 rows=3 loops=1)
    Filter: (a < 10)
    Rows Removed by Filter: 356
    -> Materialize (cost=2.00..10.19 rows=1 width=8) (actual time=5.547..5.554 rows=4 loops=6)
    -> Redistribute Motion 3:3 (slice3; segments: 3) (cost=2.00..10.19 rows=1 width=8) (actual time=33.130..33.269 rows=5 loops=1)
    Hash Key: dataskip.a
    -> Bitmap Heap Scan on dataskip (cost=2.00..10.17 rows=1 width=8) (actual time=11.766..24.910 rows=5 loops=1)
    Recheck Cond: (a < 10)
    Rows Removed by Index Recheck: 316
    -> Bitmap Index Scan on dataskip (cost=0.00..2.00 rows=333 width=0) (actual time=2.783..2.784 rows=1 loops=1)
    Index Cond: (a < 10)
Planning Time: 6.522 ms
  (slice0) Executor memory: 220K bytes.
  (slice1) Executor memory: 79K bytes avg x 3 workers, 80K bytes max (seg0). Work_mem: 17K bytes max.
  (slice2) Executor memory: 32826K bytes avg x 3 workers, 32826K bytes max (seg0).
  (slice3) Executor memory: 32975K bytes avg x 3 workers, 32975K bytes max (seg0).
Memory used: 128000kB
Optimizer: Postgres query optimizer
Execution Time: 68.989 ms
(25 rows)
对于相同的 Query,当我们关掉 Data Skipping 时,查询时间又变成了前者的3倍。
demo=# set enable_bitmapscan = off;
SET
demo=# explain analyze select * from dataskip join jtbl on dataskip.a = jtbl.a and jtbl.a < 10;
                                   QUERY PLAN
---------------------------------------------------------------------------------Gather Motion 3:1 (slice1; segments: 3) (cost=0.00..56.97 rows=3 width=16) (actual time=139.811..139.886 rows=9 loops=1)
    -> Nested Loop (cost=0.00..56.92 rows=1 width=16) (actual time=139.587..139.691 rows=5 loops=1)
    Join Filter: (dataskip.a = jtbl.a)
    Rows Removed by Join Filter: 20
    -> Redistribute Motion 3:3 (slice2; segments: 3) (cost=0.00..5.21 rows=2 width=8) (actual time=0.003..0.011 rows=5 loops=1)
    Hash Key: jtbl.a
    -> Seq Scan on jtbl (cost=0.00..5.17 rows=2 width=8) (actual time=1.758..21.023 rows=3 loops=1)
    Filter: (a < 10)
    Rows Removed by Filter: 356
    -> Materialize (cost=0.00..51.69 rows=1 width=8) (actual time=23.262..23.269 rows=4 loops=6)
    -> Redistribute Motion 3:3 (slice3; segments: 3) (cost=0.00..51.69 rows=1 width=8) (actual time=136.260..139.557 rows=5 loops=1)
    Hash Key: dataskip.a
    -> Seq Scan on dataskip (cost=0.00..51.67 rows=1 width=8) (actual time=1.730..134.913 rows=5 loops=1)
    Filter: (a < 10)
    Rows Removed by Filter: 3292
Planning Time: 0.248 ms
  (slice0) Executor memory: 185K bytes.
  (slice1) Executor memory: 79K bytes avg x 3 workers, 80K bytes max (seg0). Work_mem: 17K bytes max.
  (slice2) Executor memory: 32826K bytes avg x 3 workers, 32826K bytes max (seg0).
  (slice3) Executor memory: 32827K bytes avg x 3 workers, 32827K bytes max (seg0).
Memory used: 128000kB
Optimizer: Postgres query optimizer
Execution Time: 155.026 ms
(23 rows)
2.4 Primary Key 的支持
对于一般的 OLTP 数据库中,Primary Key 的作用主要包含以下几个方面:
- 加速点查
- 确保唯一性约束
- 确保非空约束
然而,在 OLAP 数据库中,因为其主要面向分析查询,点查(Point Lookup)的需求较少,而全表扫描和大规模数据跳跃技术更为重要。因此,一些 OLAP 数据库在实现 Primary Key 时会做出相应的调整。
例如,在ClickHouse中,Primary Key 被用于数据加载时进行排序,排序之后的数据可大大提高 Data Skipping 的性能。在 Snowflake 中也有类似的 Cluster Key 来使数据块具有聚集性,再通过 Auto Cluster(自动聚集)来提高 Data Skipping 的性能(Databricks 也采用类似的方式)。
在 PieCloudDB 中 Primary Key 支持非空约束,但是对于查询的加速,一般使用 Data Skipping。对于唯一值约束,PieCloudDB 中暂不支持。
3 PieCloudDB 的索引探索之路
除了 Data Skipping,PieCloudDB 也在调研和实现多种多样的索引以提供不同场景的性能提升,包括基于 Data Skipping 思路的其他索引探索和 OLTP 场景下的索引探索。
3.1 基于 Data Skipping 思路的其他索引探索
在上述的讨论中,PieCloudDB 中目前的索引按分类属于稀疏索引(Sparse Index),除了通常的 Zone Map 类型索引之外,常见的还有如下实现:
- 基于 bitmap 的索引
- bloom filter
- column sketchs
- column imprints
- ......
3.2 OLTP 场景下的索引
上述讨论中,我们也提到了传统的基于树的索引例如 B+Tree 等。类似这一类的索引也被称为密集索引(dense index)。在 PieCloudDB 中,我们也不能完全排除其对查询的实际意义,我们将持续对这一领域进行探索。

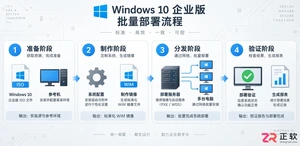
学习如何高效部署Windows 10企业版。本文详解准备安装介质、配置标准系统、处理驱动与分区、制作可部署镜像以及分批验证的实操步骤,帮助管理员实现标准化、可回滚的批量安装。
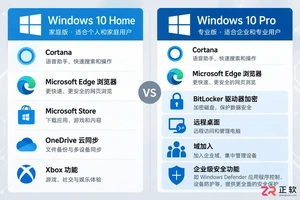
想知道如何将 Windows 10 家庭版升级到专业版?本文详解通过微软商店购买和输入产品密钥两种官方升级方法,说明数据保留情况、成本计算及升级后如何验证 BitLocker 和远程桌面等功能,助您安全获取专业版权限。
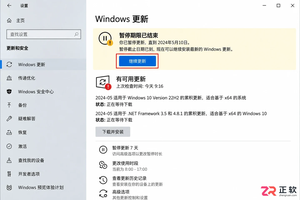
Windows 10 自动更新突然重新启用怎么办?本文详解暂停35天期限结束、误点继续更新、重启后任务续跑及公司域策略覆盖等常见原因,提供查看更新历史、设置活动时间和正确使用疑难解答的操作指南,帮助用户在支持结束前安全管理系统更新。
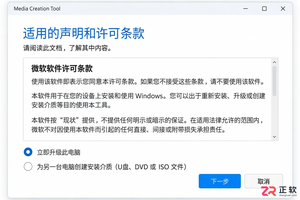
解决 Media Creation Tool 在下载 Windows 镜像时速度慢、中断或报错的问题。本文按操作顺序指导用户检查网络连接、系统权限、磁盘空间及 U 盘状态,确保顺利制作可启动安装介质。
不确定该选Windows 10家庭版还是专业版?本文解析两者在远程连接、磁盘加密和虚拟化等方面的实际差异,帮你避开性能误区,根据真实使用场景做出最具性价比的选择。
Win10断电重启后总是自动继续更新怎么办?别强行关机,先等恢复完成。教你用暂停更新、设置活动时间和按流量计费连接,减少更新对工作的打扰。注意Win10支持已终止,长期不更新有风险。
解析Windows 10功能更新与质量更新的区别。说明个人家庭版无法永久单独关闭功能更新,专业版可通过组策略延迟功能升级。提醒用户关注Win10支持终止时间,避免误用禁用服务导致安全风险。
想知道Win10连手机热点时如何避免偷跑流量?只需将热点网络设为“按流量计费的连接”,即可限制Windows Update自动下载非优先更新。本文提供详细界面导览与设置步骤,助你精准控制后台数据消耗。
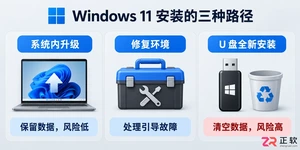
详解 Windows 11 安装的三种路径风险,指导如何制作官方安装介质、正确进入启动菜单、安全清理磁盘分区以及装后验证激活状态,帮助用户避免数据丢失和安装失败。
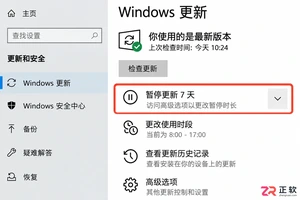
想只关闭Win10大版本升级但保留安全补丁?本文区分功能更新与质量更新,详解专业版组策略配置方法,并说明家庭版限制及Win10停止支持后的应对建议。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。