

数栈技术分享:Hive优化之配置参数的优化
Hive是大数据领域常用的组件之一,主要用于大数据离线数仓的运算,关于Hive的性能调优在日常工作和面试中是经常涉及的一个点,因此掌握一些Hive调优是必不可少的一项技能。影响Hive效率的主要因素有数据倾斜、数据冗余、job的IO以及不同底层引擎配置情况和Hive本身参数和HiveSQL的执行等。
Hive是大数据领域常用的组件之一,主要用于大数据离线数仓的运算,关于Hive的性能调优在日常工作和面试中是经常涉及的一个点,因此掌握一些Hive调优是必不可少的一项技能。影响Hive效率的主要因素有数据倾斜、数据冗余、job的IO以及不同底层引擎配置情况和Hive本身参数和HiveSQL的执行等。本文主要从建表配置参数方面对Hive优化进行讲解。
1. 创建一个普通表
table test_user1(id int, name string,code string,code_id string ) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';2. 查看这张表的信息
DESCRIBE FORMATTED test_user1;
我们从该表的描述信息介绍建表时的一些可优化点。
2.1 表的文件数
numFiles表示表中含有的文件数,当文件数过多时可能意味着该表的小文件过多,这时候我们可以针对小文件的问题进行一些优化,HDFS本身提供了解决方案:
(1)Hadoop Archive/HAR:将小文件打包成大文件。
(2)SEQUENCEFILE格式:将大量小文件压缩成一个SEQUENCEFILE文件。
(3)CombineFileInputFormat:在map和reduce处理之前组合小文件。
(4)HDFS Federation:HDFS联盟,使用多个namenode节点管理文件。
除此之外,我们还可以通过设置hive的参数来合并小文件。
(1)输入阶段合并
要对Hive的输入文件格式进行更改,即调整参数hive.input.format。它的默认值是org.apache.hadoop.hive.ql.io.HiveInputFormat,我们将其修改为org.apache.hadoop.hive.ql.io.CombineHiveInputFormat。相较于上述对mapper数的调整,这种方式会新增两个参数,分别是mapred.min.split.size.per.node和mapred.min.split.size.per.rack,它们的意义在于规定了单节点和单机架上的最小split大小。倘若发现有split大小小于这两个值(默认均为100MB),那么就会进行合并操作。具体的逻辑,大家可以在Hive源码的对应类中查看。
(2)输出阶段合并
直接将hive.merge.mapfiles和hive.merge.mapredfiles都设为true即可,前者表示将map-only任务的输出合并,后者表示将map-reduce任务的输出合并,Hive会额外启动一个mr作业将输出的小文件合并成大文件。另外,hive.merge.size.per.task可以指定每个task输出后合并文件大小的期望值,hive.merge.size.smallfiles.a vgsize可以指定所有输出文件大小的均值阈值,默认值都是1GB。如果平均大小不足的话,就会另外启动一个任务来进行合并。
2.2 表的存储格式
通过InputFormat和OutputFormat可以看出表的存储格式是TEXT类型,Hive支持TEXTFILE, SEQUENCEFILE, A VRO, RCFILE, ORC,以及PARQUET文件格式,可以通过两种方式指定表的文件格式:
(1)CREATE TABLE ... STORE AS
(2)ALTER TABLE ... [PARTITION partition_spec] SET FILEFORMAT
如果要改变创建表的默认文件格式,可以使用set hive.default.fileformat=
扩展:不同存储方式的情况
TEXT, SEQUENCE和 A VRO文件是面向行的文件存储格式,不是最佳的文件格式,因为即便只查询一列数据,使用这些存储格式的表也需要读取完整的一行数据。另一方面,面向列的存储格式(RCFILE, ORC, PARQUET)可以很好地解决上面的问题。关于每种文件格式的说明,如下:
(1)TEXTFILE
创建表时的默认文件格式,数据被存储成文本格式。文本文件可以被分割和并行处理,也可以使用压缩,比如GZip、LZO或者Snappy。然而大部分的压缩文件不支持分割和并行处理,会造成一个作业只有一个mapper去处理数据,使用压缩的文本文件要确保文件不要过大,一般接近两个HDFS块的大小。
(2)SEQUENCEFILE
key/value对的二进制存储格式,sequence文件的优势是比文本格式更好压缩,sequence文件可以被压缩成块级别的记录,块级别的压缩是一个很好的压缩比例。如果使用块压缩,需要使用下面的配置:set hive.exec.compress.output=true; set io.seqfile.compression.type=BLOCK
(3)A VRO
二进制格式文件,除此之外,a vro也是一个序列化和反序列化的框架。a vro提供了具体的数据schema。
(4)RCFILE
全称是Record Columnar File,首先将表分为几个行组,对每个行组内的数据进行按列存储,每一列的数据都是分开存储,即先水平划分,再垂直划分。
(5)ORC
全称是Optimized Row Columnar,从hive0.11版本开始支持,ORC格式是RCFILE格式的一种优化的格式,提供了更大的默认块(256M)
(6)PARQUET
另外一种列式存储的文件格式,与ORC非常类似,与ORC相比,Parquet格式支持的生态更广,比如低版本的impala不支持ORC格式。
配置同样数据同样字段的两张表,以常见的TEXT行存储和ORC列存储两种存储方式为例,对比执行速度。
TEXT存储方式


总结:从上图中可以看出列存储在对指定列进行查询时,速度更快,建议在建表时设置列存储的存储方式。
2.3 表的压缩
对Hive表进行压缩是常见的优化手段,一些存储方式自带压缩选择,比如SEQUENCEFILE支持三种压缩选择:NONE,RECORD,BLOCK。Record压缩率低,一般建议使用BLOCK压缩;
ORC支持三种压缩选择:NONE,ZLIB,SNAPPY。我们以TEXT存储方式和ORC存储方式为例,查看表的压缩情况。
配置同样数据同样字段的四张表,一张TEXT存储方式,另外三张分别是默认压缩方式的ORC存储、SNAPPY压缩方式的ORC存储和NONE压缩方式的ORC存储,查看在hdfs上的存储情况:
TEXT存储方式

默认压缩ORC存储方式

SNAPPY压缩的ORC存储方式

NONE压缩的ORC存储方式

总结:可以看到ORC存储方式将数据存放为两个block,默认压缩大小加起来134.69M,SNAPPY压缩大小加起来196.67M,NONE压缩大小加起来247.55M,TEXT存储方式的文件大小为366.58M,且默认block两种存储方式分别为256M和128M,ORC默认的压缩方式比SNAPPY压缩得到的文件还小,原因是ORZ默认的ZLIB压缩方式采用的是deflate压缩算法,比Snappy压缩算法得到的压缩比高,压缩的文件更小。ORC不同压缩方式之间的执行速度,经过多次测试发现三种压缩方式的执行速度差不多,所以建议采用ORC默认的存储方式进行存储数据。
2.4 分桶分区
Num Buckets表示桶的数量,我们可以通过分桶和分区操作对Hive表进行优化:
对于一张较大的表,可以将它设计成分区表,如果不设置成分区表,数据是全盘扫描的,设置成分区表后,查询时只在指定的分区中进行数据扫描,提升查询效率。要注意尽量避免多级分区,一般二级分区足够使用。常见的分区字段:
(1)日期或者时间,比如year、month、day或者hour,当表中存在时间或者日期字段时,可以使用些字段。
(2)地理位置,比如国家、省份、城市等
(3)业务逻辑,比如部门、销售区域、客户等等
分桶表和分区表类似,都是将HDFS上的大表文件分割成多个文件。不过,分桶表是在分区的基础上,进行更细粒度的划分。它是依据分桶字段属性值的hash值来区分整个数据内容的。分桶有什么好处呢?它可以加快数据采样,还能提升join的性能(前提是join的字段是分桶字段)。这是因为分桶能确保某个key对应的数据在一个特定的桶内(也就是文件),所以如果巧妙地选择分桶字段,就能大幅提升join的性能。一般来说,分桶字段可以选择那些经常用于过滤操作或者join操作的字段。
创建分桶表
create table test_user_bucket(id int, name string,code string,code_id string ) clustered by(id) into 3 buckets ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';查看描述信息
DESCRIBE FORMATTED test_user_bucket多出了如下信息

查看该表的hdfs

同样的数据查看普通表和分桶表查询效率
普通表

分桶表

普通表是全表扫描,分桶表在按照分桶字段的hash值分桶后,根据join字段或者where过滤字段在特定的桶中进行扫描,效率提升。
本文首发于:数栈研习社
数栈是云原生—站式数据中台PaaS,我们在github上有一个有趣的开源项目:FlinkX
FlinkX是一个基于Flink的批流统一的数据同步工具,既可以采集静态的数据,比如MySQL,HDFS等,也可以采集实时变化的数据,比如MySQL binlog,Kafka等,是全域、异构、批流一体的数据同步引擎,大家如果有兴趣,欢迎来github社区找我们玩~
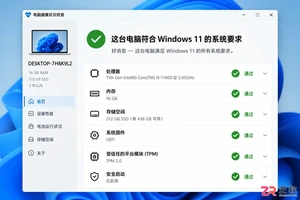
Windows 11 家庭版和专业版在安装步骤上并无本质差异,主要区别在于产品密钥激活和功能解锁。本教程指导你如何检查硬件兼容性、使用官方媒体创建工具制作安装盘,以及在安装过程中正确选择版本。同时解析安装后如何验证激活状态,以及从家庭版升级到专业版的正规路径,确保系统稳定且合规。
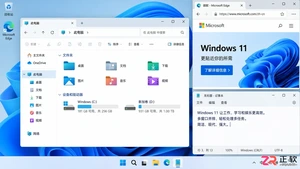
除了开始菜单的变化,Windows 11在TPM 2.0安全要求、窗口贴靠布局、驱动兼容性以及系统更新策略上与Windows 10有显著不同。本文详解两者实质差异,助你判断是否值得升级。
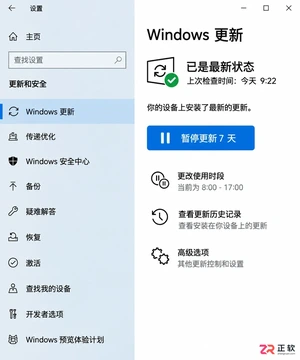
详解Windows 10家庭版和专业版在关闭或暂停自动更新时的操作区别。涵盖通用的暂停更新、活动时间设置,以及专业版独有的组策略管理入口,帮助不同版本用户合理控制更新节奏,避免系统安全风险。
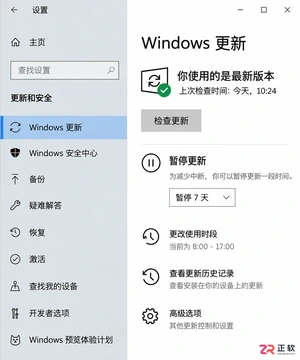
想知道Win10暂停更新最长能设多久?官方支持最长暂停35天。本文图文演示如何在设置中开启暂停、确认生效日期,以及到期后如何恢复更新或调整活动时间以避免打扰。
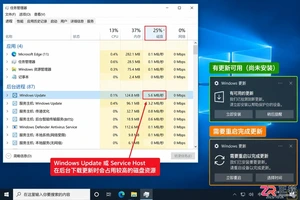
本教程介绍如何在Windows 10中通过暂停更新、设置活动时间及安排重启时间来减少更新弹窗提醒。包含通知隐藏技巧及更新失败排查步骤,帮助你在保持系统安全的同时减少工作打扰。
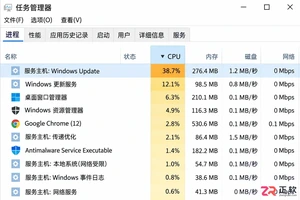
Windows 10 更新时 CPU 占用过高怎么办?本教程演示如何通过任务管理器确认更新进程,使用“暂停更新”功能临时停止后台活动,并设置“活动时间”防止自动重启干扰工作。提供安全的故障排查步骤,避免直接禁用系统服务带来的风险。
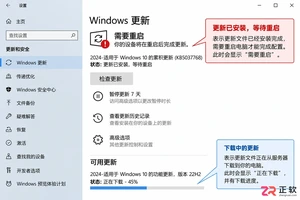
Win10玩游戏时突然弹出更新重启提示?不要强制关机。本文教你如何通过设置“活动时间”避免自动重启,利用“安排重启”规划空闲时间,以及合理使用“暂停更新”功能。区分不同状态下的应对策略,既保护游戏进度又维持系统安全。
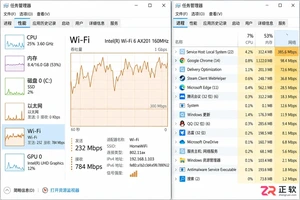
Win10自动更新抢占带宽导致游戏卡顿或网页打不开?本教程教你通过任务管理器确认更新进程,利用暂停更新、按流量计费连接和传递优化带宽限制,精准控制Windows Update下载速度,解决网络拥堵问题。
Win10家庭版用户常受强制更新困扰。本文详解如何利用系统自带的暂停更新、活动时间和安排重启功能,在不破坏系统稳定性的前提下减少更新打扰,并分析注册表修改的风险及系统支持现状。
Windows 10更新后开机突然要求输入密码?本文解析自动登录失效的真实原因,提供通过netplwiz重新保存凭据、关闭Windows Hello干扰及排查账户策略的完整步骤,助你恢复免密进入桌面。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。