

PDF转Markdown是什么?表格OCR转Markdown会丢内容吗?
PDF转Markdown是把页面内容整理为标题、段落、列表、代码块和表格等轻量结构;文章比较在线转换、OCR识别与本地开源流程,并说明合并单元格、跨页表头、公式、脚注和阅读顺序可能造成的内容丢失。转换后应按原PDF复核表格行列、公式与标题层级。
PDF 转 Markdown 不是把页面外观原样搬过去,而是把内容重新整理成可编辑的结构。正文和普通列表通常较稳,复杂表格、公式、脚注与多栏排版最容易丢失或顺序错乱。
Markdown保留结构,不负责复刻整张页面
转换前先决定最终用途:知识库更看重标题和段落,数据整理更看重表格准确度。扫描件必须先OCR;跨页表格最好逐表处理,并保留原PDF作为校对依据。
- 普通文字:重点检查标题层级、列表缩进和段落顺序。
- 表格OCR:合并单元格和跨页表头可能被拆散,金额与日期要抽查。
- 公式与脚注:可能转成图片或纯文本,需要根据目标平台手动修正。
先按文件情况选择路径
| 文件情况 | 建议方法 | 操作重点 |
|---|---|---|
| 临时单份、可上传 | PDF.cn 在线工具 | 先用代表文件测试 |
| 敏感或批量文件 | 用开源解析器离线转换 | 优先离线和副本操作 |
| 结构复杂或正式交付 | 用编辑器预览后人工修订 | 保留原件并做逐项验收 |
方法一:用 PDF.cn 在线处理
临时单份、允许上传的文件,可从 PDF转Markdown 进入。下面五步使用本地保存的真实中文页面图,操作前先保留原文件。
1. 找到工具入口
从 PDF.cn 首页进入PDF转Markdown,先核对工具名称和处理方向。
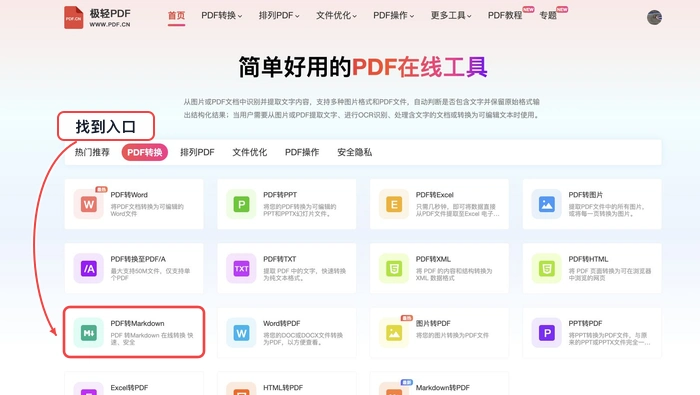
找到对应工具入口
2. 选择并上传 PDF
使用副本上传,文件名相近时先确认版本;上传过程中不要重复点击。
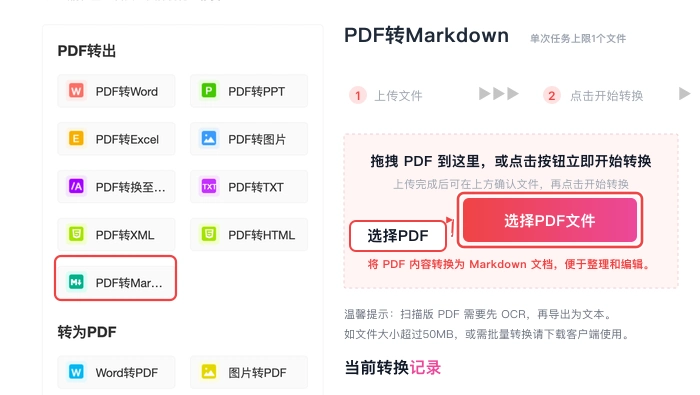
选择并上传 PDF 副本
3. 核对文件状态
检查文件名、大小和状态,页数或名称异常时先停止处理。
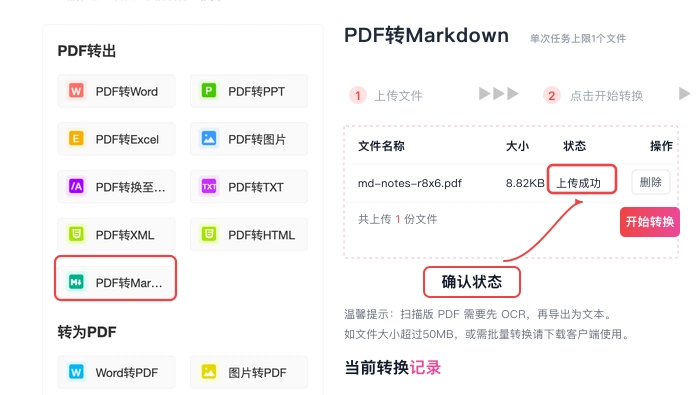
核对文件状态和名称
4. 设置参数并开始处理
根据用途设置PDF转Markdown参数,先用代表文件或少量页面测试。
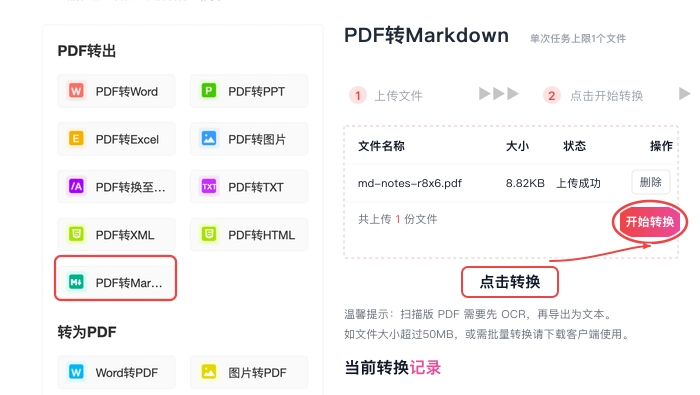
确认设置后开始处理
5. 下载后立即验收
不要只看“处理成功”,重新打开结果并按页数、内容和版式逐项验收。
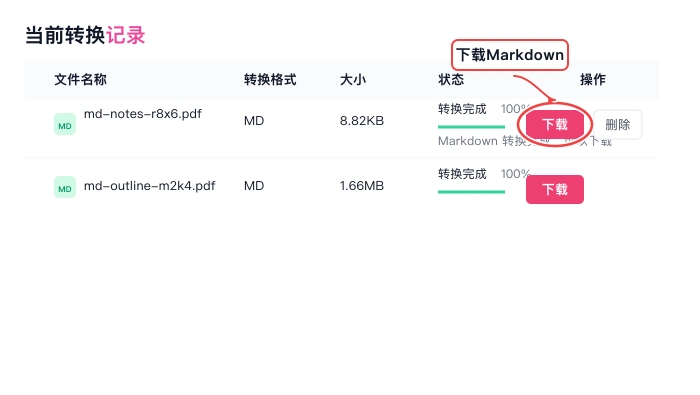
下载结果并重新打开
方法二:用开源解析器离线转换
适合批量文档、隐私材料和需要二次开发的场景。先固定版本与参数,再把图片输出目录和 Markdown 文件一起保存。
先在副本上测试一个代表页面,再处理整份文件;结束后关闭并重新打开结果,避免把临时视图当成永久修改。
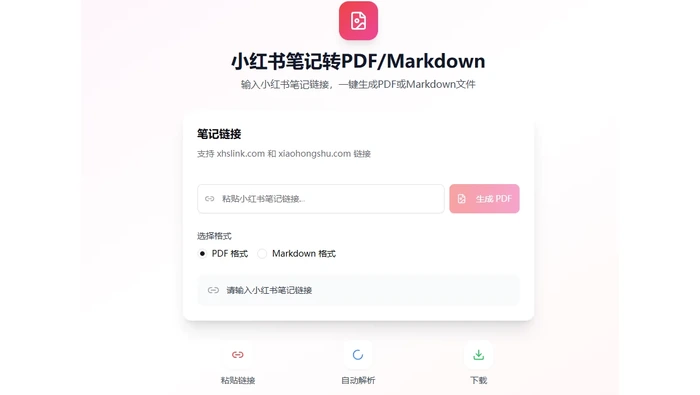
开源工具离线把PDF转Markdown
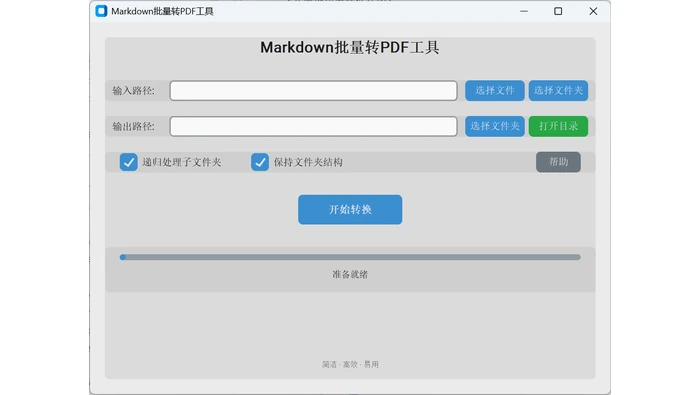
输出Markdown和图片资源目录
方法三:用编辑器预览后人工修订
在 Typora 或 VS Code 中打开结果,通过目录、图片和表格预览定位结构问题;复杂页面应回看原 PDF。
先在副本上测试一个代表页面,再处理整份文件;结束后关闭并重新打开结果,避免把临时视图当成永久修改。
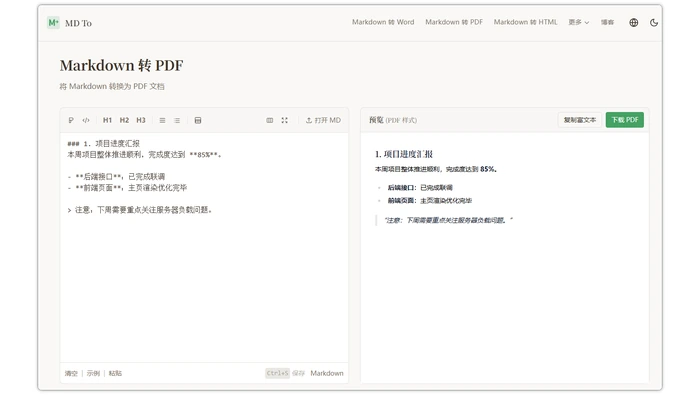
Typora预览Markdown结构
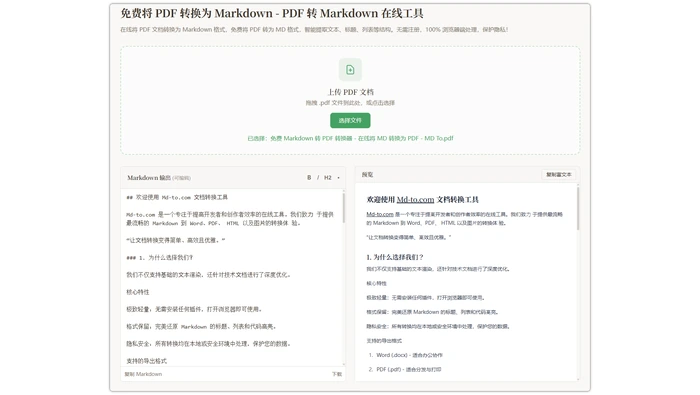
VS Code检查Markdown标题和图片
常见问题
1、PDF转Markdown是什么?
它把PDF中的内容提取并重组为Markdown语法,便于在知识库、编辑器和版本管理中继续修改。它强调内容结构,不保证保留PDF的精确坐标和视觉版式。
2、表格OCR转Markdown会丢内容吗?
可能会。无边框表格、合并单元格、跨页表头和低清扫描最容易漏列或错行。转换后应核对行列数、合计值和关键字段,复杂表格可先转Excel再整理为Markdown。
相关工具
参考来源
同类 PDF 操作不必靠反复试错,前往极轻PDF网站按文件情况选择对应方法即可。
高效实现 PDF 转 Markdown 格式。本文提供 PDF.cn 在线转换工具、开源解析器离线处理及 Markdown 编辑器预览修订方案,轻松解决标题层级紊乱、多栏排版串行与图片链接失效等常见问题。




火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




