

怎么在Python中调用C语言代码提升性能
详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。
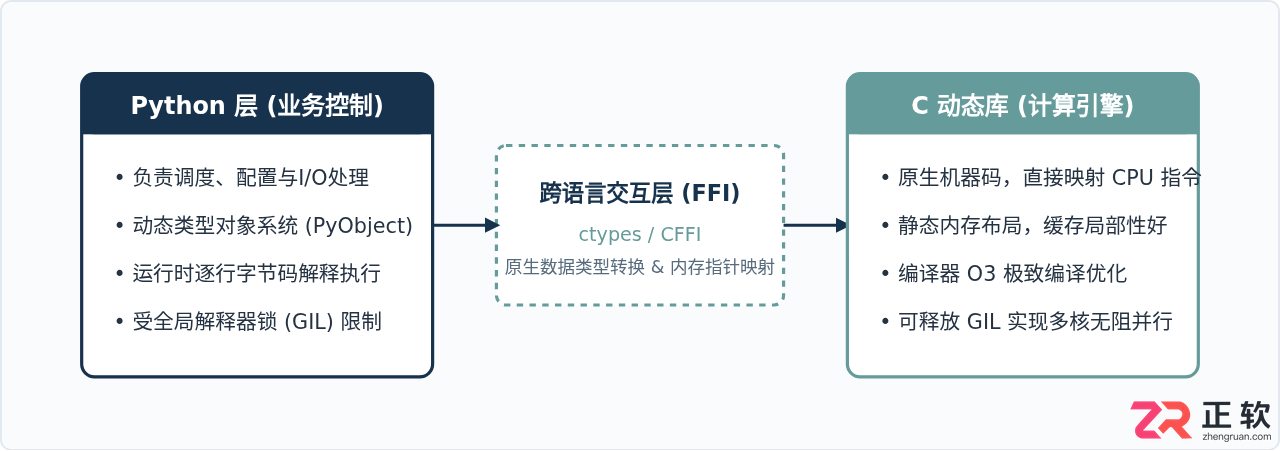
在Python中提升计算性能的最直接方式之一,是将CPU密集型核心运算逻辑剥离至C语言中实现,并在编译为动态链接库(.so 或 .dll)后由Python按需调用。这种架构让Python专注于上层业务组织和高层逻辑编排,底层纯计算、紧密循环和底层内存连续访问则交由C语言以原生机器码高速运行。
为什么将性能瓶颈迁移至C语言
Python作为动态解释型语言,变量在底层均为结构体对象(如 PyObject)。每次针对数值的算术运算,解释器都需要进行动态类型解包、对象分配、类型检查及垃圾回收处理。此外,CPython运行时的全局解释器锁(GIL)限制了多线程在多核CPU上的并行能力。
相比之下,C语言在编译期确定数据类型,内存布局紧凑连续,编译产物可由编译器开启矢量化优化,直接映射到底层CPU指令集执行。在处理大数组变换、密集的数值积分或复杂递归时,直接执行机器码的效率通常比解释执行高出一到两个数量级。
主要实现方案与技术选型
Python生态中调用C代码的方式有多种。不同方案在接入复杂度、维护成本与执行开销上各有侧重:
- 标准库 ctypes:Python官方自带,无需安装任何第三方依赖。使用非常方便,适合轻量级函数调用或对已有动态库进行快速封装。
- CFFI (C Foreign Function Interface):现代跨语言调用标准,兼容PyPy,提供API模式和ABI模式。解析C头文件直接生成绑定,兼顾安全性与性能。
- CPython 原生 C API:通过编写符合Python内部规范的C模块(包含
Python.h)进行深度扩展。执行开销最低,但学习门槛高,涉及繁琐的对象引用计数管理。
核心实践:从C编写到Python调用全流程
整个落地过程分为四个严格衔接的步骤:提取瓶颈计算、编写C函数、编译为动态共享库、在Python中通过接口层调用并校验。
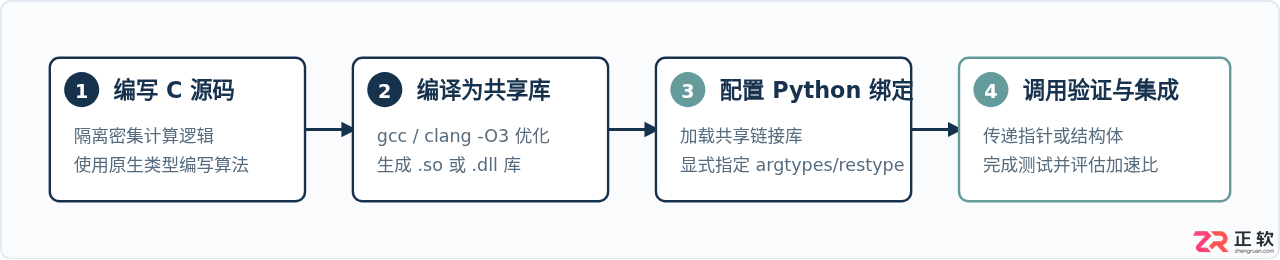
第一步:编写性能敏感的C语言逻辑
我们以一个经典的数值积分任务为例:计算圆周率 $\pi$ 的近似值(计算公式为 $\int_{0}^{1} \frac{4}{1+x^2} dx$)。这段代码在循环体内包含数千万次浮点运算,是典型的计算密集型场景。
新建文件 calc.c:
#include

// 计算数值积分,steps 为离散区间划分数量
double compute_pi(long long steps) {
    double sum = 0.0;
    double step_size = 1.0 / (double)steps;

    for (long long i = 0; i < steps; i++) {
        double x = (i + 0.5) * step_size;
        sum += 4.0 / (1.0 + x * x);
    }

    return sum * step_size;
}

// 数组平滑处理:展示数组与指针传递场景
void apply_moving_average(const double* input, double* output, int size, int window) {
    int half = window / 2;
    for (int i = 0; i < size; i++) {
        double current_sum = 0.0;
        int count = 0;
        for (int w = -half; w <= half; w++) {
            int idx = i + w;
            if (idx >= 0 && idx < size) {
                current_sum += input[idx];
                count++;
            }
        }
        output[i] = current_sum / count;
    }
}
第二步:编译生成动态共享库
Python无法直接执行C代码源码文件,必须先通过编译器生成与操作系统匹配的共享目标文件(Linux/macOS 下为 .so,Windows 下为 .dll)。
打开终端,执行以下编译命令:
# Linux 或 macOS 平台
gcc -O3 -shared -fPIC -o libcalc.so calc.c

# Windows 平台(使用 MSVC 命令行工具)
# cl /O2 /LD calc.c /Fe:libcalc.dll-O3:开启最高等级编译优化,包含自动向量化与循环展开;-shared:生成共享链接库而非可执行二进制文件;-fPIC:生成位置无关代码(Position Independent Code),共享库加载到内存任意地址均可执行。
第三步:使用 ctypes 实现零外部依赖调用
ctypes 会根据你当前运行的平台加载动态链接库。最关键的一步是明确声明函数签名(参数类型与返回值类型)。如果省略,ctypes会默认假定返回值是 32位 int,这会导致浮点数或64位指针被截断,返回错误数据甚至引发内存崩溃。
新建文件 main_ctypes.py:
import sys
import os
import ctypes

# 1. 动态确定链接库文件后缀
lib_ext = '.dll' if sys.platform.startswith('win') else '.so'
lib_path = os.path.abspath(f"./libcalc{lib_ext}")

# 2. 加载共享链接库
calc_lib = ctypes.CDLL(lib_path)

# 3. 显式声明 compute_pi 的参数与返回值类型
calc_lib.compute_pi.argtypes = [ctypes.c_longlong]
calc_lib.compute_pi.restype = ctypes.c_double

# 4. 显式声明 apply_moving_average(数组与指针传递)
calc_lib.apply_moving_average.argtypes = [
    ctypes.POINTER(ctypes.c_double), # input 数组指针
    ctypes.POINTER(ctypes.c_double), # output 数组指针
    ctypes.c_int,                    # size
    ctypes.c_int                     # window
]
calc_lib.apply_moving_average.restype = None

# 执行标量计算测试
steps = 50_000_000
result_pi = calc_lib.compute_pi(steps)
print(f"[ctypes 计算结果] Pi = {result_pi:.10f}")

# 执行数组处理测试
raw_data = [1.0, 3.0, 5.0, 7.0, 9.0, 11.0]
size = len(raw_data)
# 创建 ctypes 连续内存数组
c_arr_in = (ctypes.c_double * size)(*raw_data)
c_arr_out = (ctypes.c_double * size)()

calc_lib.apply_moving_average(c_arr_in, c_arr_out, size, 3)
output_data = list(c_arr_out)
print(f"[ctypes 数组滤波结果] {output_data}")
运行结果示例:
[ctypes 计算结果] Pi = 3.1415926536
[ctypes 数组滤波结果] [2.0, 3.0, 5.0, 7.0, 9.0, 10.0]
第四步:使用 CFFI 方案(更安全的替代方案)
ctypes 需要在Python里手动声明类型映射,稍有不慎容易引发段错误。CFFI 允许你直接粘贴纯C语言函数原型声明,让调用更直观、更稳健。
安装依赖:pip install cffi,新建文件 main_cffi.py:
from cffi import FFI
import sys
import os

ffi = FFI()

# 直接声明 C 语言函数原型,无需手动组装 ctypes 类型
ffi.cdef("""
    double compute_pi(long long steps);
    void apply_moving_average(const double* input, double* output, int size, int window);
""")

lib_ext = '.dll' if sys.platform.startswith('win') else '.so'
lib_path = os.path.abspath(f"./libcalc{lib_ext}")

# 加载链接库
C = ffi.dlopen(lib_path)

# 调用计算
steps = 50_000_000
pi_val = C.compute_pi(steps)
print(f"[CFFI 计算结果] Pi = {pi_val:.10f}")

# 内存缓冲区调用
data = [10.0, 20.0, 30.0, 40.0, 50.0]
n = len(data)
c_in = ffi.new("double[]", data)
c_out = ffi.new("double[]", n)

C.apply_moving_average(c_in, c_out, n, 3)
print(f"[CFFI 数组滤波结果] {[c_out[i] for i in range(n)]}")
实际性能对比与瓶颈分析
为了验证性能收益,我们在相同机器环境下对 5000 万步数值积分进行计算耗时对比:纯 Python 代码通过原生 for 循环计算,C 语言通过 -O3 优化编译后由 ctypes 与 CFFI 调用。
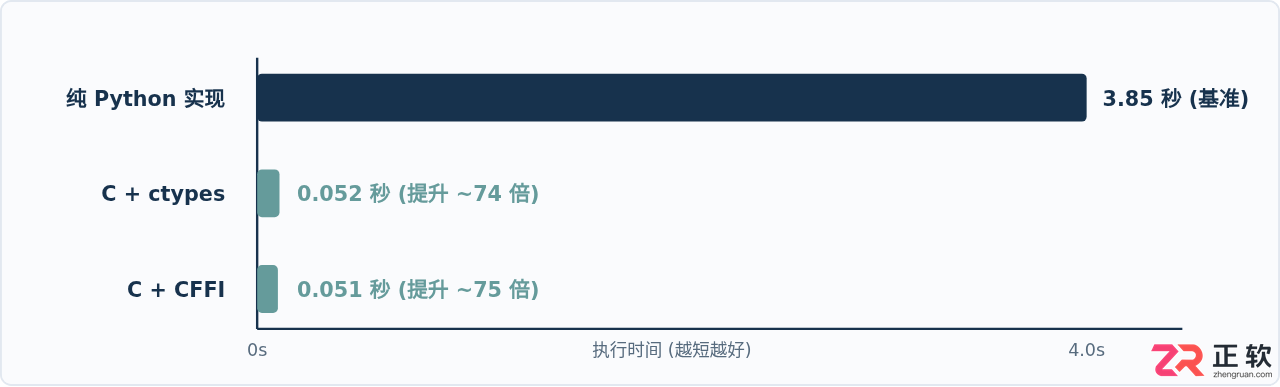
可以看到,将计算密集环节下沉至C语言后,计算耗时从数秒压缩到了数十毫秒,性能提升了70倍以上。这一收益主要来自:
- 消除所有中间变量对象的频繁创建与引用计数变更;
- C语言连续内存访问使现代CPU的L1/L2数据缓存命中率显著提高;
- 编译器生成了基于SIMD指令集的AVX并行指令。
避免常见的性能反模式与踩坑指南
虽然调用C语言具有极高的性能上限,但如果架构设计不合理,反而可能引发性能倒退或程序崩溃。
跨越语言层调用C函数并不是零成本的。每次通过ctypes或CFFI调用函数,Python都要执行参数打包、数据解包、类型检查和压栈。如果一个C函数单次耗时只有几个纳秒,却在Python循环体内被调用数百万次,边界开销将远超C语言自身的加速收益。
正确做法:将整个密集循环搬入C代码内部,在Python端只做一次调用并传入整批数据。
在Python和C之间传递庞大数据集时,不要使用普通的Python列表转换。如果将一个包含千万元素的Python List转换为C原生数组,转换本身的时间开销将极其庞大。
正确做法:在Python中直接使用
numpy.ndarray、array 模块或 bytearray,获取其底层内存连续缓冲区的真实指针(如 arr.ctypes.data_as(ctypes.POINTER(ctypes.c_double))),实现零拷贝直接读写。
跨语言编程时必须遵循清晰的内存管理责任制:谁分配,谁释放。如果在C函数内通过
malloc() 分配了内存并返回指针给Python,Python垃圾回收器无法感知这段内存,必须暴露一个专门的 free_memory(ptr) 导出函数由Python主动释放,否则会导致持续的内存泄漏。
决策总结
通过C语言优化Python性能是一种性价比极高的策略。它不需要你将整套业务系统推倒重构,而是遵循经典的“80/20法则”:先通过内置的 cProfile 准确找到耗费绝大多数CPU周期的热点代码,再将该局部模块以纯C重构封装。
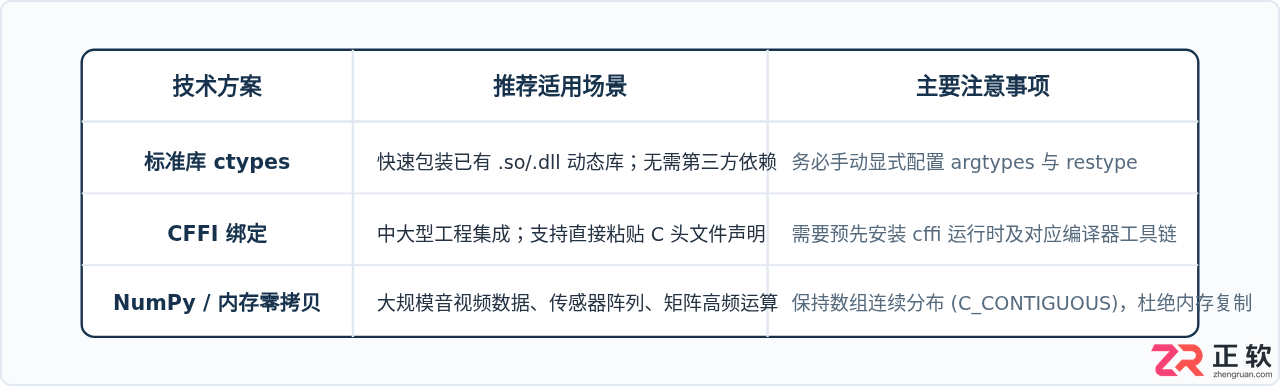
在实际项目中,优先推荐使用标准库 ctypes 或 CFFI:一方面无需编写复杂的 Python C-API 样板代码,另一方面能够最大程度解耦上层逻辑与下层原生编译构件,兼顾开发效率与极致运行性能。
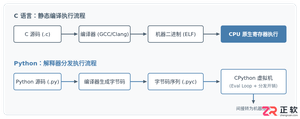
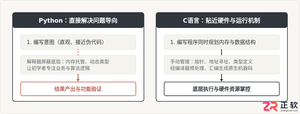
客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。
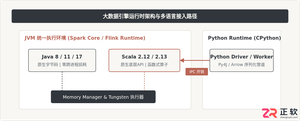
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
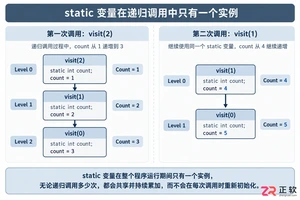
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
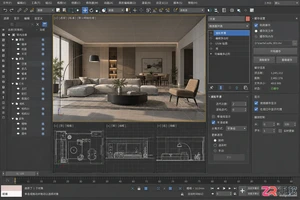
解决3ds Max在处理含有大量修改器的复杂场景时出现的视口卡顿问题。本教程指导用户如何定位高负载修改器,正确启用缓存功能,以及通过冻结对象和临时折叠堆栈来优化操作体验,同时确保数据安全性。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


