

DifFlow3D:场景流估计新SOTA,扩散模型又下一城!
原标题:DifFlow3D:TowardRobustUncertainty-AwareSceneFlowEstimationwithIterativeDiffusion-BasedRefinement论文链接:https://arxiv.org/pdf/2311.17456.pdf代码链接:https://github.com/IRMVLab/DifFlow3D作者单位:上海交通大学剑桥大学浙江大学鉴智机器人论文思路:场景流估计旨在预测动态场景中每个点的3D位移变化,是计算机视觉领域的一个基础任务。然而,
原标题:DifFlow3D: Toward Robust Uncertainty-Aware Scene Flow Estimation with Iterative Diffusion-Based Refinement
论文链接:https://arxiv.org/pdf/2311.17456.pdf
代码链接:https://github.com/IRMVLab/DifFlow3D
作者单位:上海交通大学 剑桥大学 浙江大学 鉴智机器人
论文思路:
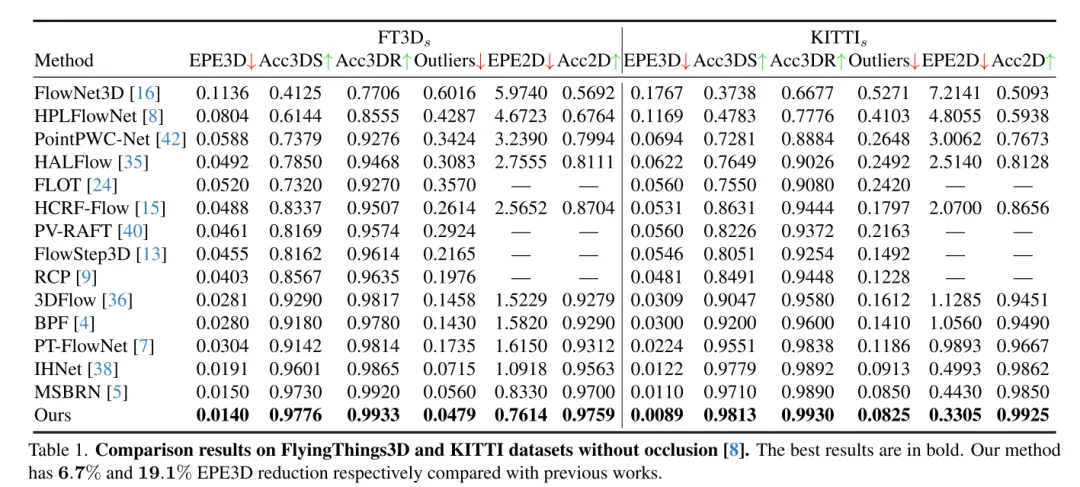
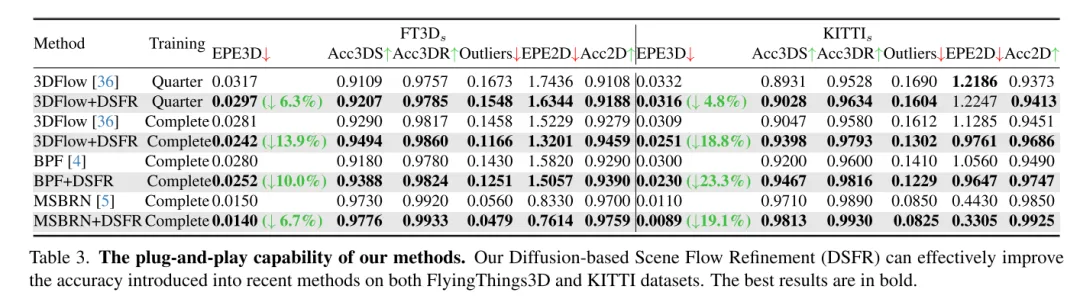
场景流估计旨在预测动态场景中每个点的3D位移变化,是计算机视觉领域的一个基础任务。然而,以往的工作常常受到局部约束搜索范围引起的不可靠相关性的困扰,并且在从粗到细的结构中积累不准确性。为了缓解这些问题,本文提出了一种新颖的不确定性感知场景流估计网络(DifFlow3D),该网络采用了扩散概率模型。设计了迭代扩散式细化(Iterative diffusion-based refinement)来增强相关性的鲁棒性,并对困难情况(例如动态、噪声输入、重复模式等)具有较强的适应性。为了限制生成的多样性,本文的扩散模型中利用了三个关键的与流相关的特征作为条件。此外,本文还在扩散中开发了一个不确定性估计模块,以评估估计场景流的可靠性。本文的 DifFlow3D 在 FlyingThings3D 和 KITTI 2015 数据集上分别实现了6.7%和19.1%的三维端点误差(EPE3D)降低,并在KITTI数据集上实现了前所未有的毫米级精度(EPE3D为0.0089米)。另外,本文的基于扩散的细化范式可以作为一个即插即用的模块,轻松集成到现有的场景流网络中,显著提高它们的估计精度。
主要贡献:
为了实现稳健的场景流估计,本研究提出了一种全新的即插即用型基于扩散的细化流程。据我们所知,这是首次在场景流任务中采用扩散概率模型。
作者结合了粗流嵌入、几何编码和跨帧成本体积等技术,设计了一种有效的条件引导方法,用于控制生成结果的多样性。
为了评估本文中流的可靠性并识别不准确的点匹配,作者还在扩散模型中引入了每个点的不确定性估计。
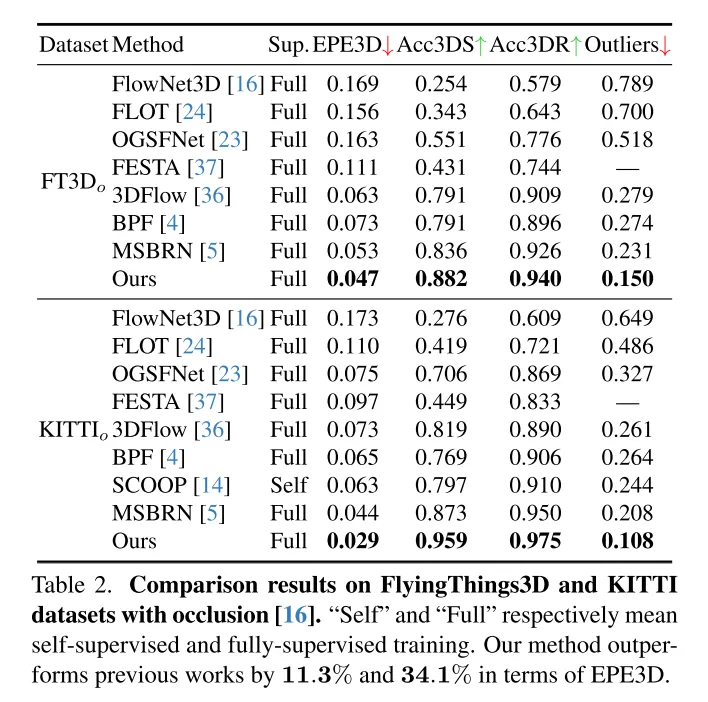
研究结果表明,本文提出的方法在FlyingThings3D和KITTI数据集上表现优异,胜过其他现有方法。特别是,DifFlow3D在KITTI数据集上实现了毫米级的端点误差(EPE3D),这是首次。相较于以往的研究,本文的方法在处理具有挑战性的情况时表现更为鲁棒,如噪声输入和动态变化。
网络设计:
场景流作为计算机视觉中的一项基础任务,指的是从连续的图像或点云中估计出的三维运动场。它为动态场景的低层次感知提供了信息,并且有着各种下游应用,例如自动驾驶[21]、姿态估计[9]和运动分割[1]。早期的工作集中在使用立体[12]或RGB-D图像[10]作为输入。随着3D传感器,例如激光雷达的日益普及,近期的工作通常直接以点云作为输入。
作为开创性的工作,FlowNet3D[16]使用 PointNet++[25] 提取层次化特征,然后迭代回归场景流。PointPWC[42] 通过金字塔、变形和成本体积结构[31]进一步改进了它。HALFlow[35] 跟随它们,并引入了注意力机制以获得更好的流嵌入。然而,这些基于回归的工作通常遭受不可靠的相关性和局部最优问题[17]。原因主要有两个方面:(1)在他们的网络中,使用K最近邻(KNN)来搜索点对应关系,这并不能考虑到正确但距离较远的点对,也存在匹配噪声[7]。(2)另一个潜在问题来自于以往工作[16, 35, 36, 42]中广泛使用的粗到细结构。基本上,最初的流在最粗糙的层上估计,然后在更高分辨率中迭代细化。然而,流细化的性能高度依赖于初始粗流的可靠性,因为后续的细化通常受限于初始化周围的小的空间范围内。
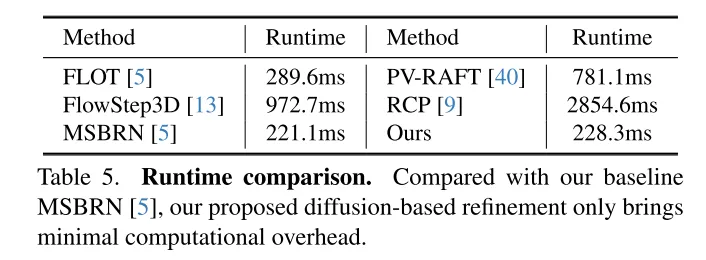
为了解决不可靠性的问题,3DFlow[36] 设计了一个 all-to-all 的点收集模块,并加入了反向验证。类似地,Bi-PointFlowNet[4] 及其扩展MSBRN[5] 提出了一个双向网络,具有前向-后向相关性。IHNet[38] 利用一个带有高分辨率引导和重采样方案的循环网络。然而,这些网络大多因其双向关联或循环迭代而在计算成本上遇到了困难。本文发现扩散模型也可以增强相关性的可靠性和对匹配噪声的韧性,这得益于其去噪本质(如图1所示)。受到[30]中的发现的启发,即注入随机噪声有助于跳出局部最优,本文用概率扩散模型重新构建了确定性流回归任务(deterministic flow regression task),如图2所示。此外,本文的方法可以作为一个即插即用的模块服务于先前的场景流网络,这种方法更为通用,并且几乎不增加计算成本(第4.5节)。
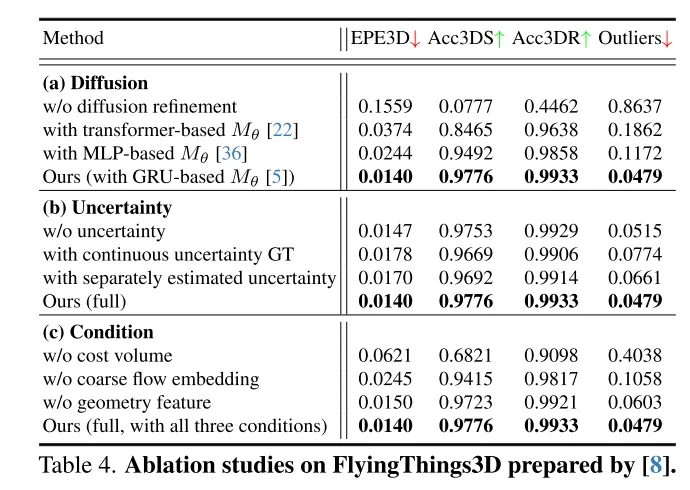
然而,在本文的任务中利用生成模型是相当具有挑战性的,因为扩散模型固有的生成多样性。与需要多样化输出样本的点云生成任务不同,场景流预测是一个确定性任务,它计算精确的每点运动向量。为了解决这个问题,本文利用强条件信息来限制多样性,并有效控制生成的流。具体来说,首先初始化一个粗糙的稀疏场景流,然后通过扩散迭代生成流残差(flow residuals)。在每个基于扩散的细化层中,本文利用粗流嵌入、成本体积和几何编码作为条件。在这种情况下,扩散被应用于实际学习从条件输入到流残差的概率映射。
此外,先前的工作很少探索场景流估计的置信度和可靠性。然而,如图1所示,在噪声、动态变化、小物体和重复模式的情况下,密集流匹配容易出错。因此,了解每个估计的点对应关系是否可靠是非常重要的。受到最近在光流任务中不确定性估计成功的启发[33],本文在扩散模型中提出了逐点不确定性,以评估本文的场景流估计的可靠性。
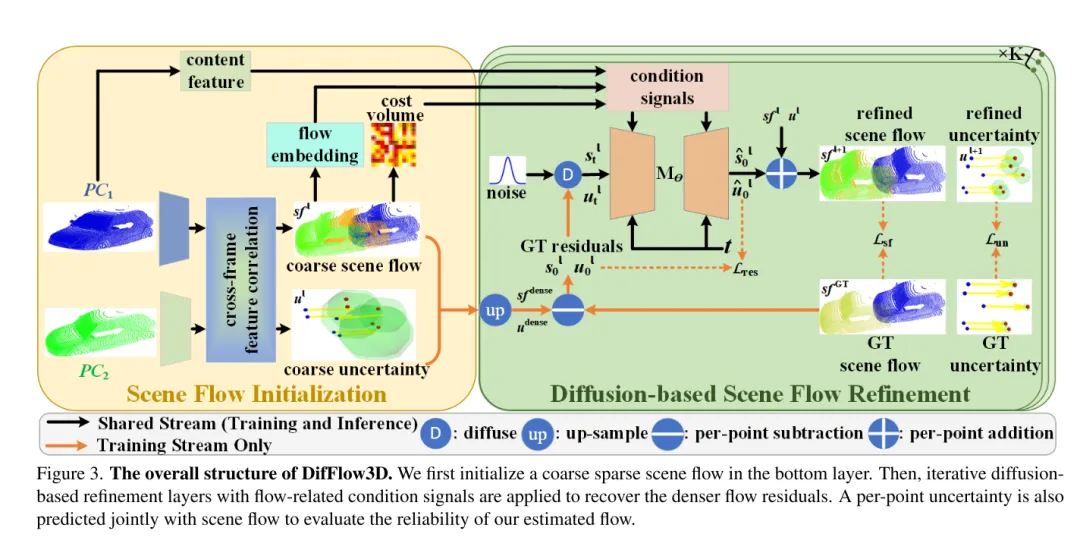
图3。DifFlow3D 的总体结构。本文首先在 bottom layer 初始化一个粗糙的稀疏场景流。随后,将迭代扩散式细化层与流相关的条件信号结合使用,以恢复更密集的流残差。为了评估本文估计的流的可靠性,还将与场景流一起联合预测每个点的不确定性。
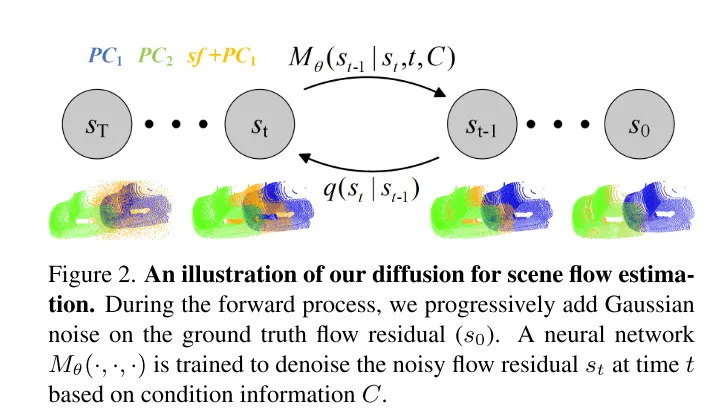
图2。本文用于场景流估计的扩散过程示意图。
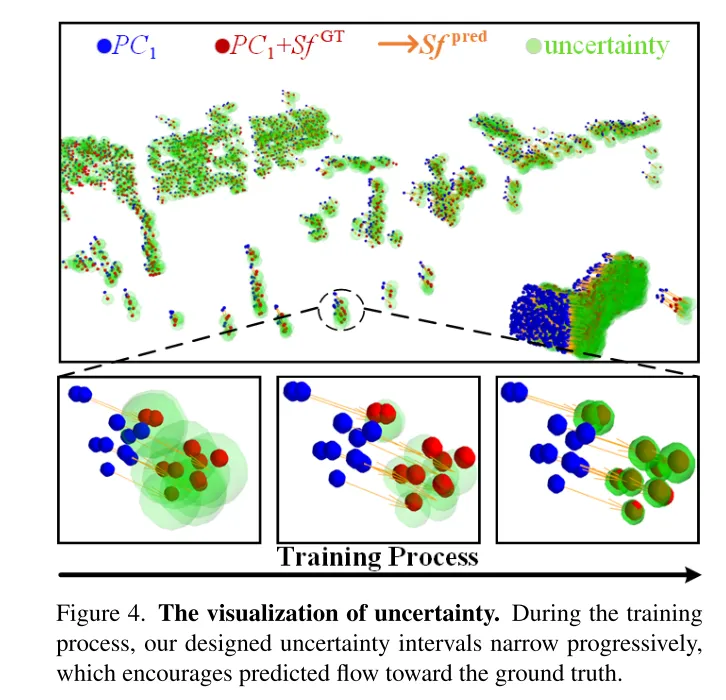
图4。不确定性的可视化。在训练过程中,本文设计的不确定性区间逐渐缩小,这促使预测的流向真实值靠拢。
实验结果:
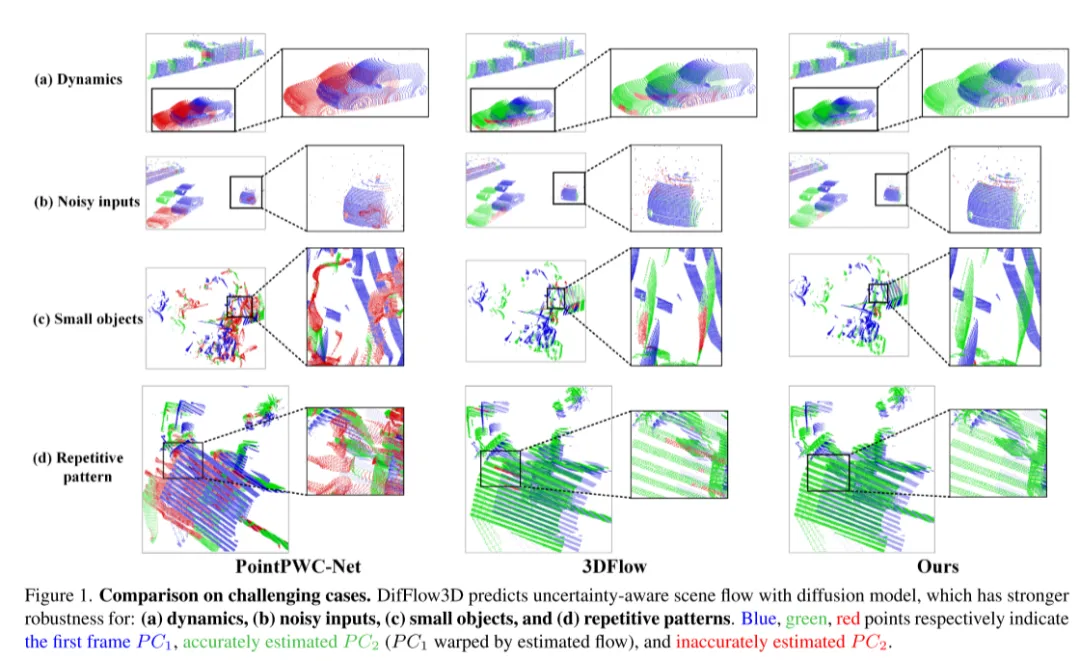
图1。在具有挑战性的情况下的比较。DifFlow3D 使用扩散模型预测具有不确定性感知的场景流,该模型对以下情况具有更强的鲁棒性:(a)动态变化,(b)噪声干扰的输入,(c)小物体,以及(d)重复模式。
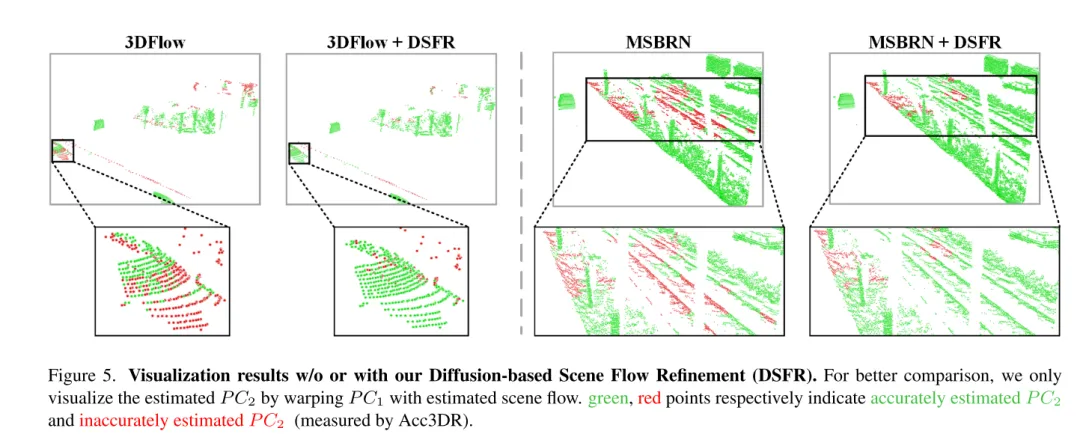
图 5. 未使用或使用基于扩散的场景流细化 (DSFR) 的可视化结果。
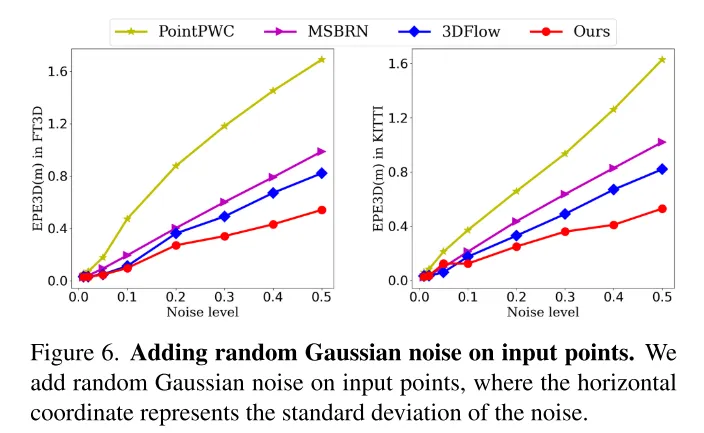
图6。在输入点上添加随机高斯噪声。
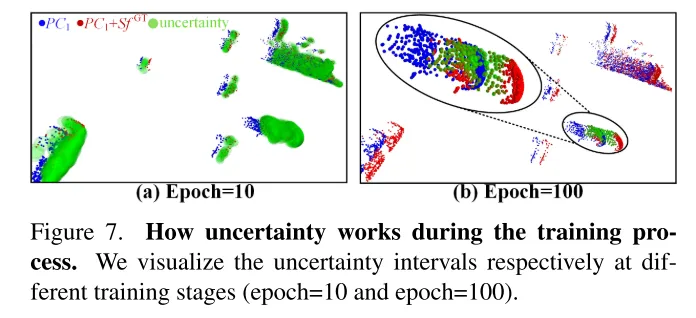
图7。不确定性在训练过程中的作用。本文分别在不同的训练阶段(第10轮和第100轮)可视化了不确定性区间。
总结:
本文创新性地提出了一个基于扩散的场景流细化网络,该网络能够感知估计的不确定性。本文采用多尺度扩散细化来生成细粒度的密集流残差。为了提高估计的鲁棒性,本文还引入了与场景流一起联合生成的逐点不确定性。广泛的实验表明了本文的 DifFlow3D 的优越性和泛化能力。值得注意的是,本文的基于扩散的细化可以作为即插即用模块应用于以往的工作,并为未来的研究提供新的启示。
引用:
Liu J, Wang G, Ye W, et al. DifFlow3D: Toward Robust Uncertainty-Aware Scene Flow Estimation with Diffusion Model[J]. arXiv preprint arXiv:2311.17456, 2023.


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
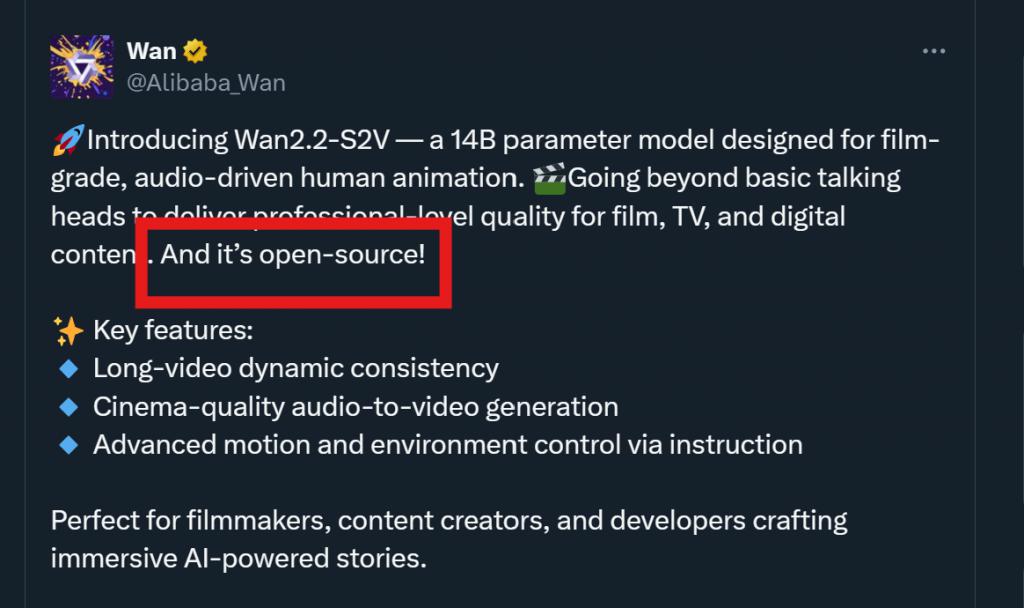
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
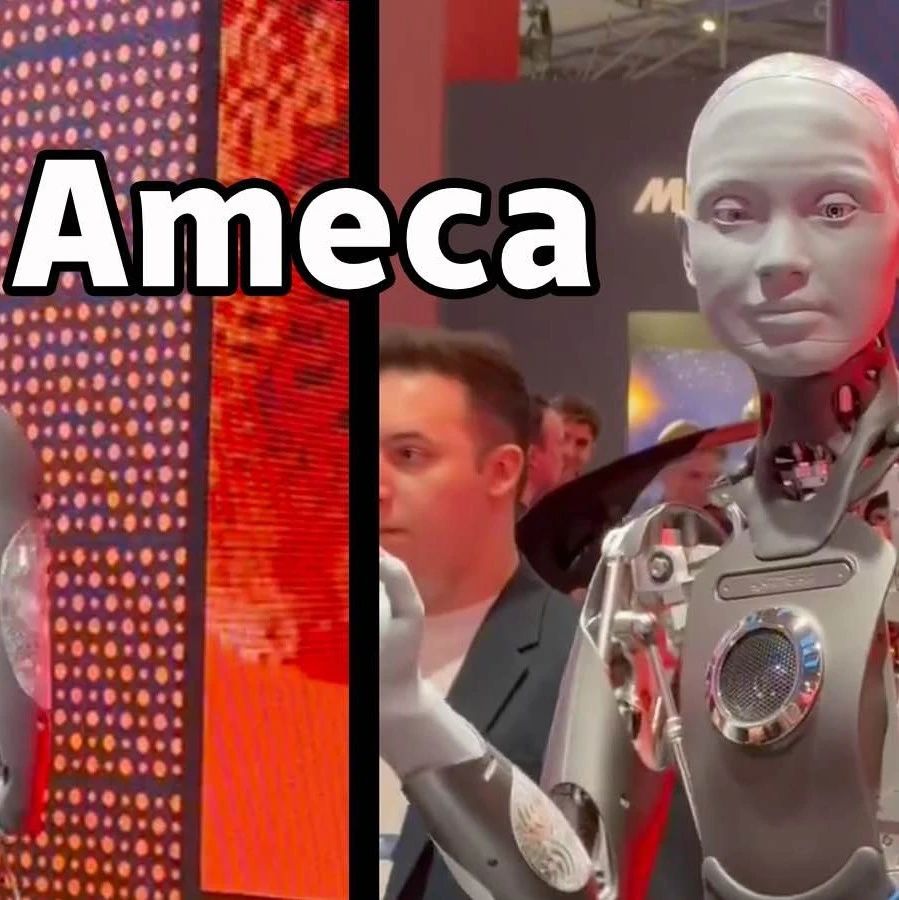
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了
作为一名运维人员,你是否遇到过这种场景?需要用工具测试系统cpu或内存占用高来触发告警,或者通过压测测试服务的并发能力。作为运维工程师,也可以通过这些命令复现故障场景。那么通过本文可以让你掌握常用的测试命令和工具。一、前言在某些情况下,为了定位和复现项目中的问题,必须使用工具进行系统性压力测试,以模拟和还原故障场景。这时测试或压测工具就变得尤为重要。接下来,我们将根据不同的场景来探讨这些工具的使用。二、测试工具2.1网络限速工具tctc是Linux中用于调整网络参数的命令行工具,可用于模拟各种网络条件,包
4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



