

Python中的朴素贝叶斯实例
Python是一种简单易学的编程语言,拥有丰富的科学计算库和数据处理工具。其中,朴素贝叶斯(NaiveBayes)算法作为一种经典的机器学习方法,在Python语言中也拥有广泛的应用。本文将结合实例,介绍Python中朴素贝叶斯的使用方法和步骤。朴素贝叶斯介绍朴素贝叶斯算法是一种基于贝叶斯定理的分类算法,它的核心思想是通过已知训练数据集的特征,来推断新数据
Python是一种简单易学的编程语言,拥有丰富的科学计算库和数据处理工具。其中,朴素贝叶斯(Naive Bayes)算法作为一种经典的机器学习方法,在Python语言中也拥有广泛的应用。本文将结合实例,介绍Python中朴素贝叶斯的使用方法和步骤。
- 朴素贝叶斯介绍
朴素贝叶斯算法是一种基于贝叶斯定理的分类算法,它的核心思想是通过已知训练数据集的特征,来推断新数据的分类结果。在实际应用中,朴素贝叶斯算法常用于文本分类、垃圾邮件过滤、情感分析等场景。
朴素贝叶斯算法的特点在于它假设各个特征之间是互相独立的,这种假设在实际情况中往往不成立,因此朴素贝叶斯算法有“朴素”之称。尽管有这种假设,朴素贝叶斯在短文本分类等问题上的表现仍然很好。
- 使用朴素贝叶斯分类器
在Python中,使用朴素贝叶斯分类器的步骤可以概括为以下几个:
2.1 准备数据
首先需要准备待分类的训练数据和测试数据。这些数据可以是文本、图片、音频等形式,但需要将其转换为能够被计算机理解的形式。在文本分类问题中,通常需要将文本转换为向量表示。
2.2 训练模型
接下来,需要使用训练数据集来构建朴素贝叶斯分类器。Python中常用的朴素贝叶斯分类器有三种:
- GaussianNB:适用于连续数据的分类。
- BernoulliNB:适用于二元数据的分类。
- MultinomialNB:适用于多元数据的分类。
以文本分类为例,可以使用sklearn库提供的TfidfVectorizer类将文本转换为向量表示,并使用MultinomialNB分类器进行训练。
2.3 测试模型
训练完成后,需要使用测试数据集来评估模型的性能。通常情况下,测试数据集和训练数据集是独立的。需要注意的是,在测试过程中不能使用训练数据集中的数据。可以使用sklearn库提供的accuracy_score函数来计算模型的准确率。
- 例子:基于朴素贝叶斯的文本分类
为了演示朴素贝叶斯分类器的实际应用,本文以基于朴素贝叶斯的文本分类为例。
3.1 准备数据
首先,从互联网上找到两个文本数据集,分别为“体育新闻”和“科技新闻”,每个数据集包含1000个文本。将两个数据集放到不同的文件夹中,并将这些文本分别标注为“体育”和“科技”。
3.2 使用sklearn库进行分类
接下来,使用sklearn库提供的朴素贝叶斯分类器进行分类。
(1)导入相关库
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.metrics import accuracy_score
import os
(2)读取文本数据及其标注
def read_files(path):
    text_list = []
    label_list = []
    for root, dirs, files in os.walk(path):
        for file in files:
            file_path = os.path.join(root, file)
            with open(file_path, 'r', encoding='utf-8') as f:
                text = ''.join(f.readlines())
                text_list.append(text)
                if '体育' in file_path:
                    label_list.append('体育')
                elif '科技' in file_path:
                    label_list.append('科技')
    return text_list, label_list
(3)将文本转换为向量表示
def text_vectorizer(text_list):
    vectorizer = TfidfVectorizer()
    X = vectorizer.fit_transform(text_list)
    return X, vectorizer
(4)训练模型并返回准确率
def train(text_list, label_list):
    X, vectorizer = text_vectorizer(text_list)
    y = label_list
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    clf = MultinomialNB()
    clf.fit(X_train, y_train)
    y_pred = clf.predict(X_test)
    acc = accuracy_score(y_test, y_pred)
    return clf, vectorizer, acc
(5)测试模型
def predict(clf, vectorizer, text):
    X = vectorizer.transform(text)
    y_pred = clf.predict(X)
    return y_pred[0]
3.3 结果分析
运行上述代码,可以得到分类器的准确率为0.955。在进行实际分类时,只需要将待分类文本输入predict函数,即可返回其所属类别。例如,输入一条文本“iPhone 12终于发布了!”即可返回“科技”类别。
- 总结
朴素贝叶斯算法作为一种简单而有效的分类算法,在Python中也有着广泛的应用。本文介绍了朴素贝叶斯分类器的使用方法和步骤,并以基于朴素贝叶斯的文本分类为例,演示了分类器的实际应用。在实际应用过程中,还需要对数据进行预处理、特征选择等操作,以提高分类器的准确率。
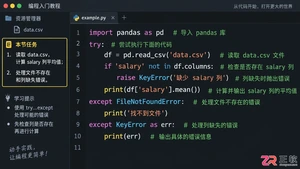
针对编程新手,详解如何使用Codex进行代码生成。从API接入到提示词优化,通过具体场景展示如何将自然语言转化为高质量代码,并指出其适用边界与注意事项。
图异常检测模型构建的核心在于通过图自编码器(GAE)学习正常图结构并识别异常,具体步骤如下:1.数据准备,将图数据转化为PyTorchGeometric的Data对象;2.构建GAE模型,包括GCN编码器和解码器;3.训练模型,使用BCE损失最小化重构误差;4.异常评分与检测,依据重构误差评估边或节点的异常性。图结构的重要性在于其能提供节点间的关系上下文,使模型能识别连接模式、局部结构或信息流的异常。PyTorchGeometric的优势包括与PyTorch无缝集成、高效处理稀疏图数据、丰富的GNN模块以
使用Scapy制作网络拓扑扫描的核心是结合ARP扫描和ICMPtraceroute技术,先通过ARP请求发现局域网内活跃设备,再利用TTL递增的ICMP包探测外部路径;2.Scapy的优势在于可自定义构造和解析任意协议层数据包,支持灵活探测、流量嗅探及多协议组合,适用于复杂网络环境;3.实际扫描中常见挑战包括防火墙拦截、权限不足、扫描效率低以及结果不完整,需采用多种扫描策略、控制速率并确保合法授权;4.构建可视化拓扑图需整合扫描数据为节点与边,利用NetworkX、Pyvis或Graphviz等工具生成交
构建智能写作助手的核心是利用Python和GPT-2对特定领域数据进行微调,使通才模型变为专精专家;2.首先需收集并清洗高质量、风格匹配的文本数据,去除HTML标签、重复内容等噪音,确保数据“干净”;3.使用HuggingFace的transformers库加载GPT-2模型,并配置GPU环境以支持高效训练;4.微调过程中需调整学习率、批次大小、训练轮数等参数,平衡欠拟合与过拟合,提升模型在目标风格上的表达能力;5.文本生成后通过定性评估判断流畅性、连贯性和风格契合度,辅以困惑度等定量指标参考;6.根据评
主流且高效的Python图像背景去除方式是使用rembg库,它基于深度学习模型实现前景与背景的智能分离;2.安装命令为pipinstallrembg[gpu](支持GPU加速)或pipinstallrembg(CPU版本);3.使用时通过fromrembgimportremove读取图片字节并调用remove()函数即可生成透明背景图像;4.rembg底层采用U-Net等预训练模型进行像素级语义分割,输出alpha蒙版实现精准抠图;5.面对颜色相近、透明物体、复杂边缘等挑战,可采取更换模型、图像预处理、启
StopIteration是Python迭代结束的正常信号,由next()或for循环触发以终止迭代。在自定义生成器中应避免手动抛出StopIteration,而让函数自然返回;使用yieldfrom时,显式抛出会提前终止迭代。直接调用next()需捕获StopIteration或提供默认值,如next(it,None)。自Python3.3起,生成器return值会内部转换为StopIteration(value),供yieldfrom捕获处理,无需手动干预。正确理解该机制可提升代码健壮性。
列表推导式本质是语法糖,编译时被“解糖”为等价for循环结构;2.核心优化在于使用LIST_APPEND字节码指令,避免方法查找开销,提升执行效率;3.通过dis模块可反汇编字节码,直观看到BUILD_LIST、FOR_ITER、LIST_APPEND等指令实现循环与条件逻辑,从而理解其底层高效机制。
Luigi在处理大规模数据管道时的独特优势包括:基于Python原生开发,便于复用现有代码和库,提升开发效率;2.具备强大的依赖管理和容错机制,通过Target判断任务完成状态,实现幂等性,避免重复执行,支持中断后从失败点恢复;3.提供可视化WebUI,直观展示任务依赖关系和执行状态,便于监控和调试复杂流程;4.支持灵活的参数化设计,使同一任务可适应不同输入和场景,提升管道的可复用性和可配置性。
在Python脚本中调用另一个Python脚本,推荐使用subprocess.run()方法,因为它安全、功能强大且能捕获输出和错误;os.system()虽简单但存在安全风险且无法获取输出;subprocess.Popen()支持异步执行但使用复杂;exec()和eval()不推荐因会污染命名空间;参数通过命令行列表传递并在被调用脚本中用sys.argv接收;返回值可通过print输出并由调用脚本捕获标准输出实现;异常处理依赖检查子进程的returncode和stderr,结合check=True可自动
FastAPI是构建高性能RESTAPI的首选Python框架,1.它基于类型提示和依赖注入实现代码清晰与自动文档生成;2.通过Pydantic模型验证请求体数据;3.利用依赖注入系统复用公共逻辑;4.支持APIKey、OAuth2等身份验证机制;5.可集成SQLAlchemy等ORM进行数据库操作;6.使用TestClient配合pytest完成单元测试;7.可通过Docker容器化并部署到云平台。该框架兼具高性能与开发效率,适用于现代API开发全流程,从定义路由到部署均提供完整解决方案。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



