

贾佳亚团队联手剑桥清华等共推评测新范式 一秒侦破大模型“高分低能”
颠覆过往大模型评测标准,最新、最全、最权威的测评数据集MR-Ben来了!这是继今年4月发布堪称GPT-4+DALL-E-3的王炸产品超强视觉语言模型Mini-Gemini后,港中文贾佳亚团队再次提出的极具代表性的作品。在MR-Ben的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。MR-Ben细致地评测了不少国内外一线的开源和闭源模型,如GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、
这是继今年 4 月发布堪称 GPT-4 + DALL-E-3 的王炸产品超强视觉语言模型 Mini-Gemini 后,港中文贾佳亚团队再次提出的极具代表性的作品。在 MR-Ben 的“监督”下,大模型不仅要像学生那样会答题,还要像老师那样会阅卷,真实的推理能力无所遁形。
MR-Ben 细致地评测了不少国内外一线的开源和闭源模型,如 GPT4-Turbo、Cluade3.5-Sonnet、Mistral-Large、Zhipu-GLM4、Moonshot-v1、Yi-Large、Qwen2-70B、Deepseek-V2 等,并进行了详尽的分析。
哪些看似美丽的大模型会被“卸妆”,哪个模型地表最强?目前该工作所有代码和数据均已开源,一起来看看!
Project Page: https://randolph-zeng.github.io/Mr-Ben.github.io/
Arxiv Page: https://arxiv.org/abs/2406.13975
Github Repo: https://github.com/dvlab-research/Mr-Ben
MR-Ben 秒破大模型“高分低能”
人工智能领域进入 GPT 时刻后,学术界和产业界共同发力,每月甚至每周都有新的模型问世。
大模型层出不穷,用什么标准来衡量大模型的具体能力?目前的主流方向是使用人类的标准化考试——选择题和填空题的方式去进行大模型评测。使用这套测试方式的好处有很多, 简单来说可以分为以下几点:
• 标准化考试易于量化和评测,标准明确,对就是对错就是错。
• 指标直观,在国内高考或者美国高考 SAT 里取得怎么样的分数易于比较和理解。
• 量化结果天然具有话题性(如 GPT4 轻松通过美国律师认证资格考试极为吸引眼球)。
但如果深究大模型的训练方式,就会发现这种逐步作答的思维链方式生成最终答案,并不“靠谱”。
问题正是出现在分步作答的流程上!
预训练模型在预训练时早已见过数以万亿级别的词元,很难说被评测的模型是否早已见过相应的数据,从而通过“背题”的方式回答正确。而在分步作答的时候,模型是否是基于正确的理解推理选出正确的选项,我们不得而知,因为评测的方式主要靠检查最终的答案。
尽管学术界不断地对诸如 GSM8K、MMLU 等数据集进行升级改造,如在 GSM8K 上引入多语言版本的 MGSM 数据集,在 MMLU 的基础上引入更难的题目等,依然无法摆脱选择或填空的窠臼。
并且,这些数据集都已面临着严重的饱和问题,大语言模型在这些指标上的数值已经见顶,并逐渐丧失了区分度。
为此,贾佳亚团队联合 MIT、清华、剑桥等多家知名高校,与国内头部标注公司合作,标注了一个针对复杂问题推理过程的评测数据集 MR-Ben。
MR-Ben 基于 GSM8K、MMLU、LogiQA、MHPP 等大模型预训练必测数据集的题目,进行了“阅卷式”的范式改造,生成的新数据集更难、更有区分度,更能真实地反映模型推理能力!
而贾佳亚团队这次的工作还针对现存评测痛点进行了针对性的改进:
不是害怕数据泄露导致的大模型背题导致分数虚高吗?不用重新找题出卷,也不用把题目变形来测试模型的稳健性,MR-Ben 直接让模型从答题者的学生身份,转变为对答题过程的“阅卷”模式,让大模型当老师来测试它对知识点的掌握情况!
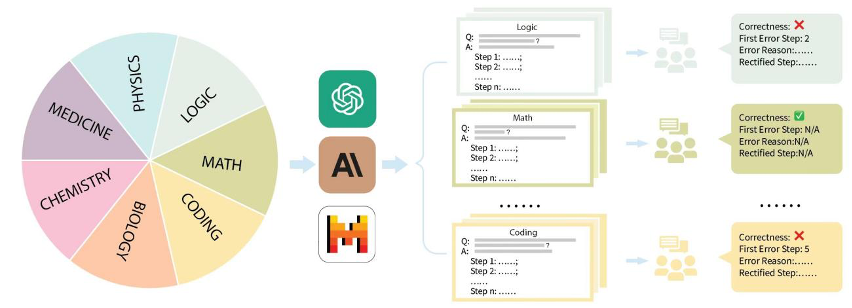
不是担心模型对解题过程毫无知觉,有可能出现“幻觉”或错误的理解,蒙对答案吗?MR-Ben 直接招聘一批高水平的硕博标注者,对大量题目的解题过程进行精心标注。把解题过程是否正确,出错的位置,出错的原因都细致指出,比对大模型的阅卷结果和人类专家的阅卷结果来测试模型的知识点掌握情况。
具体来说,贾佳亚团队针对市面上主流的评测数据集 GSM8K、MMLU、LogiQA、MHPP 等数据集进行整理,并分成了数理化生、代码、逻辑、医药等多个类别,同时区分了不同的难度等级。针对每个类别、收集到的每个问题,团队精心收集了对应的分步解题过程,并经由专业的硕博标注者进行培训和标注。
表现最佳大模型是它?
接下来,让我们结合MR-Ben工作中给出的具体例子,看看为什么说逐步作答生成最终答案的方式和相关评测不靠谱。
作为被评测的“阅卷”模型,GPT4-Turbo并未发现第二步所隐藏的计算错误:
E.1 数学
科目:高中数学
问题:哪个最小的整数被4除余1,被3除余2,被5除余2?
选项:[A] 67 [B] 43 [C] 57 [D] 37
答案:D
采样模型:Claude2
模型解答步骤:
- 步骤1:检查选项A(67)当67除以4,余数是3,不是1。所以67不是正确答案。
- 步骤2:检查选项B(43)当43除以4,余数是1。当43除以3,余数是3,不是2。所以43不是正确答案。
- 步骤3:检查选项C(57)当57除以4,余数是1。当57除以3,余数是0,不是2。所以57不是正确答案。
- 步骤4:检查选项D(37)当37除以4,余数是1。当37除以3,余数是1。当37除以5,余数是2。
步骤5:选项D(37)满足所有条件,是正确答案。
解答:选项D
人工注解
模型解答正确性:不正确
首次错误步骤:步骤2
模型解答错误原因:
在步骤2中,模型错误计算了43除以4的余数为1而不是3。模型假设当43除以4时余数是1,但余数应该是3。这里有一个计算错误。修正后的首个正确步骤:步骤2
当43除以4,余数是1。当43除以3,余数是1。当43除以5,余数是3,不是2。因此,43不是正确答案。
评测模型:gpt-4-turbo
模型回复:
-步骤1:步骤检查67除以4和3的余数,发现它符合被4除余3的条件,这是一个正确的验证。
-步骤2:检查43除以4、3、5的余数,发现1、3、5的余数正确匹配预期,除了5的余数不符合条件。
-步骤3:步骤计算57除以4和3的余数,余数分别是1和0。当57除以3时余数不符合条件。
-步骤4:步骤检查并验证37除以4、3、5的余数,发现所有预期的余数都准确,得出37满足题目中的所有条件。解答过程是否正确:正确
第一个出错的步骤:不适用
第一个出错步骤的原因:不适用
可以看到,当给定问题、确定的解答过程,评测语言模型的方式就转换成了让模型对解答过程进行“阅卷”并评判正误、指出错误位置及原因。其中解答过程的正误,潜在的出错位置可以通过与标注结果进行比对来计算。而模型出错步骤和原因的评测,则可以交由GPT4,通过比较标注人员给出的错误原因解释和模型的错误原因解释,来判断模型是否正确。
从评测方式来看,MR-Ben所提出的方法需要模型对于解题过程的每一个步骤的前提、假设、逻辑都进行细致分析,并对推理过程进行预演来判断当前步骤是否能导向正确答案。fenye1. 这种“阅卷”式的评测方式从难度上远超于仅答题的评测方式,但可有效避免模型背题所导致的分数虚高问题。而只会背题的学生很难成为一名合格的阅卷老师。
- 其次,MR-Ben通过使用了人力精细的标注流程控制,取得了大量的高质量标注,而巧妙的流程设计又使得评测方式能够直观地量化。
- 贾佳亚团队还针对性测试了时下最具代表性的十大大语言模型和不同版本。可以看到,闭源大语言模型里,GPT4-Turbo的表现最佳(虽然在“阅卷”时未能发现计算错误),在绝大部分的科目里,有demo(k=1)和无demo(k=0)的设置下都领先于其他模型。
**部分开源大语言模型在MR-Ben数据集上的测评结果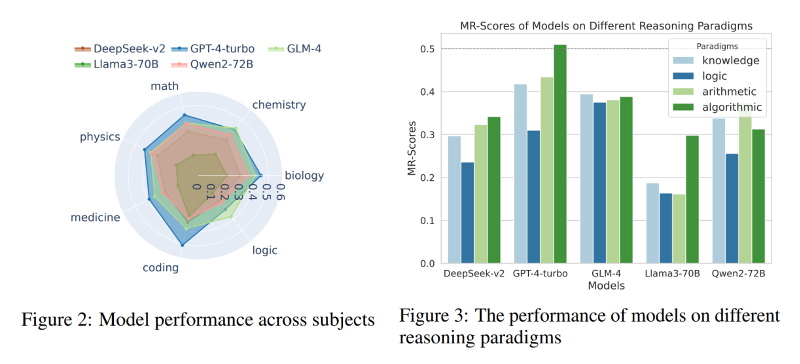
可以看到,最强的部分开源大语言模型效果已经赶上了部分商用模型,并且哪怕最强的闭源模型在MR-Ben数据集上表现也仍未饱和,不同模型间的区分度较大。
除此之外,MR-Ben的原论文里还有更多有意思的解析和发现,例如:
Qwen和Deepseek发布的开源模型哪怕在全球梯队里,PK闭源模型效果也不逊色。
不同的闭源模型定价策略和实际表现耐人寻味。在使用场景里关注推理能力的小伙伴,可以对照价格和能力找到自己心仪的模型去使用。
低资源场景下,小模型也有不少亮点,MR-Ben评测中Phi-3-mini在一众小模型里脱颖而出,甚至高于或持平几百亿参数的大模型,展现出了微调数据的重要性。
MR-Ben场景包含复杂的逻辑解析和逐步推断,Few-shot模式下过长的上下文反而会使得模型困惑,造成水平下降的后果。
MR-Ben评测了不少生成-反思-重生成的消融实验,查看不同提示策略的差异,发现对低水平的模型没有效果,对高水平的模型如GPT4-Turbo效果也不明显。反而对中间水平的模型因为总把错的改对,对的改错,效果反而略有提升。
将MR-Ben评测的科目粗略划分成知识型、逻辑型、计算型、算法型后,不同的模型在不同的推理类型上各有优劣。
贾佳亚团队已在github上传一键评测的方式,欢迎所有关注复杂推理的小伙伴在自家的模型上评测并提交,团队会及时更新相应的leaderboard。
对了,使用官方的脚本一键评测,只需花费12M tokens左右,过程非常丝滑,不妨一试!
参考
Training Verifiers to Solve Math Word Problems(https://arxiv.org/abs/2110.14168)
Measuring Massive Multitask Language Understanding(https://arxiv.org/abs/2009.03300)
LogiQA: A Challenge Dataset for Machine Reading Comprehension with Logical Reasoning(https://arxiv.org/abs/2007.08124)
MHPP: Exploring the Capabilities and Limitations of Language Models Beyond Basic Code Generation(https://arxiv.org/abs/2405.11430)
Sparks of Artificial General Intelligence: Early experiments with GPT-4(https://arxiv.org/abs/2303.12712)
Qwen Technical Report(https://arxiv.org/abs/2309.16609)
DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(https://arxiv.org/abs/2405.04434)
Textbooks Are All You Need(https://arxiv.org/abs/2306.11644)
Large Language Models Cannot Self-Correct Reasoning Yet(https://arxiv.org/abs/2310.01798)


比特现金(BCH)的未来发展前景看好。凭借其可扩展性、支付采用、价值存储、智能合约和坚实的社区支持,比特现金有望在多个领域取得显著发展,成为一种多功能且广泛使用的加密货币。

ACH 总共发行了 10 亿枚,用于支付网关费用、治理投票和质押奖励。ACH 基于 BEP-20 标准,采用 PoS 机制,可通过私募、公募和生态系统分配获取,其价值受服务需求、实用性和市场趋势影响,可在币安、火币等交易所购买。

Coinbase Pro 设置步骤:下载并安装软件后,打开并登录,点击右上角齿轮图标进入“首选项”。在首选项中,你可以调整界面、安全、通知、交易和API设置,完成后点击“保存”按钮确认更改。

IoTeX、DePHY和peaq是构建物联网生态系统的关键基础设施。IoTeX提供去中心化网络,确保物联网交易和数据的安全性。DePHY利用区块链技术实现频谱共享和自治管理。peaq促进设备间的数据标准化和共享。通过这些基础设施的协同作用,物联网生态系统实现了去中心化、安全、互操作性和自治,充分释放了物联网的潜力。









Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
