

探索使用对比损失的孪生网络进行图像相似性比较
简介在计算机视觉领域,准确地测量图像相似性是一项关键任务,具有广泛的实际应用。从图像搜索引擎到人脸识别系统和基于内容的推荐系统,有效比较和查找相似图像的能力非常重要。Siamese网络与对比损失结合,为数据驱动方式学习图像相似性提供了强大的框架。在这篇博文中,我们将深入了解Siamese网络的细节,探讨对比损失的概念,并探讨这两个组件如何共同工作以创建一个有效的图像相似性模型。首先,Siamese网络由两个相同的子网络组成,这两个子网络共享相同的权重和参数。每个子网络将输入图像编码为特征向量,这些向量捕捉
简介
在计算机视觉领域,准确地测量图像相似性是一项关键任务,具有广泛的实际应用。从图像搜索引擎到人脸识别系统和基于内容的推荐系统,有效比较和查找相似图像的能力非常重要。Siamese网络与对比损失结合,为数据驱动方式学习图像相似性提供了强大的框架。 在这篇博文中,我们将深入了解Siamese网络的细节,探讨对比损失的概念,并探讨这两个组件如何共同工作以创建一个有效的图像相似性模型。 首先,Siamese网络由两个相同的子网络组成,这两个子网络共享相同的权重和参数。每个子网络将输入图像编码为特征向量,这些向量捕捉了图像的关键特征。 然后,我们使用对比损失来度量两个输入图像之间的相似性。对比损失基于欧氏距离度量,并采用了一个限制项,以确保同类样本之间的距离小于不同类样本之间的距离。 通过反向传播和优化算法,Siamese网络能够自动学习特征表示,使得相似图像的能力非常重要。这种模型的创新之处在于它能够在训练集中学习相对较少的样本,并通过迁移学习将

Siamese神经网络是一类既在比较和测量输入样本对之间相似性的神经网络架构。术语“Siamese”来源于网络体系结构包含两个相同结构且共享相同权重集的孪生神经网络的概念。每个网络处理来自对应的输入样本之一,并通过比较它们的输出来确定它们之间的相似性或不相似性。 在Siamese网络中的每个样本处理来自对应输入样本的输入样本之间的相似性或不相似性。这种相似性度量可以通过比较它们的输出结果来确定。Siamese网络通常用于识别和验证任务,如人脸识别、指纹识别和签名验证等。它可以自动学习输入样本之间的相似性,并根据训练数据进行决策。 通过Siamese网络,每个网络处理来自对应的输入样本之一,并通过比较它们的输出来确定它们之间的相似性或者不相

什么是Siamese神经网络

Siamese网络的主要动机是学习输入样本的有意义的表 示,以捕捉它们的相似性比较所需的基本特征。这些网络在直接使用标记示例进行训练有限或困难 的任务中表现出色,因为它们可以学会划分相似和不相似的实例,而无需显示类别标签。Siamese网络的架构通常包括三个主要组件:共享网络、相似度度量和对比损失函数。 共享网络通常由卷积和全连接层组成,用于从输入中提取特征表示。它们可以是经过预训练的网络,如VGG、ResNet等,也可以是从头开始训练的网络。 相似度度量模块用于计算两个输入样本之间的相似度或距离。常用的度量方法包括欧氏距离、余弦相似度等。 对比损失函数用于衡量两个输入样本之间的相似性或差异性。常用的损失函数是对比损失,它通过最小化相似样本之间的距离和最大化不相
- 共享网络:共享网络是Siamese架构的核心组件。它负责从输入样本中提取有意义的特征表示。共享网络包含神经单元的层,例如卷积层或全连接层,用于处理输入数据并生成固定长度的embedding向量。通过在孪生网络之间共享相同的权重,模型学会为相似的输入提取相似的特征,从而实现有效的比较。
- 相似性度:一旦输入由共享网络处理,就会使用相似性度量来比较生成的embedding,并测量两个输入之间的相似性或不相似性。相似度度量的选择取决于特定任务和输入数据的性质。常见的相似性度量包括欧氏距离、余弦相似度或相关系数。相似性度量量化了embedding之间的距离或相关性,并提供了输入样本之间相似性的度量。
- 对比损失函数:为了训练Siamese网络,采用了对比损失函数。对比损失函数鼓励网络为相似的输入生成距离更近的embedding,而为不相似的输入生成距离更远的embedding。当相似对之间的距离超过一定阈值或不相似对之间的距离低于另一个阈值时,对比损失函数对模型进行惩罚。对比损失函数的确切制定取决于所选的相似性度量和相似对与不相似对之间的期望边际。
在训练过程中,Siamese网络学会优化其参数以最小化对比损失,并生成能够有效捕捉输入数据的相似性结构的判别性embedding。
对比损失函数
对比损失是Siamese网络中常用于学习输入样本对之间相似性或不相似性的损失函数。它旨在以这样一种方式优化网络的参数,即相似的输入具有在特征空间中更接近的embedding,而不相似的输入则被推到更远的位置。通过最小化对比损失,网络学会生成能够有效捕捉输入数据的相似性结构的embedding。
为了详细了解对比损失函数,让我们将其分解为其关键组件和步骤:
- 输入对:对比损失函数作用于输入样本对,其中每对包含一个相似或正例和一个不相似或负例。这些对通常在训练过程中生成,其中正例对代表相似实例,而负例对代表不相似实例。
- embedding:Siamese网络通过共享网络处理每个输入样本,为配对中的两个样本生成embedding向量。这些embedding是固定长度的表示,捕捉输入样本的基本特征。
- 距离度量:使用距离度量,如欧氏距离或余弦相似度,来衡量生成的embedding之间的不相似性或相似性。距离度量的选择取决于输入数据的性质和任务的具体要求。
- 对比损失计算:对比损失函数计算每对embedding的损失,鼓励相似对具有更小的距离,而不相似对具有更大的距离。对比损失的一般公式如下:L = (1 — y) * D² + y * max(0, m — D)
其中:
- L:对于一对的对比损失。
- D:embedding之间的距离或不相似性。
- y:标签,指示配对是否相似(相似为0,不相似为1)。
- m:定义不相似性阈值的边际参数。
损失项 `(1 — y) * D²` 对相似对进行惩罚,如果它们的距离超过边际(m),则鼓励网络减小它们的距离。项 `y * max(0, m — D)²` 对不相似对进行惩罚,如果它们的距离低于边际,则推动网络增加它们的距离。
- 损失的汇总:为了获得整个输入对批次的整体对比损失,通常会对所有对之间的个体损失进行平均或求和。汇总方法的选择取决于特定的训练目标和优化策略。
通过通过梯度下降优化方法(例如反向传播和随机梯度下降)最小化对比损失,Siamese网络学会生成能够有效捕捉输入数据的相似性结构的判别性embedding。对比损失函数在训练Siamese网络中发挥着关键作用,使其能够学习可用于各种任务,如图像相似性、人脸验证和文本相似性的有意义表示。对比损失函数的具体制定和参数可以根据数据的特性和任务的要求进行调整。
在 PyTorch 中的孪生神经网络

1. 数据集创建
我们使用的数据集来自来自 :
http://vision.stanford.edu/aditya86/ImageNetDogs/
def copy_files(source_folder,files_list,des):for file in files_list:source_file=os.path.join(source_folder,file)des_file=os.path.join(des,file)shutil.copy2(source_file,des_file)print(f"Copied {file} to {des}")return def move_files(source_folder,des):files_list=os.listdir(source_folder)for file in files_list:source_file=os.path.join(source_folder,file)des_file=os.path.join(des,file)shutil.move(source_file,des_file)print(f"Copied {file} to {des}")return def rename_file(file_path,new_name):directory=os.path.dirname(file_path)new_file_path=os.path.join(directory,new_name)os.rename(file_path,new_file_path)print(f"File renamed to {new_file_path}")returnfolder_path=r"C:\Users\sri.karan\Downloads\images1\Images\*"op_path_similar=r"C:\Users\sri.karan\Downloads\images1\Images\similar_all_images"tmp=r"C:\Users\sri.karan\Downloads\images1\Images\tmp"op_path_dissimilar=r"C:\Users\sri.karan\Downloads\images1\Images\dissimilar_all_images"folders_list=glob.glob(folder_path)folders_list=list(set(folders_list).difference(set(['C:\\Users\\sri.karan\\Downloads\\images1\\Images\\similar_all_images','C:\\Users\\sri.karan\\Downloads\\images1\\Images\\tmp','C:\\Users\\sri.karan\\Downloads\\images1\\Images\\dissimilar_all_images'])))l,g=0,0random.shuffle(folders_list)for i in glob.glob(folder_path):if i in ['C:\\Users\\sri.karan\\Downloads\\images1\\Images\\similar_all_images','C:\\Users\\sri.karan\\Downloads\\images1\\Images\\tmp','C:\\Users\\sri.karan\\Downloads\\images1\\Images\\dissimilar_all_images']:continuefile_name=i.split('\\')[-1].split("-")[1]picked_files=pick_random_files(i,6)copy_files(i,picked_files,tmp)for m in range(3):rename_file(os.path.join(tmp,picked_files[m*2]),"similar_"+str(g)+"_first.jpg")rename_file(os.path.join(tmp,picked_files[m*2+1]),"similar_"+str(g)+"_second.jpg")g+=1move_files(tmp,op_path_similar)choice_one,choice_two=random.choice(range(len(folders_list))),random.choice(range(len(folders_list)))picked_dissimilar_one=pick_random_files(folders_list[choice_one],3)picked_dissimilar_two=pick_random_files(folders_list[choice_two],3)copy_files(folders_list[choice_one],picked_dissimilar_one,tmp)copy_files(folders_list[choice_two],picked_dissimilar_two,tmp)picked_files_dissimilar=picked_dissimilar_one+picked_dissimilar_twofor m in range(3):rename_file(os.path.join(tmp,picked_files_dissimilar[m]),"dissimilar_"+str(l)+"_first.jpg")rename_file(os.path.join(tmp,picked_files_dissimilar[m+3]),"dissimilar_"+str(l)+"_second.jpg")l+=1move_files(tmp,op_path_dissimilar)我们挑选了3对相似图像(狗品种)和3对不相似图像(狗品种)来微调模型,为了使负样本简单,对于给定的锚定图像(狗品种),任何除地面实况狗品种以外的其他狗品种都被视为负标签。
注意: “相似图像” 意味着来自相同狗品种的图像被视为正对,而“不相似图像” 意味着来自不同狗品种的图像被视为负对。
代码解释:
- 46行:从每个狗图像文件夹中随机挑选了6张图像。
- 47行:选择的图像被移动到一个名为 “tmp” 的文件夹中,并且由于它们来自同一狗品种文件夹,因此被重命名为 “similar_images”。
- 55行:完成所有这些后,它们被移动到 “similar_all_images” 文件夹中。
- 56、57行:类似地,为了获得不相似的图像对,从两个不同的狗品种文件夹中选择了3张图像。
- 然后重复上述流程,以获得不相似的图像对并将它们移动到 “dissimilar_all_images” 文件夹中。
完成所有这些后,我们可以继续创建数据集对象。
import torchimport torch.nn as nnimport torch.optim as optimfrom torch.utils.data import DataLoaderfrom PIL import Imageimport numpy as npimport randomfrom torch.utils.data import DataLoader, Datasetimport torchimport torch.nn as nnfrom torch import optimimport torch.nn.functional as Fclass ImagePairDataset(torch.utils.data.Dataset):def __init__(self, root_dir):self.root_dir = root_dirself.transform = T.Compose([# We first resize the input image to 256x256 and then we take center crop.transforms.Resize((256,256)), transforms.ToTensor()])self.image_pairs = self.load_image_pairs()def __len__(self):return len(self.image_pairs)def __getitem__(self, idx):image1_path, image2_path, label = self.image_pairs[idx]image1 = Image.open(image1_path).convert("RGB")image2 = Image.open(image2_path).convert("RGB")# Convert the tensor to a PIL image# image1 = functional.to_pil_image(image1)# image2 = functional.to_pil_image(image2)image1 = self.transform(image1)image2 = self.transform(image2)# image1 = torch.clamp(image1, 0, 1)# image2 = torch.clamp(image2, 0, 1)return image1, image2, labeldef load_image_pairs(self):image_pairs = []# Assume the directory structure is as follows:# root_dir# ├── similar# │ ├── similar_image1.jpg# │ ├── similar_image2.jpg# │ └── ...# └── dissimilar# ├── dissimilar_image1.jpg# ├── dissimilar_image2.jpg# └── ...similar_dir = os.path.join(self.root_dir, "similar_all_images")dissimilar_dir = os.path.join(self.root_dir, "dissimilar_all_images")# Load similar image pairs with label 1similar_images = os.listdir(similar_dir)for i in range(len(similar_images) // 2):image1_path = os.path.join(similar_dir, f"similar_{i}_first.jpg")image2_path = os.path.join(similar_dir, f"similar_{i}_second.jpg")image_pairs.append((image1_path, image2_path, 0))# Load dissimilar image pairs with label 0dissimilar_images = os.listdir(dissimilar_dir)for i in range(len(dissimilar_images) // 2):image1_path = os.path.join(dissimilar_dir, f"dissimilar_{i}_first.jpg")image2_path = os.path.join(dissimilar_dir, f"dissimilar_{i}_second.jpg")image_pairs.append((image1_path, image2_path, 1))return image_pairsdataset = ImagePairDataset(r"/home/niq/hcsr2001/data/image_similarity")train_size = int(0.8 * len(dataset))test_size = len(dataset) - train_sizetrain_dataset, test_dataset = torch.utils.data.random_split(dataset, [train_size, test_size])batch_size = 32train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)在上述代码的第8到10行:对图像进行预处理,包括将图像调整大小为256。我们使用批量大小为32,这取决于您的计算能力和 GPU。
#create the Siamese Neural Networkclass SiameseNetwork(nn.Module):def __init__(self):super(SiameseNetwork, self).__init__()# Setting up the Sequential of CNN Layers# self.cnn1 = nn.Sequential(# nn.Conv2d(3, 256, kernel_size=11,stride=4),# nn.ReLU(inplace=True),# nn.MaxPool2d(3, stride=2),# nn.Conv2d(256, 256, kernel_size=5, stride=1),# nn.ReLU(inplace=True),# nn.MaxPool2d(2, stride=2),# nn.Conv2d(256, 384, kernel_size=3,stride=1),# nn.ReLU(inplace=True)# )self.cnn1=nn.Conv2d(3, 256, kernel_size=11,stride=4)self.relu = nn.ReLU()self.maxpool1=nn.MaxPool2d(3, stride=2)self.cnn2=nn.Conv2d(256, 256, kernel_size=5,stride=1)self.maxpool2=nn.MaxPool2d(2, stride=2)self.cnn3=nn.Conv2d(256, 384, kernel_size=3,stride=1)self.fc1 =nn.Linear(46464, 1024)self.fc2=nn.Linear(1024, 256)self.fc3=nn.Linear(256, 1)# Setting up the Fully Connected Layers# self.fc1 = nn.Sequential(# nn.Linear(384, 1024),# nn.ReLU(inplace=True),# nn.Linear(1024, 32*46464),# nn.ReLU(inplace=True),# nn.Linear(32*46464,1)# )def forward_once(self, x):# This function will be called for both images# Its output is used to determine the similiarity# output = self.cnn1(x)# print(output.view(output.size()[0], -1).shape)# output = output.view(output.size()[0], -1)# output = self.fc1(output)# print(x.shape)output= self.cnn1(x)# print(output.shape)output=self.relu(output)# print(output.shape)output=self.maxpool1(output)# print(output.shape)output= self.cnn2(output)# print(output.shape)output=self.relu(output)# print(output.shape)output=self.maxpool2(output)# print(output.shape)output= self.cnn3(output)output=self.relu(output)# print(output.shape)output=output.view(output.size()[0], -1)# print(output.shape)output=self.fc1(output)# print(output.shape)output=self.fc2(output)# print(output.shape)output=self.fc3(output)return outputdef forward(self, input1, input2):# In this function we pass in both images and obtain both vectors# which are returnedoutput1 = self.forward_once(input1)output2 = self.forward_once(input2)return output1, output2
我们的网络称为 SiameseNetwork,我们可以看到它几乎与标准 CNN 相同。唯一可以注意到的区别是我们有两个前向函数(forward_once 和 forward)。为什么呢?
我们提到通过相同网络传递两个图像。forward_once 函数在 forward 函数中调用,它将一个图像作为输入传递到网络。输出存储在 output1 中,而来自第二个图像的输出存储在 output2 中,正如我们在 forward 函数中看到的那样。通过这种方式,我们设法输入了两个图像并从我们的模型获得了两个输出。
我们已经看到了损失函数应该是什么样子,现在让我们来编码它。我们创建了一个名为 ContrastiveLoss 的类,与模型类一样,我们将有一个 forward 函数。
class ContrastiveLoss(torch.nn.Module):def __init__(self, margin=2.0):super(ContrastiveLoss, self).__init__()self.margin = margindef forward(self, output1, output2, label):# Calculate the euclidean distance and calculate the contrastive losseuclidean_distance = F.pairwise_distance(output1, output2, keepdim = True)loss_contrastive = torch.mean((1-label) * torch.pow(euclidean_distance, 2) +(label) * torch.pow(torch.clamp(self.margin - euclidean_distance, min=0.0), 2))return loss_contrastivenet = SiameseNetwork().cuda()criterion = ContrastiveLoss()optimizer = optim.Adam(net.parameters(), lr = 0.0005 )
按照顶部的流程图,我们可以开始创建训练循环。我们迭代100次并提取两个图像以及标签。我们将梯度归零,将两个图像传递到网络中,网络输出两个向量。然后,将两个向量和标签馈送到我们定义的 criterion(损失函数)中。我们进行反向传播和优化。出于一些可视化目的,并查看我们的模型在训练集上的性能,因此我们将每10批次打印一次损失。
counter = []loss_history = [] iteration_number= 0# Iterate throught the epochsfor epoch in range(100):# Iterate over batchesfor i, (img0, img1, label) in enumerate(train_loader, 0):# Send the images and labels to CUDAimg0, img1, label = img0.cuda(), img1.cuda(), label.cuda()# Zero the gradientsoptimizer.zero_grad()# Pass in the two images into the network and obtain two outputsoutput1, output2 = net(img0, img1)# Pass the outputs of the networks and label into the loss functionloss_contrastive = criterion(output1, output2, label)# Calculate the backpropagationloss_contrastive.backward()# Optimizeoptimizer.step()# Every 10 batches print out the lossif i % 10 == 0 :print(f"Epoch number {epoch}\n Current loss {loss_contrastive.item()}\n")iteration_number += 10counter.append(iteration_number)loss_history.append(loss_contrastive.item())show_plot(counter, loss_history)
我们现在可以分析结果。我们能看到的第一件事是损失从1.6左右开始,并以接近1的数字结束。看到模型的实际运行情况将是有趣的。现在是我们在模型之前没见过的图像上测试我们的模型的部分。与之前一样,我们使用我们的自定义数据集类创建了一个 Siamese Network 数据集,但现在我们将其指向测试文件夹。
作为接下来的步骤,我们从第一批中提取第一张图像,并迭代5次以提取接下来5批中的5张图像,因为我们设置每批包含一张图像。然后,使用 torch.cat() 水平组合两个图像,我们可以清楚地可视化哪个图像与哪个图像进行了比较。
我们将两个图像传入模型并获得两个向量,然后将这两个向量传入 F.pairwise_distance() 函数,这将计算两个向量之间的欧氏距离。使用这个距离,我们可以作为衡量两张脸有多不相似的指标。
test_loader_one = DataLoader(test_dataset, batch_size=1, shuffle=False)dataiter = iter(test_loader_one)x0, _, _ = next(dataiter)for i in range(5):# Iterate over 5 images and test them with the first image (x0)_, x1, label2 = next(dataiter)# Concatenate the two images togetherconcatenated = torch.cat((x0, x1), 0)output1, output2 = net(x0.cuda(), x1.cuda())euclidean_distance = F.pairwise_distance(output1, output2)imshow(torchvision.utils.make_grid(concatenated), f'Dissimilarity: {euclidean_distance.item():.2f}')view raweval.py hosted with ❤ by GitHub
总结
Siamese 网络与对比损失结合,为学习图像相似性提供了一个强大而有效的框架。通过对相似和不相似图像进行训练,这些网络可以学会提取能够捕捉基本视觉特征的判别性embedding。对比损失函数通过优化embedding空间进一步增强
了模型准确测量图像相似性的能力。随着深度学习和计算机视觉的进步,Siamese 网络在各个领域都有着巨大的潜力,包括图像搜索、人脸验证和推荐系统。通过利用这些技术,我们可以为基于内容的图像检索、视觉理解以及视觉领域的智能决策开启令人兴奋的可能性。
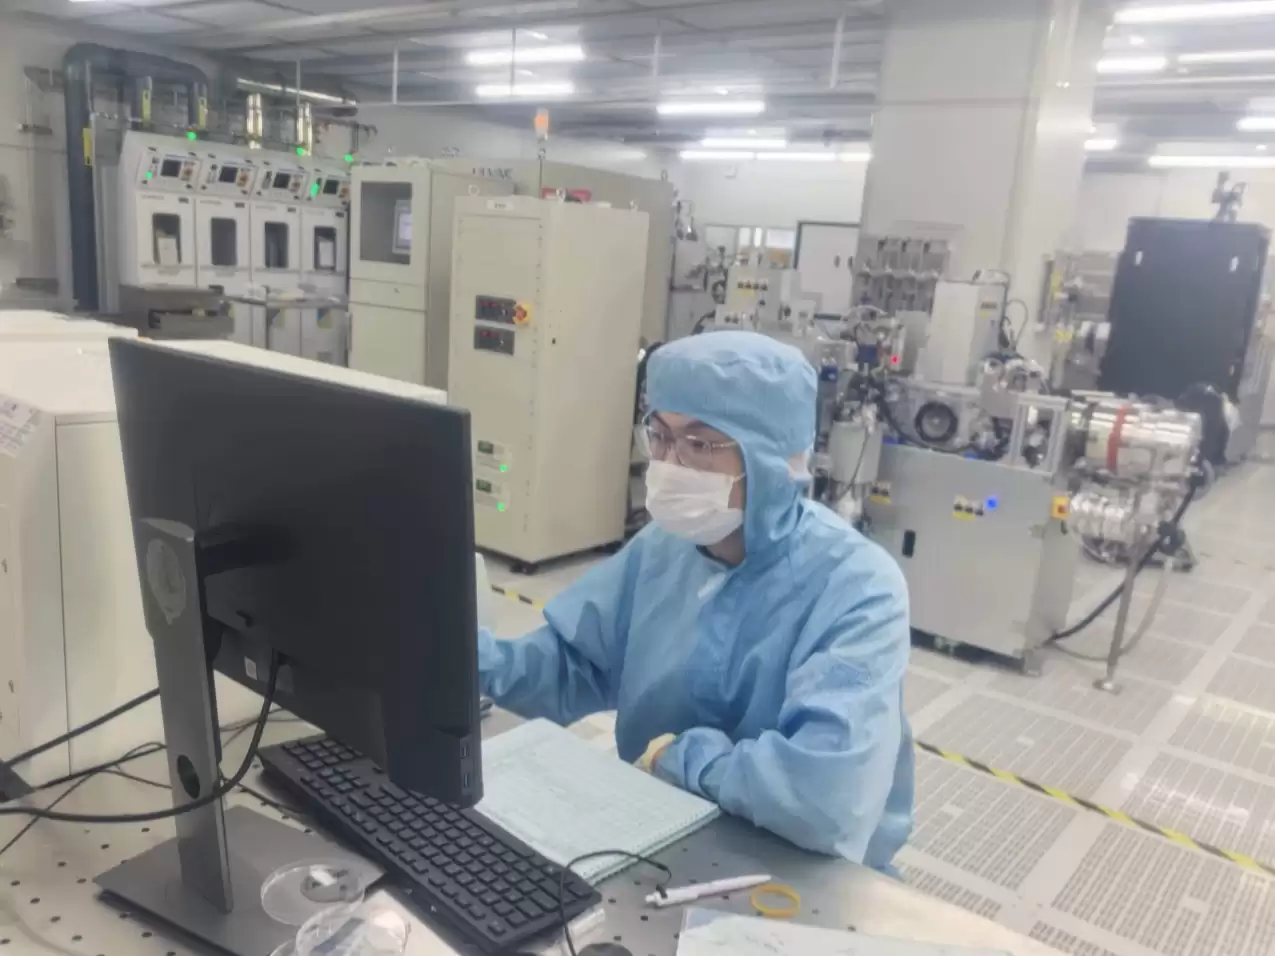
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。
苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。

一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。

2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
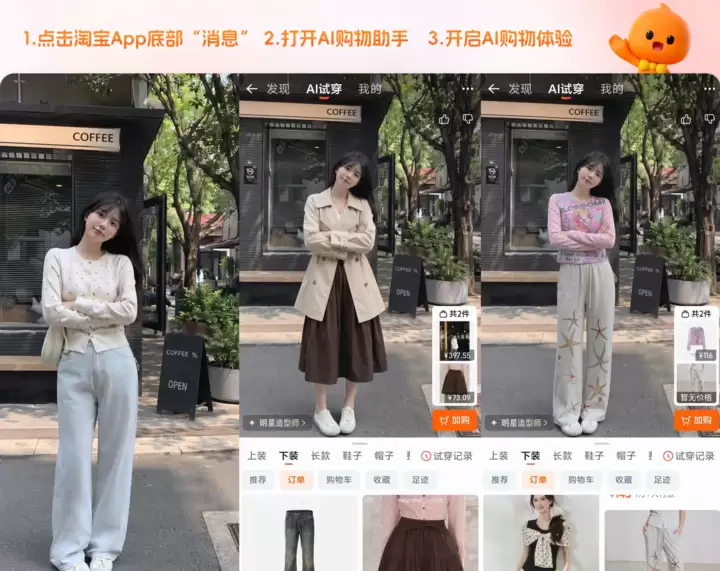
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。

商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。

亚马逊正考虑将其开发的TrainiumAI芯片直接出售给其他公司,以挑战英伟达主导地位。该芯片面向需要本地化数据解决方案的国际企业,亚马逊表示不会影响AWS云业务收入,谷歌也有类似计划。
广东省印发服务业扩能提质方案,聚焦AI机遇,建设国际竞争力的软件与信息技术创新中心,包括培育核心企业、构建AI服务体系、攻关核心技术、建设开源生态,并部署融资租赁、金融合作、算力网络、6G及智能应用。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
