

仅需10%参数量即超越SOTA!浙大、字节、港中文联合提出「类别级位姿估计」任务新框架
赋予机器人对日常物体的3D理解是机器人应用中的一项重大挑战。在未知环境中进行探索时,由于物体形状的多样性,现有的物体位姿估计方法仍然不能令人满意。最近浙江大学、字节跳动人工智能实验室和香港中文大学的研究者联合提出了一个新的框架,用于从单个RGB-D图像进行类别级物体形状和位姿估计。论文地址:https://arxiv.org/abs/2210.01112项目链接:https://zju3dv.github.io/gCasp为了处理类别内物体的形状变化,研究人员采用语义原始表示,将不同的形状
赋予机器人对日常物体的 3D 理解是机器人应用中的一项重大挑战。
在未知环境中进行探索时,由于物体形状的多样性,现有的物体位姿估计方法仍然不能令人满意。
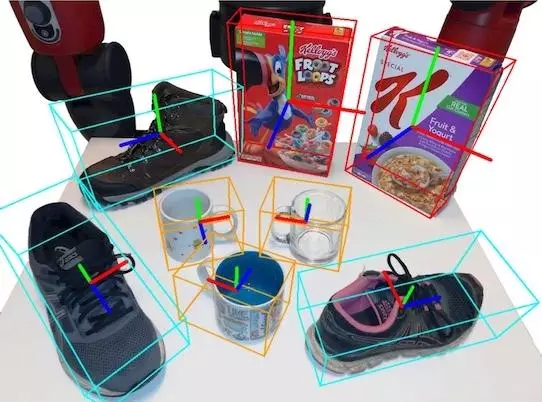
最近浙江大学、字节跳动人工智能实验室和香港中文大学的研究者联合提出了一个新的框架,用于从单个 RGB-D 图像进行类别级物体形状和位姿估计。
论文地址:https://arxiv.org/abs/2210.01112
项目链接:https://zju3dv.github.io/gCasp
为了处理类别内物体的形状变化,研究人员采用语义原始表示,将不同的形状编码到一个统一的隐空间中,这种表示是在观察到的点云和估计的形状之间建立可靠对应关系的关键。
然后通过设计的对刚体相似变换不变的形状描述子,解耦了物体的形状和位姿估计,从而支持任意位姿中目标物体的隐式形状优化。实验表明所提出的方法在公开数据集中实现了领先的位姿估计性能。
研究背景
在机器人的感知与操作领域,估计日常物体的形状和位姿是一项基本功能,并且具有多种应用,其中包括 3D 场景理解、机器人操作和自主仓储。
该任务的早期工作大多集中在实例级位姿估计上,这些工作主要通过将观察到的物体与给定的 CAD 模型对齐来获得物体位姿。
然而,这样的设置在现实世界的场景中是有限的,因为很难预先获得一个任意给定物体的确切模型。
为了推广到那些没见过但是在语义上熟悉的物体,类别级别物体位姿估计正在引起越来越多的研究关注,因为它可以潜在地处理真实场景中同一类别的各种实例。
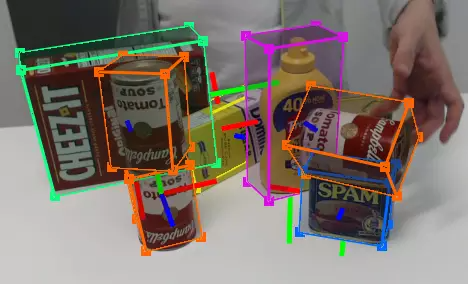
现有的类别级位姿估计方法通常尝试预测一个类中实例的像素级归一化坐标,或者采用形变之后的参考先验模型来估计物体位姿。
尽管这些工作已经取得了很大的进步,但是当同一类别中存在较大的形状差异时,这些一次性预测方法仍然面临困难。
为了处理同一类内物体的多样性,一些工作利用神经隐式表示,通过迭代优化隐式空间中的位姿和形状来适应目标物体的形状,并获得了更好的性能。
在类别级物体位姿估计中有两个主要挑战,一是巨大的类内形状差异,二是现有的方法将形状和位姿的耦合在一起进行优化,这样容易导致优化问题更加复杂。
在这篇论文中,研究人员通过设计的对刚体相似变换不变的形状描述子,解耦了物体的形状和位姿估计,从而支持任意位姿中目标物体的隐式形状优化。最后再根据估计形状与观测之间的语义关联,求解出物体的尺度与位姿。
算法介绍
算法由三个模块组成,语义原语提取、生成式形状估计和物体位姿估计。
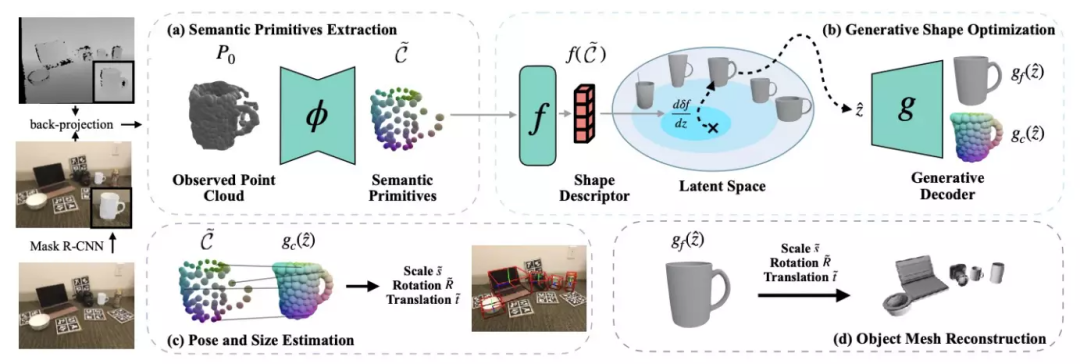
算法的输入是单张 RGB-D 图像,算法使用预先训练好的 Mask R-CNN 获得 RGB 图像的语义分割结果,然后根据相机内参反投影得到每个物体的点云。该方法主要对点云进行处理,最终求得每个物体的尺度与6DoF位姿。
语义原语提取
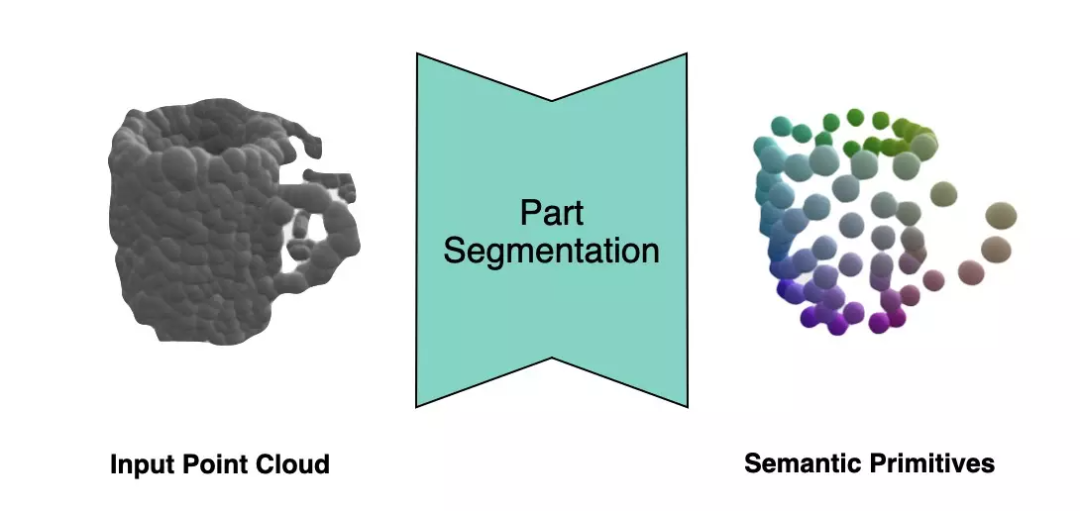
DualSDF[1] 中提出了一种针对同类物体的语义原语的表示方法。如下图左所示,在同一类物体中,每个实例都被分成了一定数量的语义原语,每个原语的标签对应着某类物体的特定部位。
为了从观测点云中提取物体的语义原语,作者利用了一个点云分割网络,将观测点云分割成了带有标签的语义原语。
生成式的形状估计
3D的生成模型(如DeepSDF)大多是在归一化的坐标系下运行的。
然而在真实世界观测中的物体与归一化坐标系之间会存在一个相似位姿变换(旋转、平移以及尺度)。
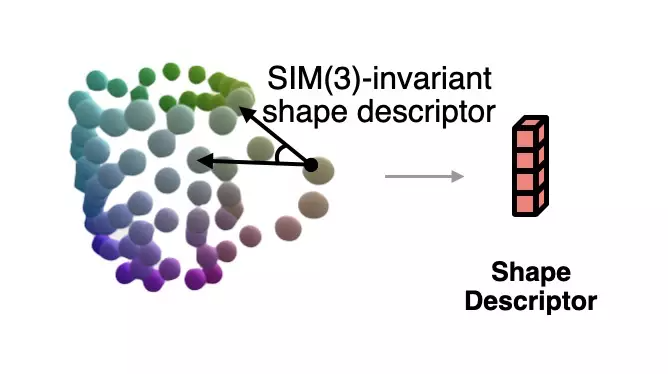
为了在位姿未知时来求解当前观测对应的归一化形状,作者基于语义原语表示,提出了一种对相似变换不变的形状描述子。
这种描述子如下图所示,它描述了不同原语构成的向量之间的夹角:
作者通过这个描述子来衡量当前观测与估计形状之间的误差,并通过梯度下降来使得估计形状与观测之间更加一致,过程如下图所示。
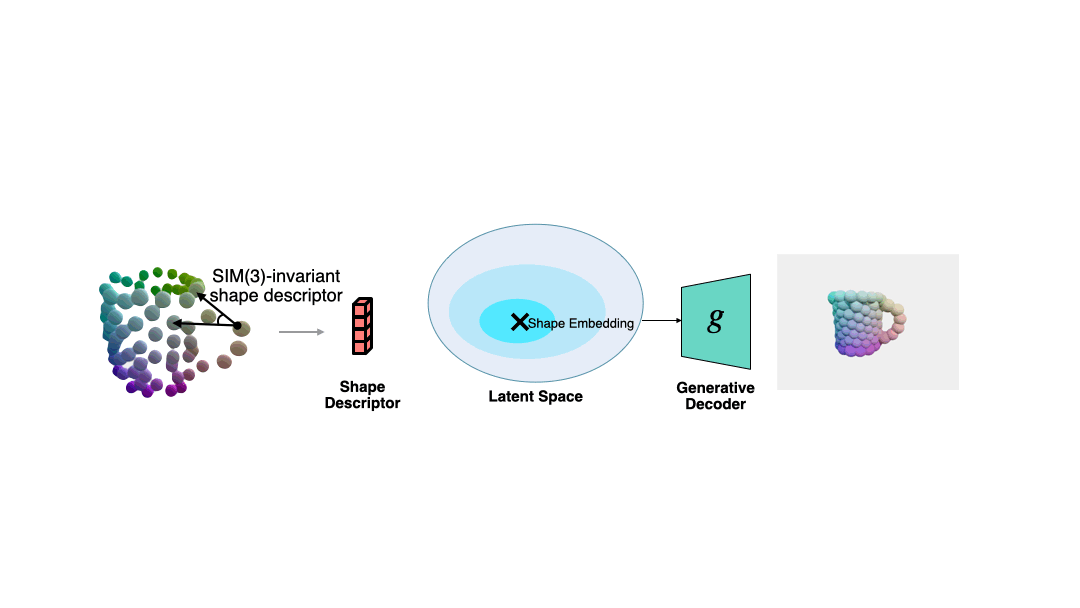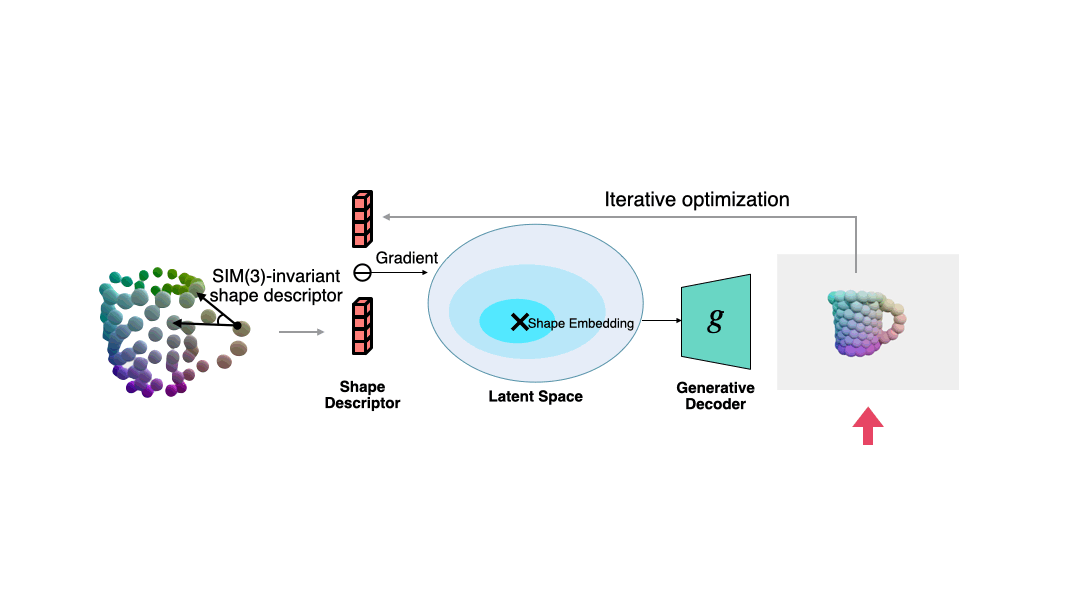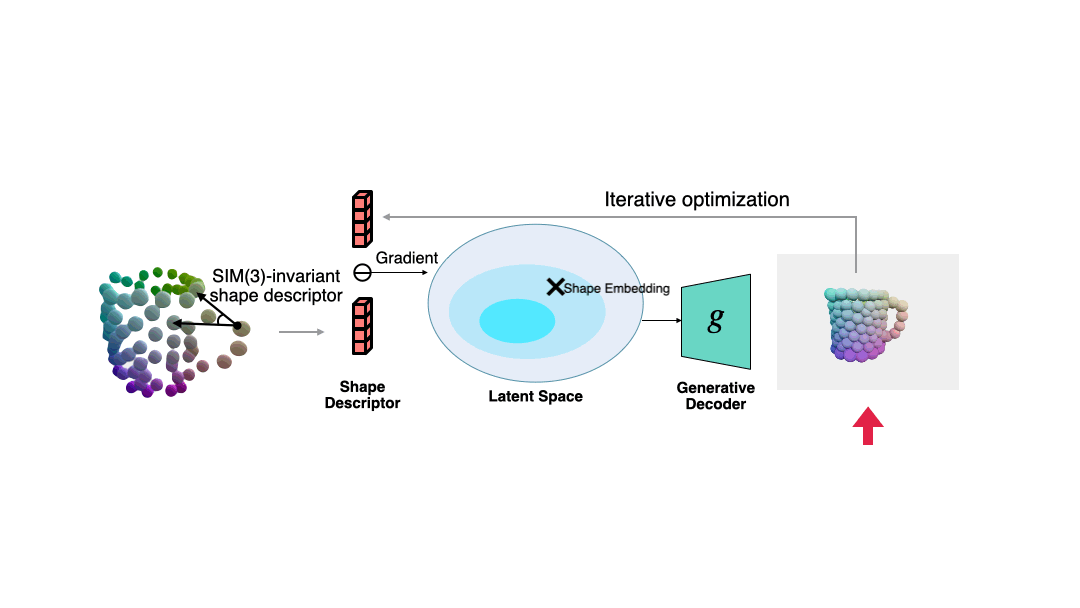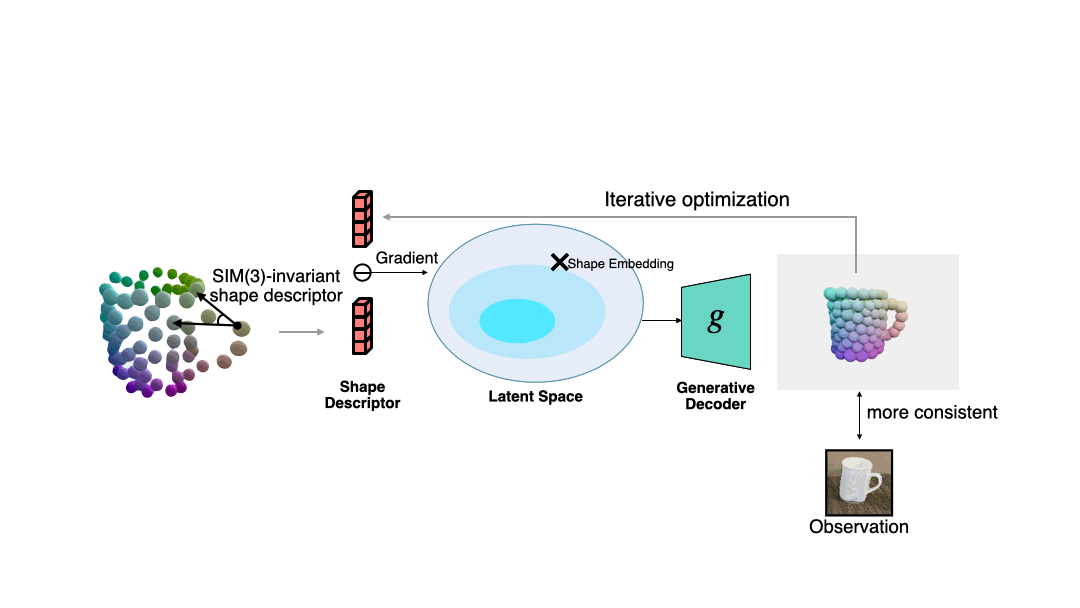
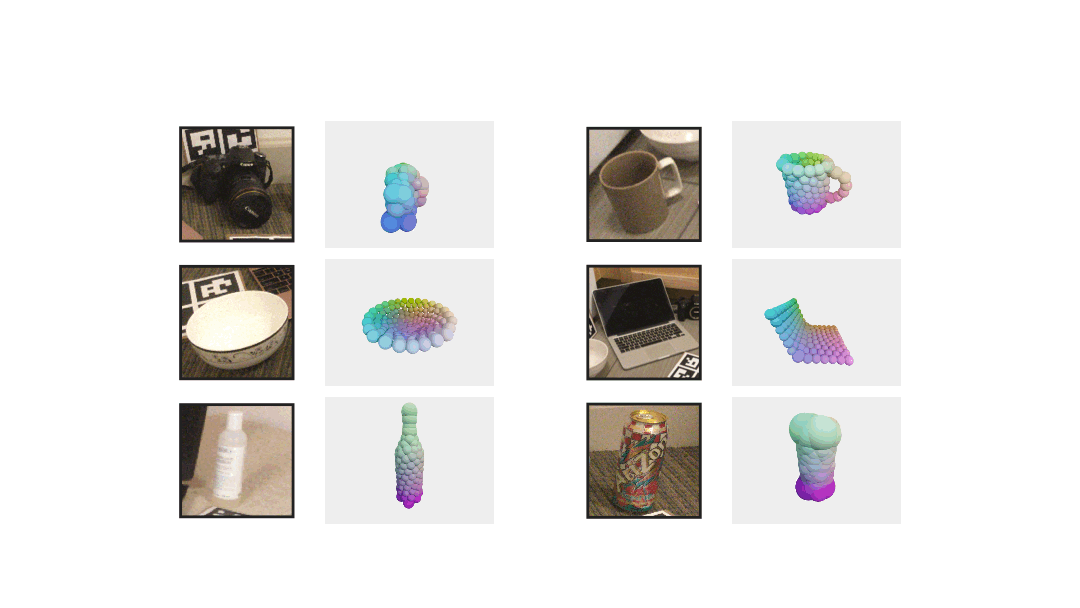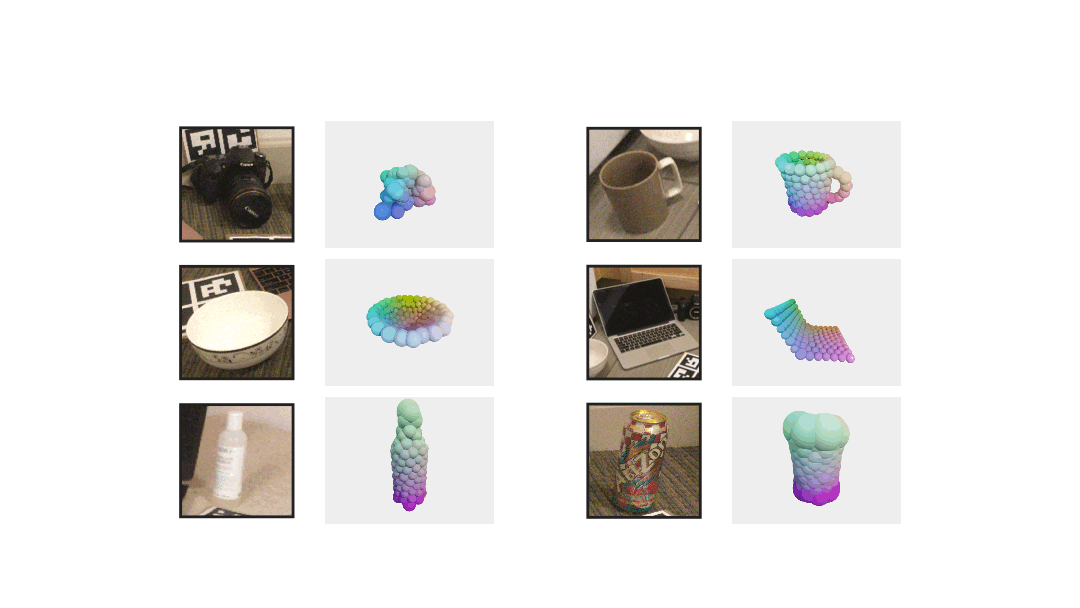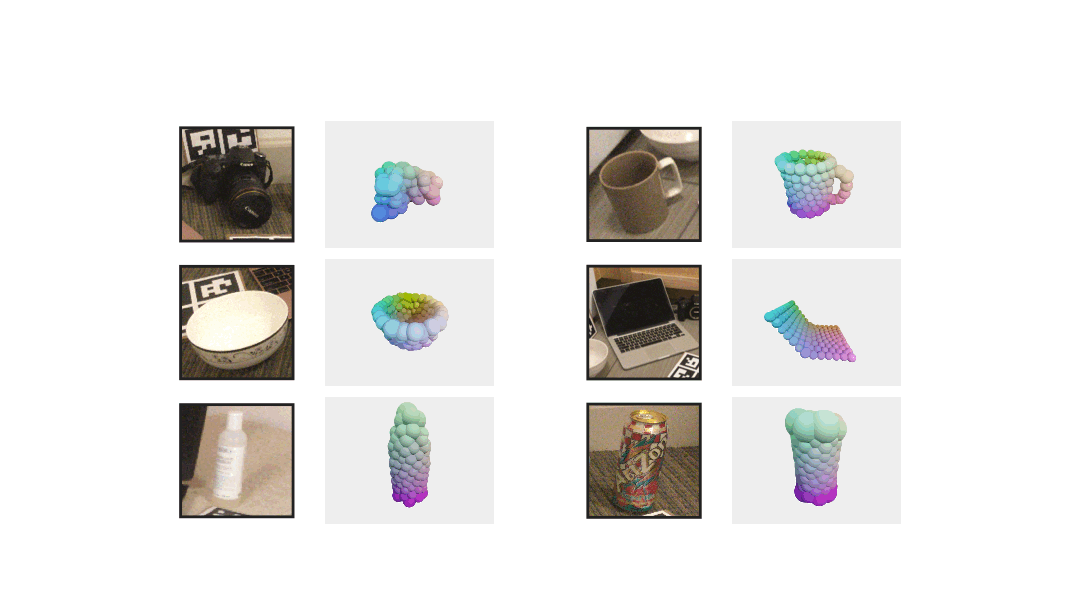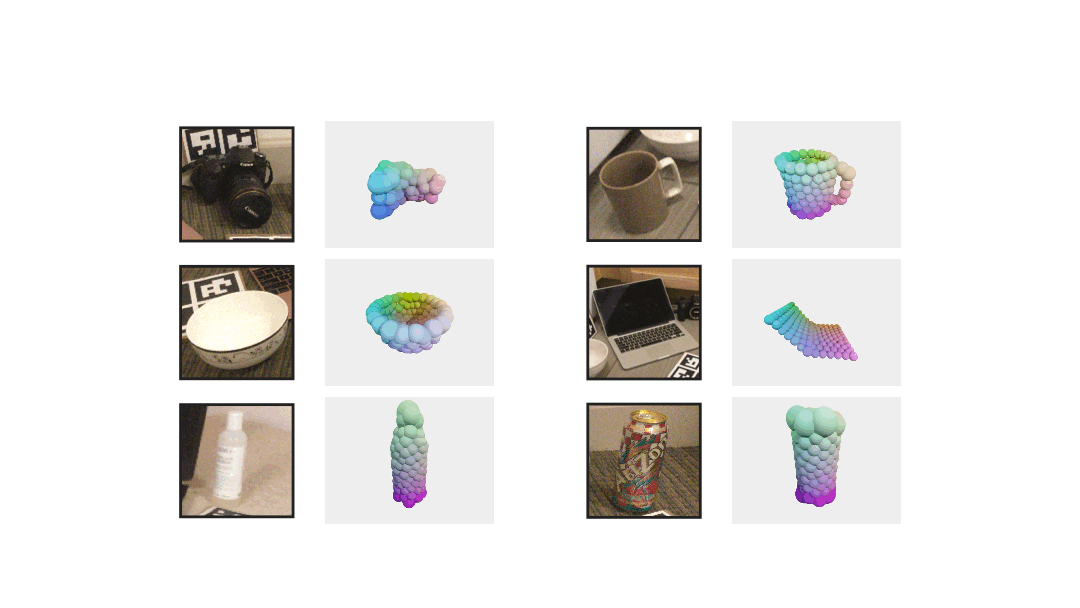
作者另外展示了更多的形状优化示例。
位姿估计
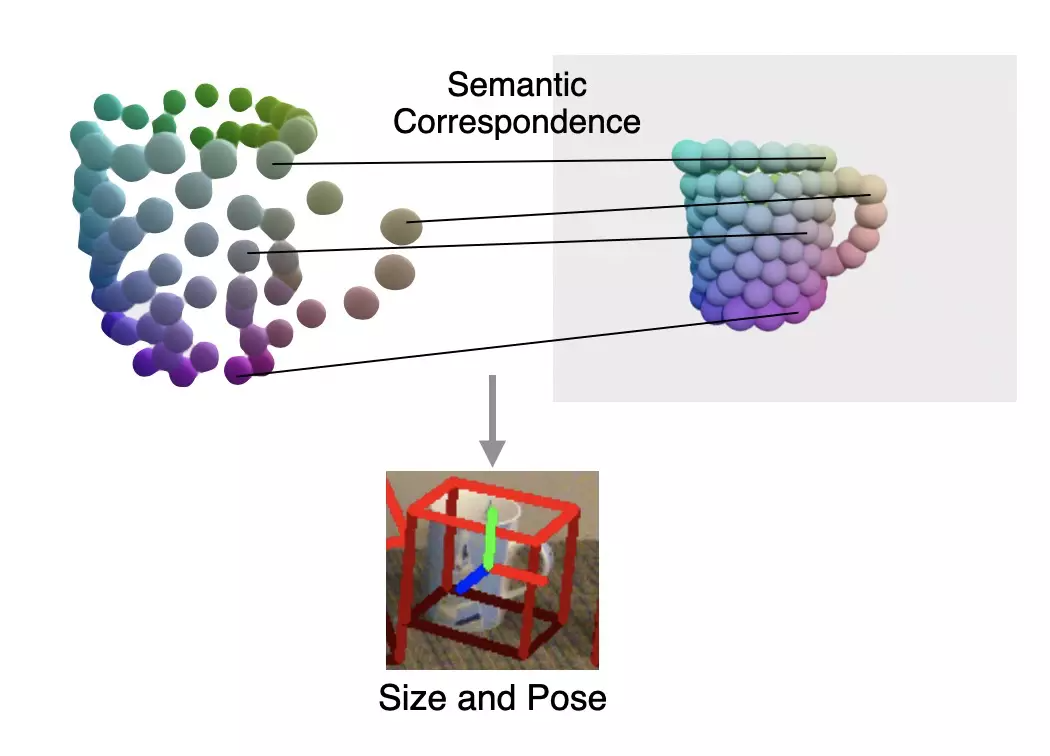
最后,通过观测点云与求解形状之间的语义原语对应关系,作者使用 Umeyama 算法求解了观测形状的位姿。
实验结果
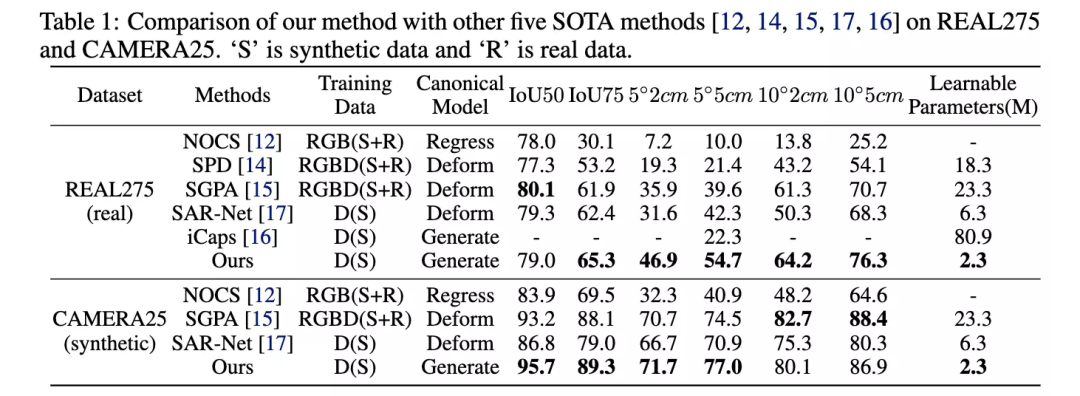
作者在 NOCS 提供的 REAL275(真实数据集) 和 CAMERA25(合成数据集) 数据集上进行了对比实验,与其他方法在位姿估计精度上进行了对比,所提出的方法在多项指标上远超其他方法。
同时,作者也对比了需要在 NOCS 提供的训练集上训练的参数量,作者需要最少的2.3M的参数量便达到了最先进水平。
下面这段代码,是一个基于经典的Windows Media Player ActiveX控件,用来在网页中嵌入视频播放器的完整示例。别看它现在似乎有点“古早”,但在某些特定场景下,这种实现方式依然有它的参考价值。 整段代码的核心是一个 标签,它负责在页面中引入并实例化播放器控件。我们来逐层拆解一下它的
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
要查看系统处理器信息,psrinfo(1M)命令是标准工具。不过,在多内核与多线程技术普及的今天,直接运行命令看到的可能并非物理CPU的实际数量。这时,加上-vp参数就非常关键了。 来看一个典型的例子: # psrinfo -vp The physical processor has 32 virt
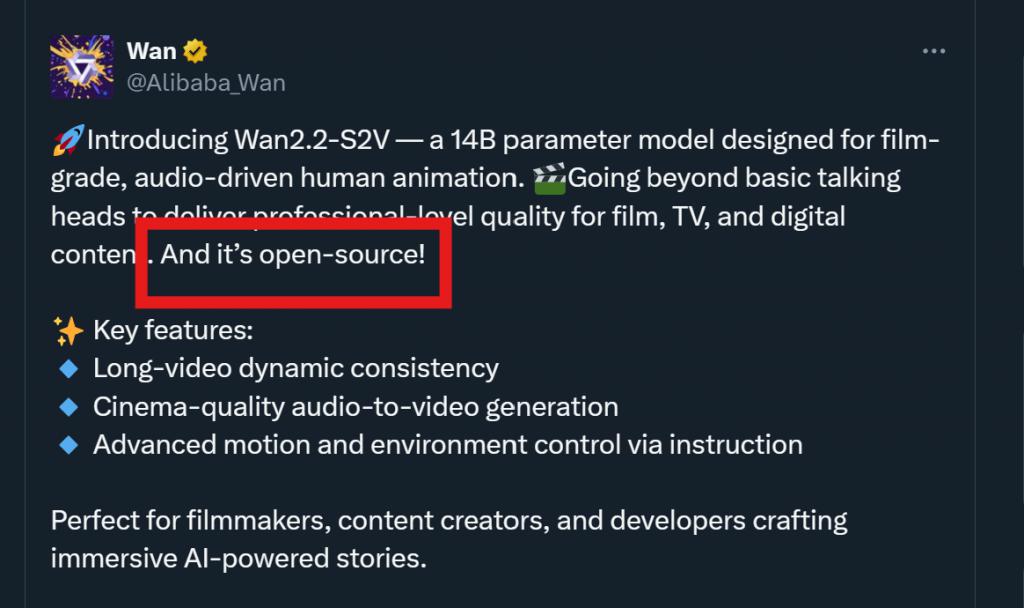
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
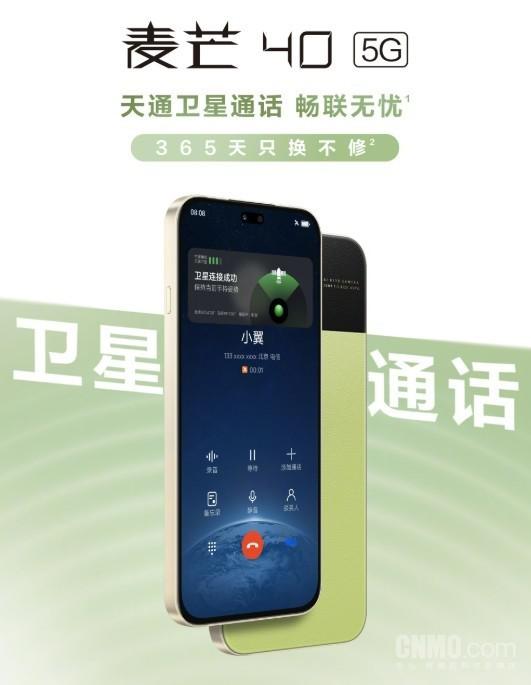
中国电信此前宣布将推出全新一代麦芒AI手机。根据最新消息,中国电信麦芒40手机的发布会——“麦芒40上市暨星小辰终端智能体发布会”将于6月25日下午14:30正式举行。CNMO得知,已有数码博主提前曝光了麦芒40的详细配置信息。麦芒40消息称,麦芒40将内置小艺与电信星小辰双AI系统,能够实时识别通话内容,有效防范电信诈骗。该机配备X键,支持一键拨打天通卫星电话。由于是电信自有品牌产品,麦芒40还将赠送一年期的天通卫星通信权益,包含50分钟卫星通话时长和





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



