

机器学习超参数调优总结(PySpark ML)
ML中的一个重要任务是模型选择,或者使用数据为给定任务找到最佳的模型或参数。这也称为调优。可以对单个的估计器(如LogisticRegression)进行调优,也可以对包括多种算法、特性化和其他步骤的整个pipeline进行调优。用户可以一次调优整个Pipeline,而不是分别调优Pipeline中的每个元素。ML中的一个重要任务是模型选择,或者使用数据为给定任务找到最佳的模型或参数。这也称为调优。可以对单个的Estimator(如LogisticRegression)进行调优,也可以对包括
ML中的一个重要任务是模型选择,或者使用数据为给定任务找到最佳的模型或参数。这也称为调优。可以对单个的估计器(如LogisticRegression)进行调优,也可以对包括多种算法、特性化和其他步骤的整个pipeline进行调优。用户可以一次调优整个Pipeline,而不是分别调优 Pipeline 中的每个元素。
ML中的一个重要任务是模型选择,或者使用数据为给定任务找到最佳的模型或参数。这也称为调优。可以对单个的Estimator(如LogisticRegression)进行调优,也可以对包括多种算法、特性化和其他步骤的整个pipeline进行调优。用户可以一次调优整个Pipeline,而不是分别调优Pipeline中的每个元素。
MLlib支持使用CrossValidator和TrainValidationSplit等工具进行模型选择。这些工具需要具备以下条件:
- 估计器:要调优的算法或管道pipeline
- 一组参数:可选择的参数,有时称为搜索的“参数网格”
- 评估者:度量拟合模型在测试数据上的表现
这些模型选择工具的工作方式如下:
- 他们将输入数据拆分为单独的训练和测试数据集。
- 对于每个(训练、测试)对,它们遍历ParamMap 集合:
对于每个ParamMap,使用这些参数拟合Estimator,得到拟合的Model,并使用Evaluator 评估Model的性能。
- 他们选择Model由表现最好的一组参数产生。
为了帮助构造参数网格,用户可以使用ParamGridBuilder。默认情况下,参数网格中的参数集以串行方式计算。在使用CrossValidator或TrainValidationSplit运行模型选择之前,可以通过将并行度设置为2或更多(1的值将是串行的)来并行地进行参数评估。并行度的值应该谨慎选择,以便在不超过集群资源的情况下最大化并行度,较大的值不一定会提高性能。一般来说,10以上的值对大多数集群来说应该足够了。
交叉验证
CrossValidator交叉验证器首先将数据集分割为一组折叠数据集,这些折叠数据集用作单独的训练数据集和测试数据集。例如,当k=3次时,CrossValidator将生成3对(训练,测试)数据集,每对数据集使用2/3的数据进行训练,1/3的数据进行测试。为了评估一个特定的ParamMap, CrossValidator通过在3个不同的(训练,测试)数据集对上拟合Estimator产生的3个模型计算平均评估度量。
在确定最佳ParamMap之后,CrossValidator最终使用最佳ParamMap和整个数据集重新匹配Estimator。
from pyspark.ml import Pipeline
from pyspark.ml.classification import LogisticRegression
from pyspark.ml.evaluation import BinaryClassificationEvaluator
from pyspark.ml.feature import HashingTF, Tokenizer
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder

# 准备训练文件,并做好标签。
training = spark.createDataFrame([
(0, "a b c d e spark", 1.0),
(1, "b d", 0.0),
(2, "spark f g h", 1.0),
(3, "hadoop mapreduce", 0.0),
(4, "b spark who", 1.0),
(5, "g d a y", 0.0),
(6, "spark fly", 1.0),
(7, "was mapreduce", 0.0),
(8, "e spark program", 1.0),
(9, "a e c l", 0.0),
(10, "spark compile", 1.0),
(11, "hadoop software", 0.0)
], ["id", "text", "label"])

# 配置一个ML管道,它由树stages组成:tokenizer、hashingTF和lr。
tokenizer = Tokenizer(inputCol="text", outputCol="words")
hashingTF = HashingTF(inputCol=tokenizer.getOutputCol(), outputCol="features")
lr = LogisticRegression(maxIter=10)
pipeline = Pipeline(stages=[tokenizer, hashingTF, lr])

# 我们现在将Pipeline作为一个Estimator,将其包装在CrossValidator实例中。
# 这将允许我们共同选择所有管道阶段的参数。
# 交叉验证器需要一个Estimator、一组Estimator ParamMaps和一个Evaluator。
# 我们使用ParamGridBuilder来构造一个用于搜索的参数网格。
# hashingTF.numFeatures 的3个值, lr.regParam的2个值,
# 这个网格将有3 x 2 = 6的参数设置供CrossValidator选择。


paramGrid = ParamGridBuilder()
.addGrid(hashingTF.numFeatures, [10, 100, 1000])
.addGrid(lr.regParam, [0.1, 0.01])
.build()

crossval = CrossValidator(estimator=pipeline,
estimatorParamMaps=paramGrid,
evaluator=BinaryClassificationEvaluator(),
numFolds=2)# 使用3+ folds

# 运行交叉验证,并选择最佳参数集。
cvModel = crossval.fit(training)

# 准备测试未标注的文件
test = spark.createDataFrame([
(4, "spark i j k"),
(5, "l m n"),
(6, "mapreduce spark"),
(7, "apache hadoop")
], ["id", "text"])

# 对测试文档进行预测, cvModel使用发现的最佳模型(lrModel)。
prediction = cvModel.transform(test)
selected = prediction.select("id", "text", "probability", "prediction")
for row in selected.collect():
print(row)
训练验证拆分
除了 CrossValidator 之外,Spark 还提供了用于超参数调优的 TrainValidationSplit。TrainValidationSplit 只计算每个参数组合一次,而在 CrossValidator 的情况下是k次。因此,它的成本较低,但当训练数据集不够大时,它不会产生可靠的结果。
与 CrossValidator 不同,TrainValidationSplit 创建单个(训练、测试)数据集对。它使用 trainRatio 参数将数据集分成这两部分。例如,当trainRatio=0.75 时,TrainValidationSplit 将生成一个训练和测试数据集对,其中 75% 的数据用于训练,25% 用于验证。
像 CrossValidator 一样,TrainValidationSplit 最终使用最佳 ParamMap 和整个数据集匹配 Estimator。
from pyspark.ml.evaluation import RegressionEvaluator
from pyspark.ml.regression import LinearRegression
from pyspark.ml.tuning import ParamGridBuilder, TrainValidationSplit

# Prepare training and test data.
data = spark.read.format("libsvm")
.load("data/mllib/sample_linear_regression_data.txt")
train, test = data.randomSplit([0.9, 0.1], seed=12345)

lr = LinearRegression(maxIter=10)

# 我们使用ParamGridBuilder来构造一个用于搜索的参数网格。
# TrainValidationSplit将尝试所有值的组合,并使用评估器确定最佳模型。
paramGrid = ParamGridBuilder()
.addGrid(lr.regParam, [0.1, 0.01])
.addGrid(lr.fitIntercept, [False, True])
.addGrid(lr.elasticNetParam, [0.0, 0.5, 1.0])
.build()

# 在这种情况下,估计器是简单的线性回归。
# TrainValidationSplit需要一个Estimator、一组Estimator ParamMaps 和一个 Evaluator。
tvs = TrainValidationSplit(estimator=lr,
 estimatorParamMaps=paramGrid,
 evaluator=RegressionEvaluator(),
 # 80%的数据将用于培训,20%用于验证。
 trainRatio=0.8)

# 运行TrainValidationSplit,并选择最佳参数集。
model = tvs.fit(train)

# 对测试数据进行预测。模型是参数组合后性能最好的模型。
model.transform(test)
.select("features", "label", "prediction")
.show() 
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
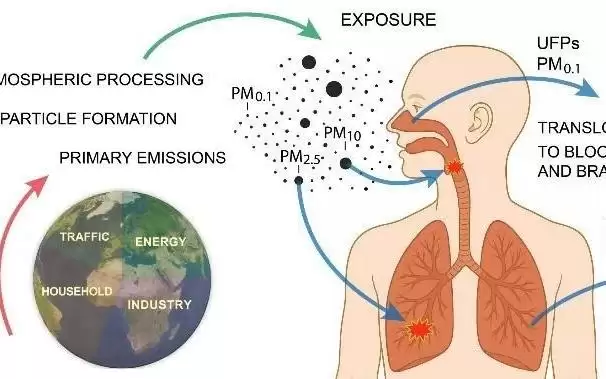
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



