

使用手工特征提升模型性能
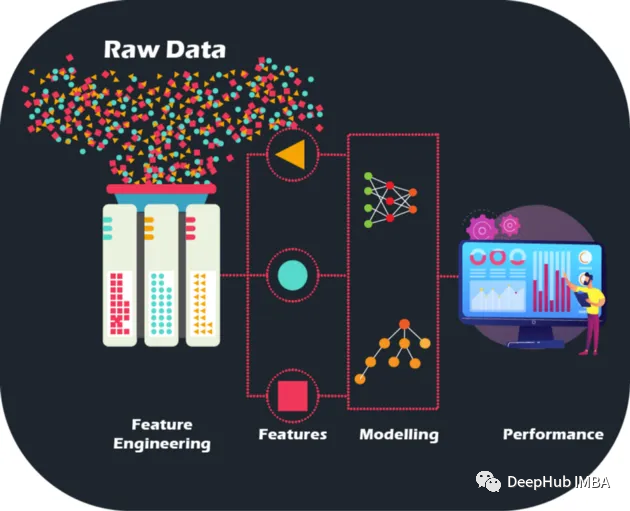
通过对原始数据进行手工的特征工程,我们可以将模型的准确性和性能提升到新的水平,为更精确的预测和更明智的业务决策铺平道路,可以以前所未有的方式优化模型并提升业务能力。原始数据就像一个没有图片的拼图游戏——但通过特征工程,我们可以将这些碎片拼在一起,虽然拥有大量数据确实是寻求建立机器学习模型的金融机构的宝库,但同样重要的是要承认并非所有数据都提供信息。并且手工特征是人工设计出来,每一步操作能够说出理由,也带来了可解释性。特征工程不仅仅是选择最好的特征。它还涉及减少数据中的噪音和冗余,以提高模型的泛化能力。这
通过对原始数据进行手工的特征工程,我们可以将模型的准确性和性能提升到新的水平,为更精确的预测和更明智的业务决策铺平道路, 可以以前所未有的方式优化模型并提升业务能力。
原始数据就像一个没有图片的拼图游戏——但通过特征工程,我们可以将这些碎片拼在一起,虽然拥有大量数据确实是寻求建立机器学习模型的金融机构的宝库,但同样重要的是要承认并非所有数据都提供信息。并且手工特征是人工设计出来,每一步操作能够说出理由,也带来了可解释性。
特征工程不仅仅是选择最好的特征。它还涉及减少数据中的噪音和冗余,以提高模型的泛化能力。这是至关重要的,因为模型需要在看不见的数据上表现良好才能真正有用。
数据集描述
本文中描述的数据集经过匿名处理和屏蔽,以维护客户数据的机密性。特征可分类如下:
D_* = 拖欠变量
S_* = 支出变量
P_* = 支付变量
B_* = 平衡变量
R_* = 风险变量
总共有 100 个整数特征和 100 个浮点特征代表过去 12 个月客户的状态。该数据集包含有关客户报表的信息,从 1 到 13 不等。客户的每张信用卡报表之间可能有 30 到 180 天的间隔(即客户的信用卡报表可能缺失)。每个客户都由一个客户 ID 表示。customer_ID=0的客户前5条的样本数据如下所示:
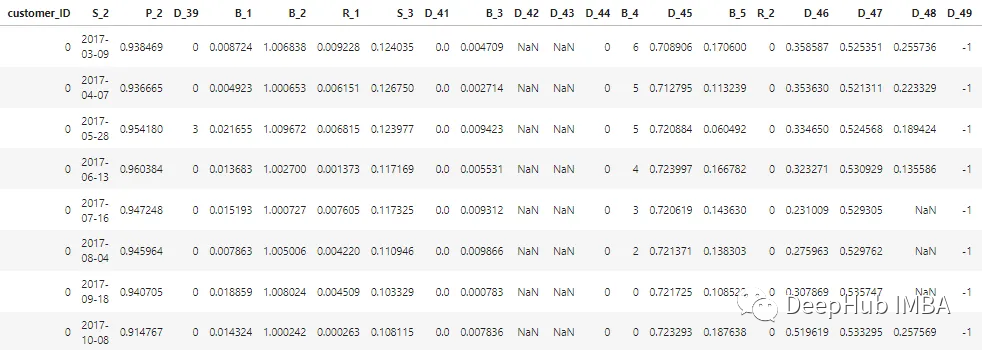
在 700 万个 customer_ID 中,98% 的标签为“0”(好客户,无默认),2% 的标签为“1”(坏客户,默认)。
数据集很大,所以我们使用cudf来加速处理,如果你没有安装cudf,那么使用pandas也是一样的
# LOAD LIBRARIES
 import pandas as pd, numpy as np # CPU libraries
 import cudf # GPU libraries
 import matplotlib.pyplot as plt, gc, os

 df = cudf.read_parquet('./data.parquet')
特征生成方法
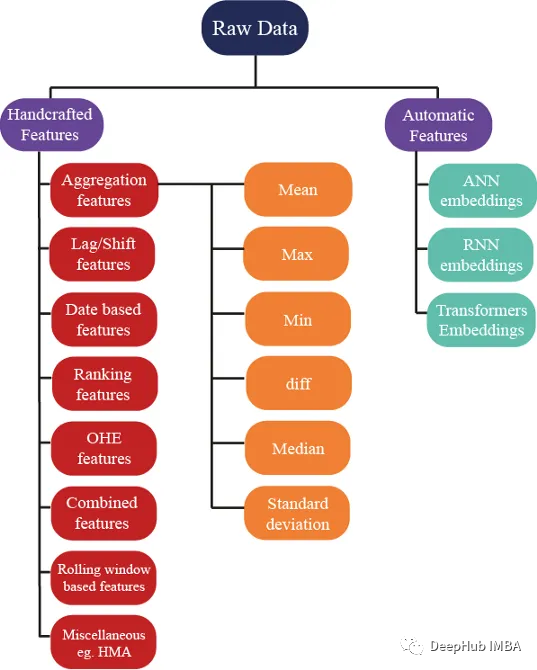
有数百种想法可用于生成特征;但是我们还确保这些特征有助于提高模型的性能,下图显示了特征工程中使用的一些基本方法:
聚合特征
聚合是理解复杂数据的秘诀。通过计算分类分组变量(如 customer_ID (C_ID) 或产品类别)的汇总统计数据或数值变量的聚合,我们可以发现一些不可见的模式和趋势。借助均值、最大值、最小值、标准差和中值等汇总统计数据,我们可以构建更准确的预测模型,并从客户数据、交易数据或任何其他数值数据中提取有意义的见解。
可以计算每个客户的这些统计属性
cat_features = ["B_1","B_2","D_1","D_2","D_10","P_21","D_126","D_3","D_42","R_66","R_68"]
 num_features = [col for col in all_cols if col not in cat_features] #all features accept cateforical features.
 test_num_agg = df.groupby("customer_ID")[num_features].agg(['mean', 'std', 'min', 'max', 'last','median']) #grouping by customerID
 test_num_agg.columns = ['_'.join(x) for x in test_num_agg.columns]
均值:一个数值变量的平均值,可以给出数据集中趋势的一般意义。平均值可以捕获:
客户拥有的平均银行余额。
- 平均客户支出。
- 两个信用报表之间的平均时间(信用付款之间的时间)。
- 借钱的平均风险。
标准偏差 (Std):衡量数据围绕均值的分布情况,可以深入了解数据的变异程度。余额的高度可变性表明客户有消费。
最小值和最大值可以捕获客户的财富,也可以捕获有关客户支出和风险的信息。
中位数:当数据高度倾斜时,使用平均值并不是一个更好的主意,因此可以使用中值(可以使用数值的中间值。
最新值可能是最重要的特征,因为它们包含有关发布给客户的最新已知信用声明的信息,也就表明目前客户账户的最新状态。
独热编码
对分类变量使用上述统计属性是不明智的,因为计算最小值、最大值或标准偏差并不能给我们任何有用的信息。那么我们应该怎么做呢?可以使用像count这样的特征,和唯一的数量来计算特征,最新的值也可以使用
cat_features = ["B_1","B_2","D_1","D_2","D_10","P_21","D_126","D_3","D_42","R_66","R_68"]
 test_cat_agg = df.groupby("customer_ID")[cat_features].agg(['count', 'last', 'nunique'])
 test_cat_agg.columns = ['_'.join(x) for x in test_cat_agg.columns]
但是这些信息不会捕获客户是否被归类到特定的类别中。所以我们通过对变量进行独热编码,然后对变量(例如均值、总和和最后)进行聚合来实现。
平均值将捕获客户属于该类别的总次数/银行对帐单总数的比率。总和将只是客户属于该类别的总次数。
from cuml.preprocessing import OneHotEncoder
 df_categorical = df_last[cat_features].astype(object)
 ohe = OneHotEncoder(drop='first', sparse=False, dtype=np.float32, handle_unknown='ignore')
 ohe.fit(df_categorical)with open("ohe.pickle", 'wb') as f:
pickle.dump(ohe, f) #save the encoder so that it can be used for test data as well df_categorical = pd.DataFrame(ohe.transform(df_categorical).astype(np.float16),index=df_categorical.index).rename(columns=str)
 df_categorical['customer_ID']=df['customer_ID']
 df_categorical.groupby('customer_ID').agg(['mean', 'sum', 'last'])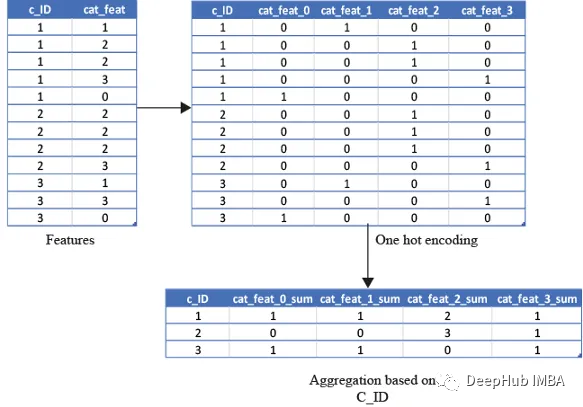
基于排名的特征
在预测客户行为方面,基于排名的特征是非常重要的。通过根据收入或支出等特定属性对客户进行排名,我们可以深入了解他们的财务习惯并更好地管理风险。
使用 cudf 的 rank 函数,我们可以轻松计算这些特征并使用它们来为预测提供信息。例如,可以根据客户的消费模式、债务收入比或信用评分对客户进行排名。然后这些特征可用于预测违约或识别有可能拖欠付款的客户。
基于排名的特征还可用于识别高价值客户、目标营销工作和优化贷款优惠。例如,可以根据客户接受贷款提议的可能性对客户进行排名,然后将排名最高的客户作为目标。
df[feat+'_rank']=df[feat].rank(pct=True, method='min')
PCT用于是否做百分位排名。客户的排名也可以基于分类特征来计算。
df[feat+'_rank']=df.groupby([cat_feat]).rank(pct=True, method='min')
特征组合
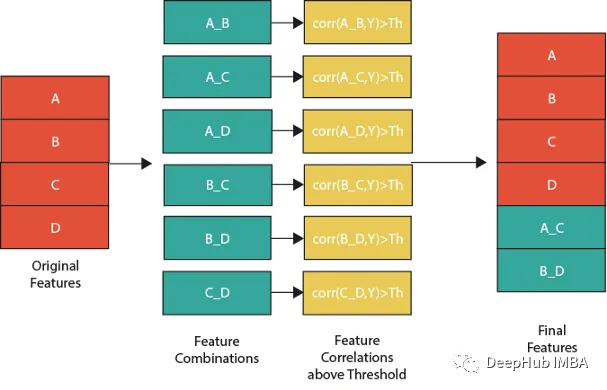
特征组合的一种流行方法是线性或非线性组合。这包括采用两个或多个现有特征,将它们组合在一起创建一个新的复合特征。然后使用这个复合特征来识别单独查看单个特征时可能不可见的模式、趋势和相关性。
例如,假设我们正在分析客户消费习惯的数据集。可以从个人特征开始,比如年龄、收入和地点。但是通过以线性或非线性的方式组合这些特性,可以创建新的复合特性,使我们能够更多地了解客户。可以结合收入和位置来创建一个复合特征,该特征告诉我们某一地区客户的平均支出。
但是并不是所有的特征组合都有用。关键是要确定哪些组合与试图解决的问题最相关,这需要对数据和问题领域有深刻的理解,并仔细分析创建的复合特征和试图预测的目标变量之间的相关性。
下图展示了一个组合特征并将信息用于模型的过程。作为筛选条件,这里只选择那些与目标相关性大于最大值 0.9 的特征。
features=[col for col in train.columns if col not in ['customer_ID',target]+cat_features]
 for feat1 in features:
for feat2 in features:
th=max(np.corr(feat1,Y)[0],np.corr(feat1,Y)[0]) #calculate threshold
feat3=df[feat1]-df[feat2] #difference feature
corr3=np.corr(feat3,Y)[0]
if(corr3>max(th,0.9)): #if correlation greater than max(th,0.9) we add it as feature
df[feat1+'_'+feat2]=feat3
基于时间/日期的特征
在数据分析方面,基于时间的特征非常重要。通过根据时间属性(例如月份或星期几)对数据进行分组,可以创建强大的特征。这些特征的范围可以从简单的平均值(如收入和支出)到更复杂的属性(如信用评分随时间的变化)。
借助基于时间的特征,还可以识别在孤立地查看数据时可能看不到的模式和趋势。下图演示了如何使用基于时间的特征来创建有用的复合属性。
首先,计算一个月内的值的平均值(可以使用该月的某天或该月的某周等),将获得的DF与原始数据合并,并取各个特征之间的差。
features=[col for col in train.columns if col not in ['customer_ID',target]+cat_features]
 month_Agg=df.groupby([month])[features].agg('mean')#grouping based on month feature
 month_Agg.columns = ['_month_'.join(x) for x in month_Agg.columns]
 month_Agg.reset_index(inplace=True)
 df=df.groupby(month_Agg,notallow='month')
 for feat in features: #create composite features b taking difference
df[feat+'_'+feat+'_month_mean']=df[feat]-df[feat+'_month_mean']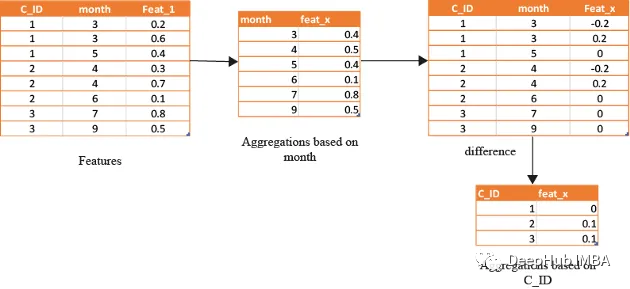
还可以通过使用时间作为分组变量来创建基于排名的特征,如下所示
features=[col for col in train.columns if col not in ['customer_ID',target]+cat_features]
 month_Agg=df.groupby([month])[features].rank(pct=True) #grouping based on month feature
 month_Agg.columns = ['_month_'.join(x) for x in month_Agg.columns]
 month_Agg.reset_index(inplace=True)
 df=pd.concat([df,month_Agg],axis=1) #concat to original dataframe
滞后特征
滞后特征是有效预测金融数据的重要工具。这些特征包括计算时间序列中当前值与之前值之间的差值。通过将滞后特征纳入分析,可以更好地理解数据中的模式和趋势,并做出更准确的预测。
如果滞后特征显示客户连续几个月按时支付信用卡账单,可能会预测他们将来不太可能违约。相反,如果延迟特征显示客户一直延迟或错过付款,可能会预测他们更有可能违约。
# difference function calculate the lag difference for numerical features
 #between last value and shift last value.
 def difference(groups,num_features,shift):
data=(groups[num_features].nth(-1)-groups[num_features].nth(-1*shift)).rename(columns={f: f"{f}_diff{shift}" for f in num_features})
return data
 #calculate diff features for last -2nd last, last -3rd last, last- 4th last
 def get_difference(data,num_features):
print("diff features...")
groups=data.groupby('customer_ID')
df1=difference(groups,num_features,2).fillna(0)
df2=difference(groups,num_features,3).fillna(0)
df3=difference(groups,num_features,4).fillna(0)
df1=pd.concat([df1,df2,df3],axis=1)
df1.reset_index(inplace=True)
df1.sort_values(by='customer_ID')
del df2,df3
gc.collect()
return df1train_diff = get_difference(df, num_features)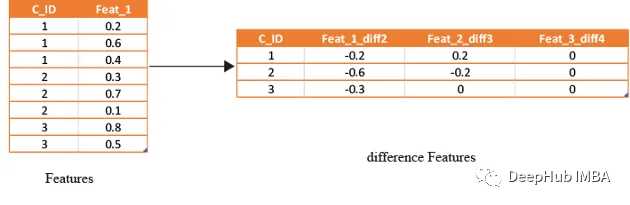
基于滚动窗口的特性
这些特征只是取最后3(4,5,…x)值的平均值,这取决于数据,因为基于时间的最新值携带了关于客户最新状态的信息。
xth=3 #define the window size
 df["cumulative"]=df.groupby('customer_ID').sort_values(by=['time'],ascending=False).cumcount()
 last_info=df[df["cumulative"]<=xth]
 last_info = last_info.groupby("customer_ID")[num_features].agg(['mean', 'std', 'min', 'max', 'last','median']) #grouping by customerID
 last_info.columns = ['_'.join(x) for x in last_info.columns]
其他的特征提取方法
上面的方法已经创建了足够多的特征来构建一个很棒的模型。但是根据数据的性质,还可以创建更多的特征。例如:可以创建像null计数这样的特征,它可以计算客户当前的总null值,从而帮助捕获基于树的算法无法理解的特征分布。
def calc_nan(df,features):
print("calculating nan_info...")
df_nan = (df[features].mul(0) + 1).fillna(0) #marke non_null values as 1 and null as zero
df_nan['customer_ID'] = df['customer_ID']
nan_sum = df_nan.groupby("customer_ID").sum().sum(axis=1) #total unknown values for a customer
nan_last = df_nan.groupby("customer_ID").last().sum(axis=1)#how many last values that are not known
del df_nan
gc.collect()
return nan_sum,nan_last
这里可以不使用平均值,而是使用修正的平均值,如基于时间的加权平均值或 HMA(hull moving average)。
总结
在本文中介绍了一些在现实世界中用于预测违约风险的最常见的手工特性策略。但是总是有新的和创新的方法来设计特征,并且手工设置特征的方法是费时费力的,所以我们将在后面的文章中介绍如何实用工具进行自动的特征生成。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
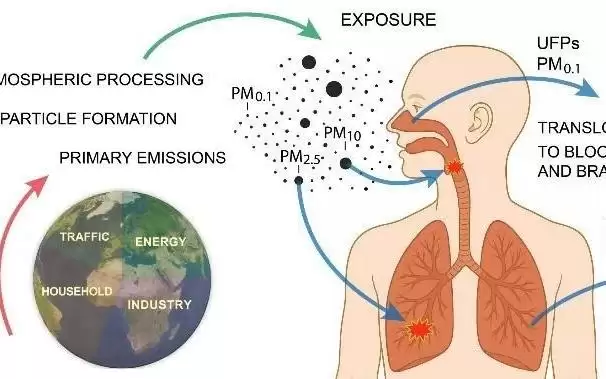
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
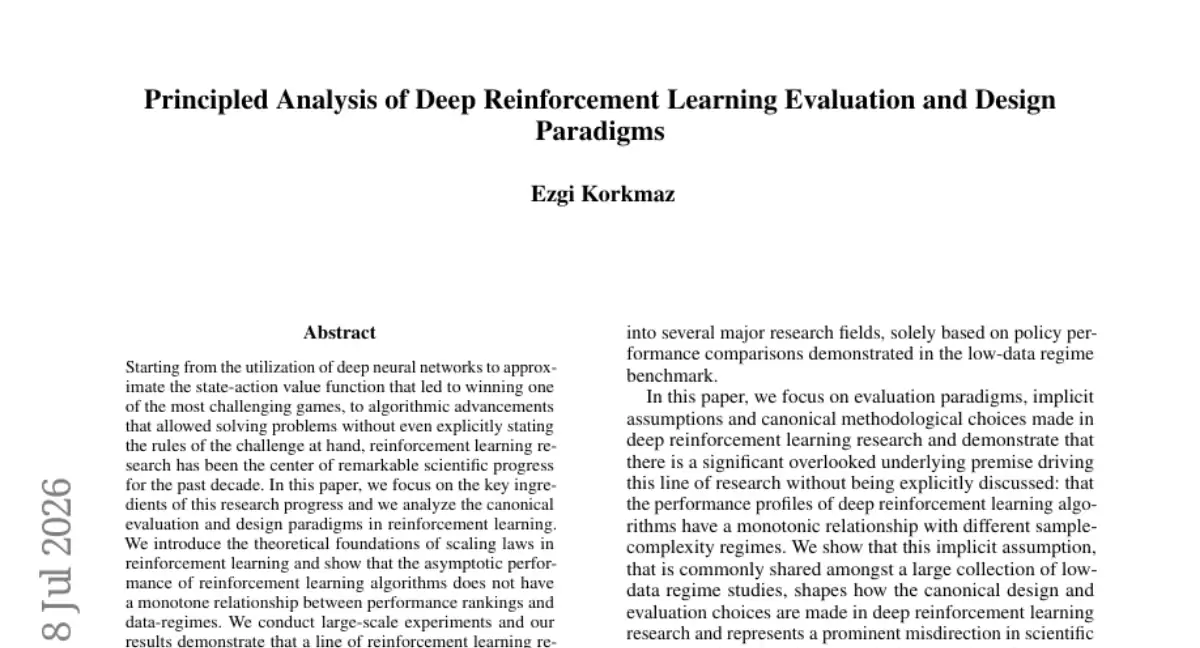
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



