

深探无监督预训练技术落地 火山语音“算法优化+工程革新”并举
长期以来,火山引擎为时下风靡的视频平台提供基于语音识别技术的智能视频字幕解决方案。简单来说,就是通过AI技术自动将视频中的语音和歌词转化成文字,辅助视频创作的功能。但伴随平台用户的快速增长以及对语言种类更加丰富多样的要求,传统采用的有监督学习技术日渐触及瓶颈,这让团队着实犯了难。众所周知,传统的有监督学习会对人工标注的有监督数据产生严重依赖,尤其在大语种的持续优化以及小语种的冷启动方面。以中文普通话和英语这样的大语种为例,尽管视频平台提供了充足的业务场景语音数据,但有监督数据达到一定规模之后,继续标注的R
长期以来,火山引擎为时下风靡的视频平台提供基于语音识别技术的智能视频字幕解决方案。简单来说,就是通过AI技术自动将视频中的语音和歌词转化成文字,辅助视频创作的功能。但伴随平台用户的快速增长以及对语言种类更加丰富多样的要求,传统采用的有监督学习技术日渐触及瓶颈,这让团队着实犯了难。
众所周知,传统的有监督学习会对人工标注的有监督数据产生严重依赖,尤其在大语种的持续优化以及小语种的冷启动方面。以中文普通话和英语这样的大语种为例,尽管视频平台提供了充足的业务场景语音数据,但有监督数据达到一定规模之后,继续标注的ROI将非常低,必然需要技术人员考虑如何有效利用百万小时级别的无标注数据,来进一步改善大语种语音识别的效果。
相对小众的语言或者方言,由于资源、人力等原因,数据的标注成本高昂。在标注数据极少的情况下(10小时量级),有监督训练的效果非常差,甚至可能无法正常收敛;而采购的数据往往和目标场景不匹配,也无法满足业务的需要。
因此,火山引擎语音团队迫切需要研究如何尽可能低标注成本的充分利用大量无标注数据,提升少量标注数据下的识别效果并落地到实际业务中。所以,无监督预训练技术成为视频平台ASR(Automatic Speech Recognition / 自动语音识别)能力向小语种推广的关键。
尽管近年来学术界在语音无监督预训练领域取得了许多重大进展,包括Wav2vec2.0[1]、HuBERT[2]等,但在工业界却鲜有落地案例可以参考借鉴。整体来看,火山语音团队认为,以下三方面原因,阻碍了无监督预训练技术的落地:
- 模型参数量大、推理开销大。大量无标注数据需要用较大的模型做无监督预训练,才能得到高质量的语音表征,但这样的模型如果直接部署到线上,会带来高昂的推理成本。
- 无监督预训练只关注语音表征的学习,需要结合大量纯文本训练的语言模型联合解码才能达到理想效果,和端到端ASR推理引擎不兼容。
- 无监督预训练开销大、周期长且不稳定。以Wav2vec2.0为例,300M参数量的模型用64张V100 GPU预训练60万步,耗时长达半个月;此外由于数据分布的差异,在业务数据上训练容易发散。
针对以上三大痛点,进行了算法改进和工程优化,形成一套完整易推广的落地方案。本文将针对方案,从落地流程、算法优化以及工程优化等环节展开详尽介绍。
落地流程
下图是无监督预训练的低资源语种ASR的落地流程,大致可以划分为数据收集、种子模型训练和模型迁移三个阶段。
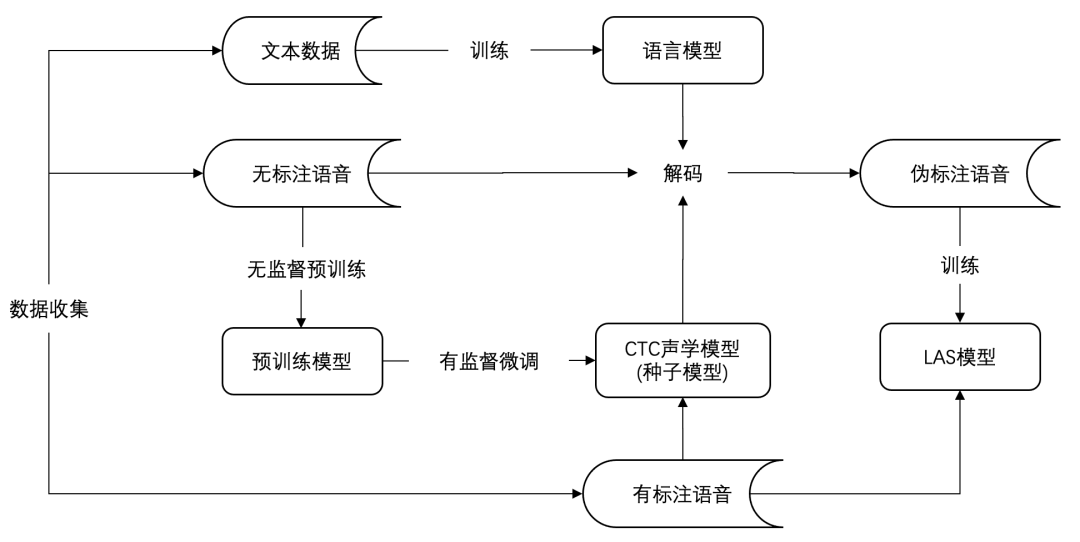
基于无监督预训练的ASR落地流程
具体来说,第一阶段的数据收集,可以通过语种分流、采购等手段收集目标语言的无标注语音、标注语音和纯文本数据。
第二阶段的种子模型训练,也就是经典的“无监督预训练+有监督微调”过程。这一阶段将得到一个声学模型,通常基于连接时序分类(Connectionist Temporal Classification, CTC[3])损失函数微调。声学模型结合纯文本训练的语言模型,构成一个完整的语音识别系统,可以取得不错的识别效果。之所以称之为种子模型,是因为这个模型并不适合直接上线到业务,火山引擎更倾向于使用LAS(Listen, Attend and Spell[4])或RNN-T(Recurrent Neural Network Transducer[5])这类端到端模型进行线上部署。
归其原因,主要是LAS/RNN-T具有出色的端到端建模能力,同时在近年来已经取得了优于传统CTC模型的效果,并在工业界得到越来越多的应用。火山引擎针对端到端语音识别模型的推理和部署做了大量优化工作,并形成一套相对成熟的方案支持众多业务。在维持效果无损的前提下,如果可以沿用端到端推理引擎,就能大幅降低引擎的运维成本。
基于此团队设计了第三阶段,即模型迁移阶段。主要借鉴知识蒸馏的思想,用种子模型对无标注数据打伪标签,然后提供一个参数量较小的LAS模型做训练,同步实现了模型结构的迁移和推理计算量的压缩。整个流程的有效性在粤语ASR上得到验证,具体实验结果如下表所示:
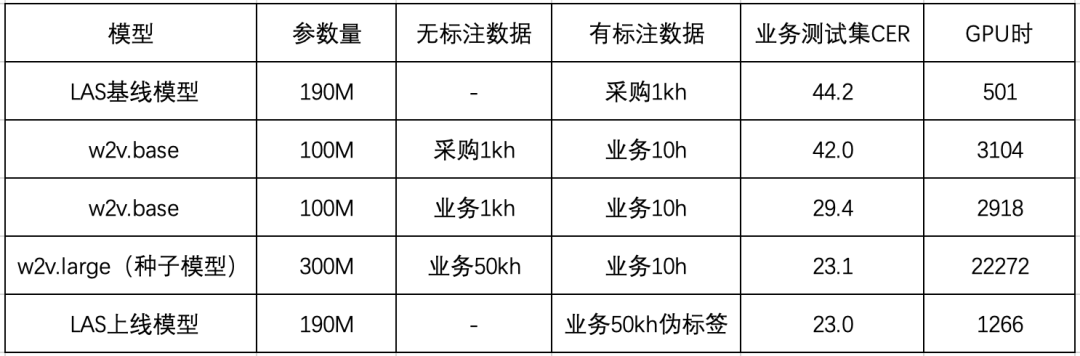
首先,团队采购了1kh成品数据用于实验对比,直接训练LAS模型性能不佳,字错率(Character Error Rate, CER)高达44.2%。经过分析,火山引擎认为主要原因是采购数据(对话)和业务测试集(视频)领域不匹配,在wav2vec2.0上的初步实验也发现了类似的现象。
相比用采购数据做预训练,火山引擎采用了和目标领域一致的数据做预训练,在业务测试集上的CER可以从42.0%下降到29.4%;将业务场景的无标注数据积累到50kh,模型参数量从100M增加到300M,CER进一步下降到23.1%。
最后火山引擎验证了模型迁移的效果,结合粤语语言模型对50kh无标注数据解码得到伪标签,训练LAS模型。可以看到,基于伪标签训练的LAS模型,基本可以保持CTC种子模型的识别效果,而且模型参数量减少了三分之一,可以直接基于成熟的端到端推理引擎部署上线。
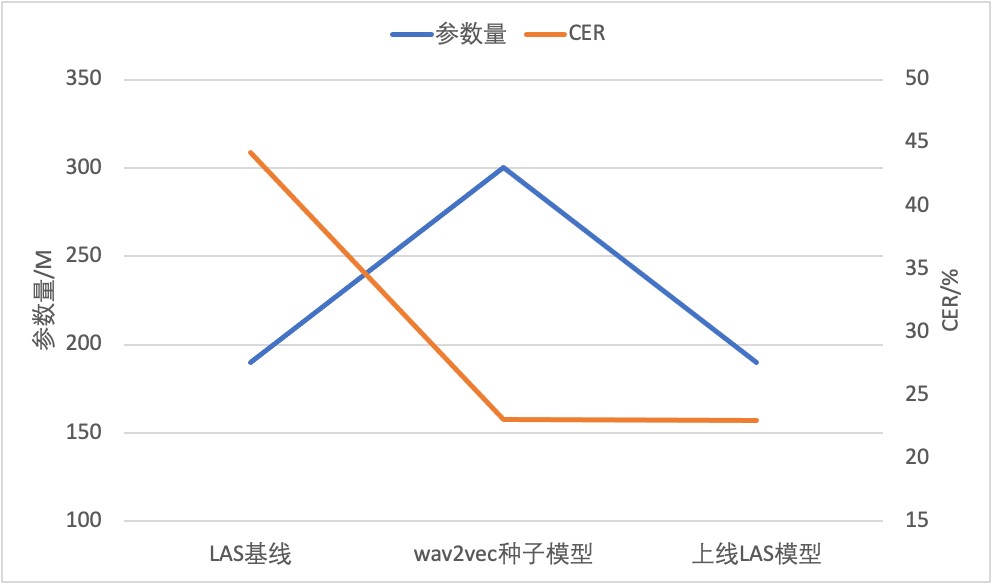
模型参数量和CER对比
最终,在模型结构和参数量不变的前提下,团队用50kh无标注业务数据和10h有标注业务数据取得了23.0%的CER,相对基线模型下降48%。在解决了线上计算量和兼容性的问题之后,聚焦到整个流程中最为核心的无监督预训练技术,针对wav2vec2.0,火山引擎分别从算法和工程两个维度进行了优化。
算法优化
wav2vec2.0作为Meta AI在2020年提出来的自监督预训练模型,开启了语音无监督表征学习的新篇章。其核心思想在于用量化模块将输入特征离散化,通过对比学习优化,模型主体与BERT类似实现随机mask部分输入特征。
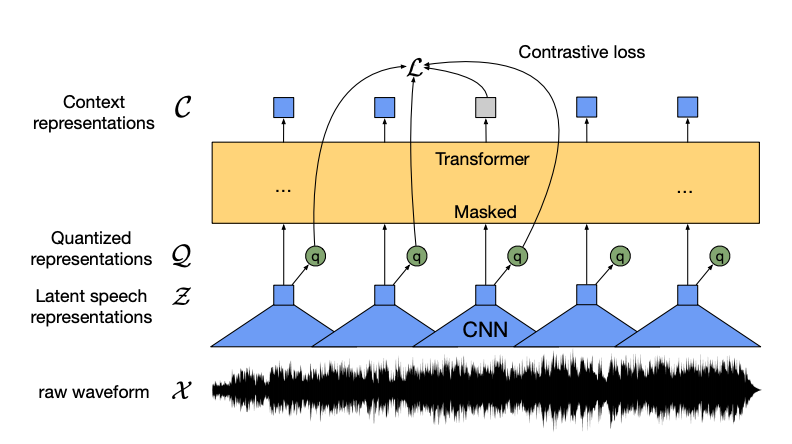
wav2vec2.0模型结构示意图(来源:wav2vec 2.0 Figure 1 [1])
在业务数据上训练wav2vec 2.0模型时还遇到了两个棘手的问题:一个是训练效率低,300M的大模型64卡需要十几天才能训完;另一个是训练不稳定,容易发散。为此火山引擎提出Efficient wav2vec以缓解上述两个问题。
对于训练效率低的问题,团队通过降低模型的帧率来加快训练速度,将输入特征从waveform替换成filterbanks,帧率由原来的20ms变成40ms。这样既大幅降低了特征提取卷积的计算量,同时也大幅降低了Transformer内部编码的长度,从而提高训练效率。对于训练不稳定的问题,则是通过分析无监督预训练的学习方式并结合业务数据实际情况综合判断解决,对比学习损失可以用下式表达:
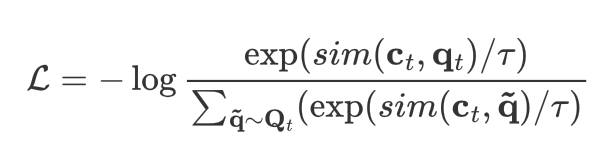
对于每一帧t,ct 表示该帧的编码器输出,qt 表示该帧的量化输出。除此之外,还需要采样若干其它帧作为负样本,从而当前帧与负样本帧的集合就相当于是动态构造的词表Qt 。
对比学习的优化目标就是最大化当前帧编码与该帧量化结果的相似度,同时最小化当前帧编码与其它帧量化结果的相似度。不难发现,负样本与正样本的相似度以及负样本个数这两点直接决定了对比学习的效果。而在实际操作中,业务数据的平均长度较短,一句话仅能提供50个负样本,是远远不够的。考虑到语音相邻帧之间的相似度很高,就需要保证mask区域的连续,从而提高表征重构的难度。
为了解决上述两个问题,火山引擎对应提出了两点改进:
- 等长数据流:预训练过程中将整个训练集视为由每句话首尾拼接而成的一段音频,每个训练样本从中截取固定长度得到。这样做是为了保证负样本数量足够多,且上下文编码网络内部的长度在不同帧率下一致,进而保证训练的稳健性。
- 自适应连续mask:为缓解数据噪音对训练的影响,选取较小的mask长度且强制每个mask区域连续,并且mask区域对应的音频长度在不同帧率下相当。这样既减轻了噪音数据下对比学习的难度,同时也做到了适配不同的帧率。
在业务数据上对比了wav2vec2.0(w2v)与 Efficient wav2vec (w2v-e)的效果后,得出下表所示结果(所有模型均采用64 V100 GPUs训练):
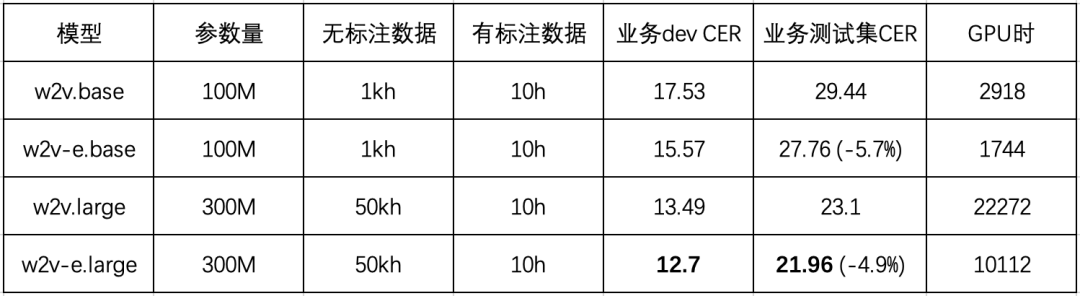
可以看到改进过的Efficient wav2vec相对原始wav2vec 2.0有稳定5%的性能提升,并且训练效率几乎翻倍。
工程优化
尽管团队提出的Efficient wav2vec已经从算法层面将训练效率提升近两倍,但由于300M模型通信量大,训练通信依然存在波动且多机扩展效率低。对此火山引擎语音团队总结道:“为了提高模型预训练在同步梯度场景下的通信效率,我们基于BytePS的分布式训练框架,在通信后端完成了Bucket分组通信优化技术,数据并行效率能取得10%的提升;同时针对模型参数定义顺序与梯度更新顺序不同造成的等待问题,还实现了自适应的参数重排(Parameter Reorder)策略。”在这些优化基础上,进一步结合梯度累加等技术,300M模型的单卡扩展效率由55.42%提升至81.83%,多机扩展效率由60.54%提升至91.13%,原来需要6.5天训完的模型现在只需要4天就可以训完,耗时缩短40%。
此外,为了支持未来探索的大模型大数据场景,火山引擎语音团队进一步完成了一系列超大规模模型的原子能力建设。首先实现了local OSS技术,在去除优化器大部分的冗余内存占用的同时,解决了机间扩展效率问题;之后在同步梯度通信上支持了bucket lazy init,减少了一倍参数量的显存占用,大幅降低显存峰值并适配显存资源紧张的超大模型场景;最后在数据并行的基础上,支持了模型并行和流水线并行,并在1B和10B模型上完成了验证和定制化支持。这一系列优化为大模型大数据的训练打下坚实基础。
目前,通过采用低资源ASR落地流程,已有两个低资源语言成功落地视频字幕和内容安全业务。除语音识别外,基于wav2vec2.0的预训练模型在其他多个下游任务上也已取得显著收益,涉及音频事件检测、语种识别、情感检测等,未来将陆续落地到视频内容安全、推荐、分析、音频分流、电商客服情感分析等相关业务中。无监督预训练技术的落地将显著降低各类音频数据的标注成本,缩短标注周期,实现对业务需求的快速响应。
总结与展望
火山引擎在实践中摸索出一套基于wav2vec2.0的低资源语种ASR落地方案,解决了推理开销大的问题,实现了与端到端引擎的无缝衔接。针对其中最核心的wav2vec2.0训练效率低和不稳定的问题,提出了Efficient wav2vec。相比wav2vec2.0,在下游任务上效果提升5%,预训练耗时缩短一半,结合工程上的优化,最终预训练耗时相比原始版本缩短70%。未来,火山引擎将在以下三个方向持续挖掘探索:
- 无监督算法升级:在wav2vec 2.0之后语音无监督预训练的研究工作如雨后春笋,团队将持续跟进最新的研究,并内化到业务场景。现阶段主要尝试了HuBERT[2]、MAE[6] 和 data2vec[7]等无监督模型,并探索了它们各自在不同下游任务下的表现。未来将从两个方面提升无监督模型性能:根据不同业务场景,设计高效适配的无监督方案;设计通用的无监督模型,提升在各类下游任务的性能表现。
- 多语言多模态:目前无监督与多语言结合的研究工作有许多,比如XLSR[8]。火山引擎在此基础上提出了S3Net[9],其通过在预训练模型中划分出多个稀疏子网络来分别对不同语言进行建模,有效缓解了不同语言之间的相互干扰(Language Interference)问题,对大语料语言有明显的性能提升效果。现有的研究工作主要集中在音频编码器端进行,而目前主流的端到端模型均采用了编码器-解码器结构,即音频文本多模态建模。团队判断单纯的音频端预训练已经不能满足端到端模型的需要,未来将在音频文本多模态预训练上进行探索工作,分别是海量非对齐音频文本与端到端模型联合建模以及纯无监督的多模态预训练。
- 大数据大模型:现有的模型在10万小时规模时其性能就接近饱和,团队在中文10万小时标注数据训练的模型基础上,利用100万小时无标注数据做NST[10]训练,在通用测试集上取得相对7%的CER下降,同时模型的泛化能力得到明显的改善,在20个领域测试集上平均CER相对下降15%。要充分吸收百万小时量级的海量数据就需要更大的模型,目前火山引擎已经在1B参数量级的模型上取得初步进展。大模型的性能上限高,随之而来的问题是落地难。为了将大模型落地到实际业务中,未来将尝试各种模型压缩方法,如矩阵分解、权重裁剪和知识蒸馏等,尽可能做到无损压缩效果。
火山语音,长期服务字节跳动各业务线的前沿语音技术通过火山引擎开放,提供行业领先的AI语音技术能力以及卓越的全栈语音产品解决方案,包括音频理解、音频合成、虚拟数字人、对话交互、音乐检索、智能硬件等。目前火山引擎的语音识别和语音合成覆盖了多种语言和方言,多篇技术论文入选各类AI顶级会议,为抖音、剪映、飞书、番茄小说、Pico等业务提供了领先的语音能力,并适用于短视频、直播、视频创作、办公以及穿戴设备等多样化场景。
参考文献
[1] Baevski, A., Zhou, Y., Mohamed, A. and Auli, M., 2020. wav2vec 2.0: A framework for self-supervised learning of speech representations. Advances in Neural Information Processing Systems, 33, pp.12449-12460.
[2] Hsu, W.N., Bolte, B., Tsai, Y.H.H., Lakhotia, K., Salakhutdinov, R. and Mohamed, A., 2021. Hubert: Self-supervised speech representation learning by masked prediction of hidden units. IEEE/ACM Transactions on Audio, Speech, and Language Processing, 29, pp.3451-3460.
[3] Graves, A., Fernández, S., Gomez, F. and Schmidhuber, J., 2006, June. Connectionist temporal classification: labelling unsegmented sequence data with recurrent neural networks. In Proceedings of the 23rd international conference on Machine learning (pp. 369-376).
[4] Chan, W., Jaitly, N., Le, Q. and Vinyals, O., 2016, March. Listen, attend and spell: A neural network for large vocabulary conversational speech recognition. In 2016 IEEE international conference on acoustics, speech and signal processing (ICASSP) (pp. 4960-4964). IEEE.
[5] Graves, A., 2012. Sequence transduction with recurrent neural networks. arXiv preprint arXiv:1211.3711.
[6] He, K., Chen, X., Xie, S., Li, Y., Dollár, P. and Girshick, R., 2022. Masked autoencoders are scalable vision learners. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 16000-16009).
[7] Baevski, A., Hsu, W.N., Xu, Q., Babu, A., Gu, J. and Auli, M., 2022. Data2vec: A general framework for self-supervised learning in speech, vision and language. arXiv preprint arXiv:2202.03555.
[8] Conneau, A., Baevski, A., Collobert, R., Mohamed, A. and Auli, M., 2020. Unsupervised cross-lingual representation learning for speech recognition. arXiv preprint arXiv:2006.13979.
[9] Lu, Y., Huang, M., Qu, X., Wei, P. and Ma, Z., 2022, May. Language adaptive cross-lingual speech representation learning with sparse sharing sub-networks. In ICASSP 2022-2022 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) (pp. 6882-6886). IEEE.
[10] Park, D.S., Zhang, Y., Jia, Y., Han, W., Chiu, C.C., Li, B., Wu, Y. and Le, Q.V., 2020. Improved noisy student training for automatic speech recognition. arXiv preprint arXiv:2005.09629.
火山引擎发布豆包2.1Pro大模型,大幅提升代码生成、智能Agent构建及多模态理解能力。同步推出视频生成模型Seedance2.5与图像模型Seedream5.0Pro,增强画面连贯性与细节表现。开放API接口,助力企业智能办公与多场景应用。
火山引擎暂无最新APP或小程序,手机用户需通过浏览器访问正式注册及使用服务。想在手机上使用火山引擎最新应用,但找不到正规下载渠道,容易误装仿冒App导致账号泄露或数据风险。安卓手机通过火山引擎正式下载App打开手机浏览器,访问火山引擎最新域名 【volcengine.com】,注意核对网址拼写,避免
火山引擎目前没有最新的手机APP,需要通过浏览器访问其官方网站https://www.volcengine.com/进行登录。登录时,点击右上角的“登录”按钮,有手机号、IAM子用户、企业联邦三种方式可供选择,普通用户推荐使用手机号登录。火山引擎没有最新手机APP,所有登录操作必须通过浏览器访问正式

欧莱雅(中国)与火山引擎达成战略合作,将豆包大模型应用于美妆内容运营、电商服务和用户互动等场景,聚焦AIGC创意内容生产、经营策略分析与消费者智能服务,实现体验跃迁、内容智造和数据深耕,推动AI从实验室走向经营一线。
安永与火山引擎签署战略合作备忘录,聚焦AI技术落地、专业服务交付及企业AI原生架构转型,通过整合资源与联合创新,共同为客户提供系统化支持,助力企业数智化升级。
字节跳动调整豆包、飞书、火山引擎组织架构,飞书与豆包产品团队合并,成立创造力服务平台整合GTM。豆包企业版内测,集成飞书生态。字节提升AItoB战略优先级,大模型业务ARR达40亿美元。
字节跳动在AI业务上又迈出了实质性的一步——这次是组织架构层面的深度调整。7月30日,据公开信息,字节跳动正在推动豆包、飞书、火山引擎这三条产品线的协同配合。具体来说,飞书的产品团队与豆包的产品团队将合并,成立一个新的“豆包产品团队”,由豆包负责人赵祺带队,飞书负责人谢欣改为向赵祺汇报。而在GTM(
7月30日,字节跳动启动了新一轮针对AI业务的组织调整,核心目标很明确:让豆包、飞书、火山引擎在企业生产力场景里,把产品和服务协同得更紧密一些。 具体怎么调?直接说重点:飞书的产品团队和豆包的产品团队合并了,成立了一个新的“豆包产品团队”,由豆包负责人赵祺来带,飞书负责人谢欣向赵祺汇报。这边是产品线

7月28日,火山引擎正式上线了豆包搜索服务。这项服务主打跨语言、多模态、多垂类联网信息查询,融合了全域互联网信息、行业专业知识以及字节跳动的独家内容资源——换句话说,它为企业与开发者构建AI Agent提供了一款更智能、更高效的信息引擎。 以下是详细内容: Agent 可信搜索:权威信息高效调用 围
最近有个消息,值得做AI应用的朋友们关注一下。7月28日,火山引擎正式上线了豆包搜索服务。简单说,就是把联网搜索能力做成了可调用的引擎——支持跨语言、多模态、多垂类的信息查询,而且融合了全域互联网信息、行业专业知识,以及字节跳动自家的一些独家内容资源。 这意味着什么?如果你正在为企业或开发者构建AI






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
