

机器学习入门必备:如何用Python从头实现感知器算法
在本教程中,你将了解到如何利用Python从头开始实现感知器算法。在完成本教程后,你将学会:如何训练感知器的网络权重如何利用感知器做出预测如何对于现实世界的分类问题实现感知器算法让我们开始吧。概述本节简要介绍了感知器算法和Sonar数据集,我们将会在后面应用。感知器算法感知器的灵感来自于被称为神经元的单个神经细胞的信息处理过程。神经元通过其树突接受输入信号,并将电信号向下传递到细胞体内。通过类似的方式,感知器从训练数据的样本中接受输入信号,训练数据被加权并在称为激活(activation)的线性方
在本教程中,你将了解到如何利用 Python 从头开始实现感知器算法。
在完成本教程后,你将学会:
- 如何训练感知器的网络权重
- 如何利用感知器做出预测
- 如何对于现实世界的分类问题实现感知器算法
让我们开始吧。
概述
本节简要介绍了感知器算法和 Sonar 数据集,我们将会在后面应用。
感知器算法
感知器的灵感来自于被称为神经元的单个神经细胞的信息处理过程。
神经元通过其树突接受输入信号,并将电信号向下传递到细胞体内。
通过类似的方式,感知器从训练数据的样本中接受输入信号,训练数据被加权并在称为激活(activation)的线性方程中进行组合。
activation = sum(weight_i * x_i) + bias
然后,使用诸如阶跃传递函数(step transfer function)的传递函数将激活变换为输出值或预测。
prediction = 1.0 if activation >= 0.0 else 0.0
以这种方式,感知器是用于具有两个类(0 和 1)的问题的分类算法,其中可以使用线性方程来分离这两个类。
它与以类似方式进行预测的线性回归和 logistic 回归密切相关(例如输入的加权和)。
感知器算法的权重必须使用随机梯度下降算法从训练数据中估计。
随机梯度下降
梯度下降是通过跟随成本函数(cost function)的梯度来最小化函数的过程。
这涉及了解成本的形式以及导数,使得从给定的点你可以知道梯度并且可以在该方向上移动,比如下坡到最小值。
在机器学习中,我们可以使用一种技术来评估和更新称为随机梯度下降的每次迭代的权重,以最小化我们的训练数据模型的误差。
这种优化算法的工作方式是每次向模型显示每个训练实例。模型对训练实例进行预测,计算误差并更新模型以便减少下一预测的误差。
该过程可以用于在模型中找到能使训练数据上模型误差最小的权重集合。
对于感知器算法,每次迭代,权重(w)使用以下等式更新:
w = w + learning_rate * (expected - predicted) * x
其中w是正在被优化的权重,learning_rate是必须配置的学习速率(例如 0.01),(expected - predicted)是在归因于权重的训练数据上的模型的预测误差,x是输入值。
数据集
我们将在本教程中使用的数据集是 Sonar 数据集。
这是一个描述了声呐啾啾叫声并返回不同服务的试探的数据集。60 个输入变量是在不同角度的返回强度。这是一个二元分类问题,需要一个模型来区分金属圆柱体和岩石。
它是一个很好理解的数据集。所有的变量是连续的,通常在 0 到 1 的范围内。因此,我们不必对输入数据进行归一化,这通常是使用感知器算法的一个好地方。输出变量是字符串「M」(表示矿 mine)和「R」(表示岩石 rock),我们需要将其转换为整数 1 和 0。
通过在数据集(M 或 Mines)中预测具有最多观测值的类,零规则算法(Zero Rule Algorithm)可以实现 53%的精度。
你可以在 UCI Machine Learning repository:
https://archive.ics.uci.edu/ml/datasets/Connectionist+Bench+(Sonar,+Mines+vs.+Rocks))中了解有关此数据集的更多信息。你也可以免费下载数据集,并将其放在工作目录中,文件名为 sonar.all-data.csv。
教程
这个教程分为三个部分:
- 作出预测
- 训练网络权重
- 将 Sonar 数据集建模
这些步骤将带给你实现和应用感知器算法到你自己的分类预测建模问题的基础。
1. 作预测
第一步是开发一个可以进行预测的函数。
这将会需要在随机梯度下降中的候选权重值的评估以及在模型被最终确定之后,我们希望开始对测试数据或新数据进行预测。
下面是一个名为 predict() 的函数,用于预测给定一组权重的行的输出值。
第一个权重始终是偏差,因为它是独立的,不负责特定的输入值。
# Make a prediction with weights
def predict(row, weights):
 activation = weights[0]
 for i in range(len(row)-1):
activation += weights[i + 1] * row[i]
 return 1.0 if activation >= 0.0 else 0.0
我们可以设计一个小数据集来测试我们的预测函数。
X1 X2 Y
2.78108362.5505370030
1.4654893722.3621250760
3.3965616884.4002935290
1.388070191.8502203170
3.064072323.0053059730
7.6275312142.7592622351
5.3324412482.0886267751
6.9225967161.771063671
8.675418651-0.2420686551
7.6737564663.5085630111
我们也可以使用之前准备好的权重来为这个数据集做预测。
将所有这些集中起来,我们就可以测试我们的 predict() 函数了,如下:
# Make a prediction with weights
def predict(row, weights):
 activation = weights[0]
 for i in range(len(row)-1):
activation += weights[i + 1] * row[i]
 return 1.0 if activation >= 0.0 else 0.0

# test predictions
dataset = [[2.7810836,2.550537003,0],
 [1.465489372,2.362125076,0],
 [3.396561688,4.400293529,0],
 [1.38807019,1.850220317,0],
 [3.06407232,3.005305973,0],
 [7.627531214,2.759262235,1],
 [5.332441248,2.088626775,1],
 [6.922596716,1.77106367,1],
 [8.675418651,-0.242068655,1],
 [7.673756466,3.508563011,1]]
weights = [-0.1, 0.20653640140000007, -0.23418117710000003]
for row in dataset:
 prediction = predict(row, weights)
 print("Expected=%d, Predicted=%d" % (row[-1], prediction))
该函数有两个输入值 X1、X2 和三个权重参数 bias、w1 及 w2。该问题的激活函数有如下的形式:
activation = (w1 * X1) + (w2 * X2) + bias
或者,我们能够手动地选择权重值:
activation = (0.206 * X1) + (-0.234 * X2) + -0.1
运行这个函数,我们将会得到与期望输出值 (y) 相符合的预测值。
Expected=0, Predicted=0
Expected=0, Predicted=0
Expected=0, Predicted=0
Expected=0, Predicted=0
Expected=0, Predicted=0
Expected=1, Predicted=1
Expected=1, Predicted=1
Expected=1, Predicted=1
Expected=1, Predicted=1
Expected=1, Predicted=1
现在,我们已经准备好使用随机梯度下降法(SGD)来最优化我们的权重值。
2. 训练神经权重
我们可以使用 SGD,来估计出对于训练集的权重值。
SGD 有两个参数:
- 学习率(Learning Rate):用来限制每次更新中权重项修正值的大小。
- 迭代次数(Epochs):在训练集上训练同时更新权重项的次数。
这两个参数,和训练集一起,都将会是预测函数的输入参数。
在这个函数中,我们需要运行三个循环:
- 对于每次迭代进行循环;
- 对于一次迭代中,训练集的每一行进行循环;
- 对于每一行中,每一个值进行循环。
如你所见,我们在每一次迭代中,对训练集每一行中每一个权值都进行更新。
我们基于现有情况模型预测的「误差」,来对权重值进行更新。误差,是由候选权值计算出来的预测值与(数据集中的)期望值的差。
对每一个输入属性,都有一个权重值,并且这些权_重值都连续更新_。如:
w(t+1)= w(t) + learning_rate * (expected(t) - predicted(t)) * x(t)
偏差项以一种相似的方式更新,不过因为它本身就不与特定的输入值有关,因而在式子中没有输入值的项。
bias(t+1) = bias(t) + learning_rate * (expected(t) - predicted(t))
现在,我们把所有的内容组合到一起。如下所示,在 train_weights() 函数中,它使用 SGD 方法,计算对于给定训练集的权重值。
# Estimate Perceptron weights using stochastic gradient descent
def train_weights(train, l_rate, n_epoch):
 weights = [0.0 for i in range(len(train[0]))]
 for epoch in range(n_epoch):
sum_error = 0.0
for row in train:
 prediction = predict(row, weights)
 error = row[-1] - prediction
 sum_error += error**2
 weights[0] = weights[0] + l_rate * error
 for i in range(len(row)-1):
weights[i + 1] = weights[i + 1] + l_rate * error * row[i]
print('>epoch=%d, lrate=%.3f, error=%.3f' % (epoch, l_rate, sum_error))
 return weights
如你所见,我们也在每次迭代中,记录下了平方误差之和(这始终是一个正值)。因而我们能在外循环的每次迭代中,print 一些有用的信息。
我们也可以在我们上面创建的小规模数据集上,对该函数进行测试。
# Make a prediction with weights
def predict(row, weights):
 activation = weights[0]
 for i in range(len(row)-1):
activation += weights[i + 1] * row[i]
 return 1.0 if activation >= 0.0 else 0.0

# Estimate Perceptron weights using stochastic gradient descent
def train_weights(train, l_rate, n_epoch):
 weights = [0.0 for i in range(len(train[0]))]
 for epoch in range(n_epoch):
sum_error = 0.0
for row in train:
 prediction = predict(row, weights)
 error = row[-1] - prediction
 sum_error += error**2
 weights[0] = weights[0] + l_rate * error
 for i in range(len(row)-1):
weights[i + 1] = weights[i + 1] + l_rate * error * row[i]
print('>epoch=%d, lrate=%.3f, error=%.3f' % (epoch, l_rate, sum_error))
 return weights

# Calculate weights
dataset = [[2.7810836,2.550537003,0],
 [1.465489372,2.362125076,0],
 [3.396561688,4.400293529,0],
 [1.38807019,1.850220317,0],
 [3.06407232,3.005305973,0],
 [7.627531214,2.759262235,1],
 [5.332441248,2.088626775,1],
 [6.922596716,1.77106367,1],
 [8.675418651,-0.242068655,1],
 [7.673756466,3.508563011,1]]
l_rate = 0.1
n_epoch = 5
weights = train_weights(dataset, l_rate, n_epoch)
print(weights)
我们将使用 0.1 的学习率和 5 次迭代,也就是把参数在训练集上更新五次,来训练这个模型。
运行这个案例,它将会在每一次迭代结束后,显示出该次迭代后的平方误差和,并在完成所有迭代后,显示最后的权重集。
>epoch=0, lrate=0.100, error=2.000
>epoch=1, lrate=0.100, error=1.000
>epoch=2, lrate=0.100, error=0.000
>epoch=3, lrate=0.100, error=0.000
>epoch=4, lrate=0.100, error=0.000
[-0.1, 0.20653640140000007, -0.23418117710000003]
你可以看到,这个算法很快学会了「解决」这个问题。
现在我们来试试看,如何在一个实际的数据集上应用这个算法。
3. 对声纳数据集进行建模
在这一节中,我们将使用 SGD 方法,对一个声纳数据集,训练一个感知器模型。
在该例子中,我们假定,在当前的工作目录下,有一名为sonar.all-data.csv 的文件,存储着该数据集。
首先该数据集被载入。数据集中字符串格式的数据被转换为数值型,同时输出值从字符串被转换了 0 或 1 的两个整数值。
通过 load_csv(), str_column_to_float()及str_column_to_int() 三个函数,我们实现了对数据集的读取及预处理。
我们使用「k 倍交叉验证法」(k-fold cross validation)来对学习后的模型在未知数据集上的表现进行评估。也就是说,我们需要建立 k 个模型并估计各模型的平均误差。分类准确性将被用于模型的评估工作中。这些工作在 cross_validation_split(), accuracy_metric() 及 evaluate_algorithm() 函数中被完成。
我们将会使用上面设置的 predict() 和 **train_weights()**函数来训练该模型。同时,我们将会用一个新函数 perceptron() 来将它们组合在一起。如下是完整的例子。
# Perceptron Algorithm on the Sonar Dataset
from random import seed
from random import randrange
from csv import reader

# Load a CSV file
def load_csv(filename):
 dataset = list()
 with open(filename, 'r') as file:
csv_reader = reader(file)
for row in csv_reader:
 if not row:
continue
 dataset.append(row)
 return dataset

# Convert string column to float
def str_column_to_float(dataset, column):
 for row in dataset:
row[column] = float(row[column].strip())

# Convert string column to integer
def str_column_to_int(dataset, column):
 class_values = [row[column] for row in dataset]
 unique = set(class_values)
 lookup = dict()
 for i, value in enumerate(unique):
lookup[value] = i
 for row in dataset:
row[column] = lookup[row[column]]
 return lookup

# Split a dataset into k folds
def cross_validation_split(dataset, n_folds):
 dataset_split = list()
 dataset_copy = list(dataset)
 fold_size = int(len(dataset) / n_folds)
 for i in range(n_folds):
fold = list()
while len(fold) < fold_size:
 index = randrange(len(dataset_copy))
 fold.append(dataset_copy.pop(index))
dataset_split.append(fold)
 return dataset_split

# Calculate accuracy percentage
def accuracy_metric(actual, predicted):
 correct = 0
 for i in range(len(actual)):
if actual[i] == predicted[i]:
 correct += 1
 return correct / float(len(actual)) * 100.0

# Evaluate an algorithm using a cross validation split
def evaluate_algorithm(dataset, algorithm, n_folds, *args):
 folds = cross_validation_split(dataset, n_folds)
 scores = list()
 for fold in folds:
train_set = list(folds)
train_set.remove(fold)
train_set = sum(train_set, [])
test_set = list()
for row in fold:
 row_copy = list(row)
 test_set.append(row_copy)
 row_copy[-1] = None
predicted = algorithm(train_set, test_set, *args)
actual = [row[-1] for row in fold]
accuracy = accuracy_metric(actual, predicted)
scores.append(accuracy)
 return scores

# Make a prediction with weights
def predict(row, weights):
 activation = weights[0]
 for i in range(len(row)-1):
activation += weights[i + 1] * row[i]
 return 1.0 if activation >= 0.0 else 0.0

# Estimate Perceptron weights using stochastic gradient descent
def train_weights(train, l_rate, n_epoch):
 weights = [0.0 for i in range(len(train[0]))]
 for epoch in range(n_epoch):
for row in train:
 prediction = predict(row, weights)
 error = row[-1] - prediction
 weights[0] = weights[0] + l_rate * error
 for i in range(len(row)-1):
weights[i + 1] = weights[i + 1] + l_rate * error * row[i]
 return weights

# Perceptron Algorithm With Stochastic Gradient Descent
def perceptron(train, test, l_rate, n_epoch):
 predictions = list()
 weights = train_weights(train, l_rate, n_epoch)
 for row in test:
prediction = predict(row, weights)
predictions.append(prediction)
 return(predictions)

# Test the Perceptron algorithm on the sonar dataset
seed(1)
# load and prepare data
filename = 'sonar.all-data.csv'
dataset = load_csv(filename)
for i in range(len(dataset[0])-1):
 str_column_to_float(dataset, i)
# convert string class to integers
str_column_to_int(dataset, len(dataset[0])-1)
# evaluate algorithm
n_folds = 3
l_rate = 0.01
n_epoch = 500
scores = evaluate_algorithm(dataset, perceptron, n_folds, l_rate, n_epoch)
print('Scores: %s' % scores)
print('Mean Accuracy: %.3f%%' % (sum(scores)/float(len(scores))))
在交叉验证中,我们取 k 为 3——也就是对每一块数据,都有 208/3 约 70 个记录,会在每次迭代中被用于计算。我们取 0.1 的学习率及 500 的训练迭代次数,来训练模型。
你可以尝试你自己的参数,并且看看你的结果能否战胜我的分数。运行这个例子,将会显示对 3 倍交叉验证中每一块的分数,以及平均的分类正确率。
我们可以看到,这个正确率约为 73%,高于由仅考虑主要类的零规则算法(Zero Rule Algorithm)得到的 50% 的正确率基准值。
Scores: [76.81159420289855, 69.56521739130434, 72.46376811594203]
Mean Accuracy: 72.947%

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
6月29日,中科院计算机网络信息中心等单位发布“异算方舟”国产计算系统软件生态全栈平台。该平台针对算法供给不足、代码迁移困难、智能应用落地慢三大痛点,打造九衍枢算法库、无界BoundX代码转换大模型、Agent-HiReFlow自动化仿真智能体三大能力,提供从底层算法到代码适配再到智能应用的一体化解决方案。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
熵基科技发布HuggingZKT算法商城,面向空间智能领域打造端云协同AI算法管理平台,覆盖算法训练、发布、订阅、升级等全生命周期,形成开放高效的算法服务体系,推动园区、楼宇等场景的AI能力敏捷调用,助力空间智能规模化应用迈入新阶段。

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
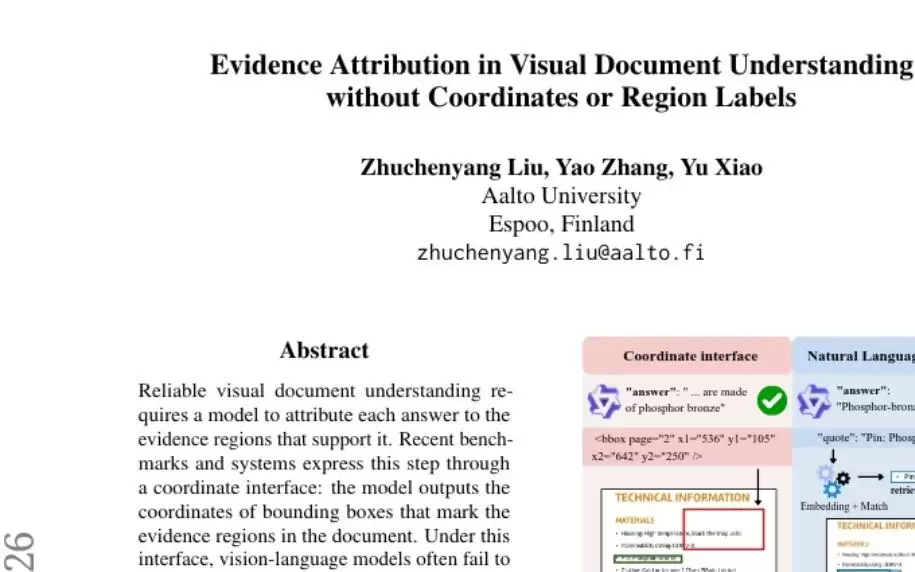
芬兰阿尔托大学提出用语言引用原文代替坐标定位,解决视觉文档理解中的归因幻觉问题。实验显示,该方法使归因幻觉率从97%降至28%,证据召回率从个位数提升至50%以上,且答案质量几乎不变。
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
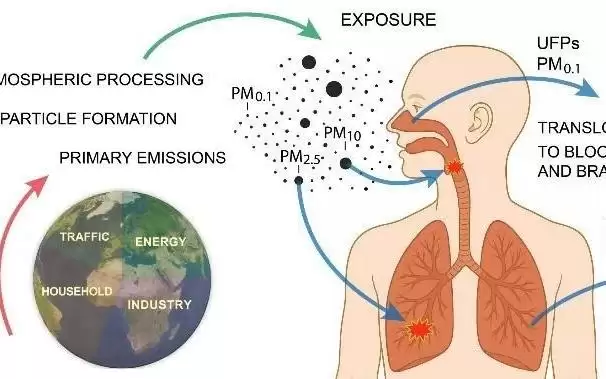
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



