

谷歌为1000+「长尾」语言创建机器翻译系统,已支持部分小众语言
过去十年,学术和商业机器翻译系统(MT)的质量已经得到了大幅度的提升。这些提升很大程度上得益于机器学习的进展和可用的大规模web挖掘数据集。同时,深度学习(DL)和E2E模型的出现、从web挖掘得到的大型并行单语言数据集、回译和自训练等数据增强方法以及大规模多语言建模等带来了能够支持超过100种语言的高质量机器翻译系统。然而,虽然低资源机器翻译出现了巨大进展,但已经构建广泛可用且通用的机器翻译系统的语言被限制在了大约100种,显然它们只是当今全世界使用的7000多种语言中的一小部分
过去十年,学术和商业机器翻译系统(MT)的质量已经得到了大幅度的提升。这些提升很大程度上得益于机器学习的进展和可用的大规模 web 挖掘数据集。同时,深度学习(DL)和 E2E 模型的出现、从 web 挖掘得到的大型并行单语言数据集、回译和自训练等数据增强方法以及大规模多语言建模等带来了能够支持超过 100 种语言的高质量机器翻译系统。
然而,虽然低资源机器翻译出现了巨大进展,但已经构建广泛可用且通用的机器翻译系统的语言被限制在了大约 100 种,显然它们只是当今全世界使用的 7000 多种语言中的一小部分。除了语言数量受限之外,当前机器翻译系统所支持的语言的分布也极大地向欧洲语言倾斜。
我们可以看到,尽管人口众多,但非洲、南亚和东南亚所说的语言以及美洲土著语言相关的服务却较少。比如,谷歌翻译支持弗里西亚语、马耳他语、冰岛语和柯西嘉语,以它们为母语的人口均少于 100 万。相比之下,谷歌翻译没有提供服务的比哈尔方言人口约为 5100 万、奥罗莫语人口约为 2400 万、盖丘亚语人口约为 900 万、提格里尼亚语人口约为 900 万(2022 年)。这些语言被称为「长尾」语言,数据缺乏需要应用一些可以泛化到拥有充足训练数据的语言之外的机器学习技术。
构建这些长尾语言的机器翻译系统在很大程度上受到可用数字化数据集和语言识别(LangID)模型等 NLP 工具缺失的限制。这些对高资源语言来说却是无处不在的。
在近日谷歌一篇论文《Building Machine Translation Systems for the Next Thousand Languages》中,二十几位研究者展示了他们努力构建支持超过 1000 种语言的实用机器翻译系统的成果。
论文地址:https://arxiv.org/pdf/2205.03983.pdf
具体而言,研究者从以下三个研究领域描述了他们的成果。
第一,通过用于语言识别的半监督预训练以及数据驱动的过滤技术,为 1500 + 语言创建了干净、web 挖掘的数据集。
第二,通过用于 100 多种高资源语言的、利用监督并行数据训练的大规模多语言模型以及适用于其他 1000+ 语言的单语言数据集,为服务水平低下的语言创建了切实有效的机器翻译模型。
第三,研究这些语言的评估指标存在哪些局限,并对机器翻译模型的输出进行定性分析,并重点关注这类模型的几种常见的误差模式。
对于致力于为当前研究不足的语言构建机器翻译系统的从业者,研究者希望这项工作可以为他们提供有用的洞见。此外,研究者还希望这项工作可以引领人们聚焦那些弥补数据稀疏设置下大规模多语言模型弱点的研究方向。
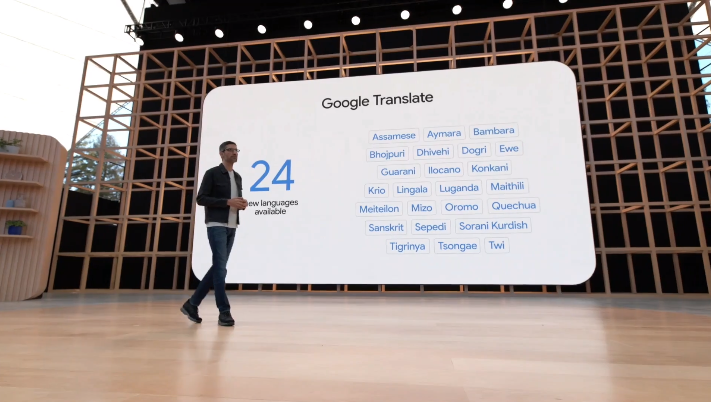
在 5 月 12 日的 I/O 大会上,谷歌宣布自家的翻译系统新增了 24 种新的语言,其中包括一些小众的美洲原住民语言,比如前文提到的比哈尔方言、奥罗莫语、盖丘亚语和提格里尼亚语。
论文概述
这项工作主要分为四大章节展开,这里只对每个章节的内容进行简要介绍。
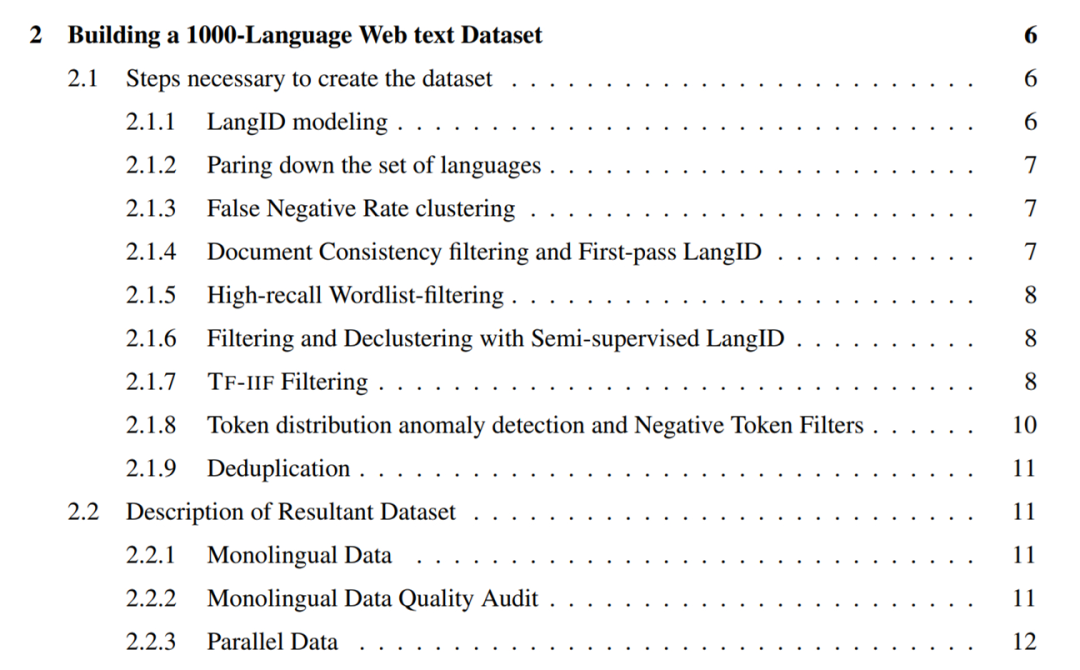
创建一个 1000-language 的 web 文本数据集
本章详细介绍了研究者在为 1500 + 语言爬取单语言文本数据集的过程中采用的方法。这些方法重点在于恢复高精度数据(即高比例的干净、语言内文本),因此很大一部分是各种各样的过滤方法。
总的来说,研究者采用的方法包括如下:
- 从 LangID 模型中删除训练数据质量和 LangID 性能差的语言,并训练一个 1629-language 的 CLD3 LangID 模型和半监督 LangID(SSLID)模型;
- 按语言在 CLD3 模型中的误差率进行聚类操作;
- 使用 CLD3 模型执行第一轮 web 爬取;
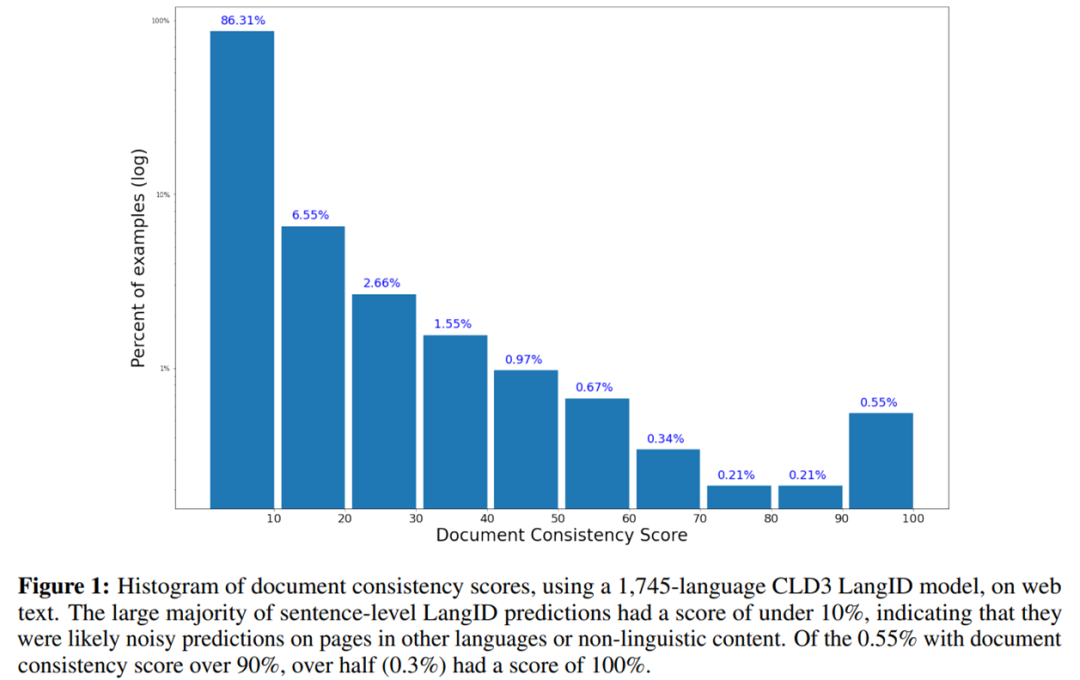
- 使用文档一致性过滤句子;
- 使用百分比阈值字列表过滤所有语料库;
- 使用半监督 LangID(SSLID)过滤所有语料库;
- 使用相对召回率检测异常值语言,并使用词频 - 逆文档频率(Term-Frequency-Inverse-Internet-Frequency, TF-IIF)进行过滤;
- 使用 Token-Frequency Anomalousness 分数检测异常值语言,并为它们手动设计过滤器;
- 在句子层面对所有语料库进行消重操作。
如下为使用 1745-language 的 CLD3 LangID 模型在 web 文本上的文档一致性得分直方图。
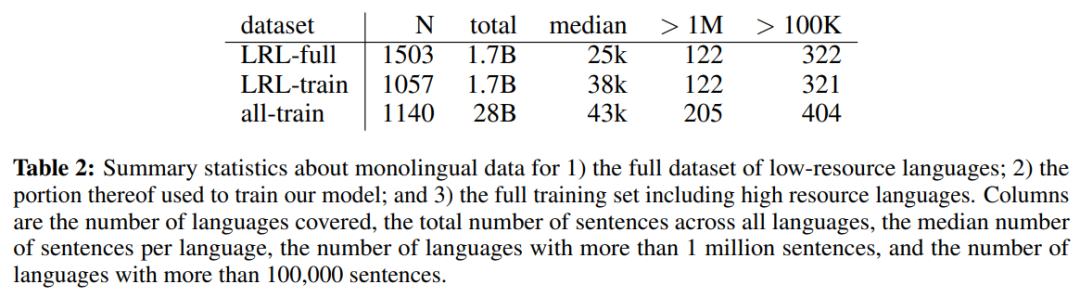
下表 2 为低资源语言(LRL)完整数据集的单语言数据、用于训练模型的部分单语言数据以及包括高资源语言在内的完整训练集的单语言数据统计。
章节目录如下:
为长尾语言构建机器翻译模型
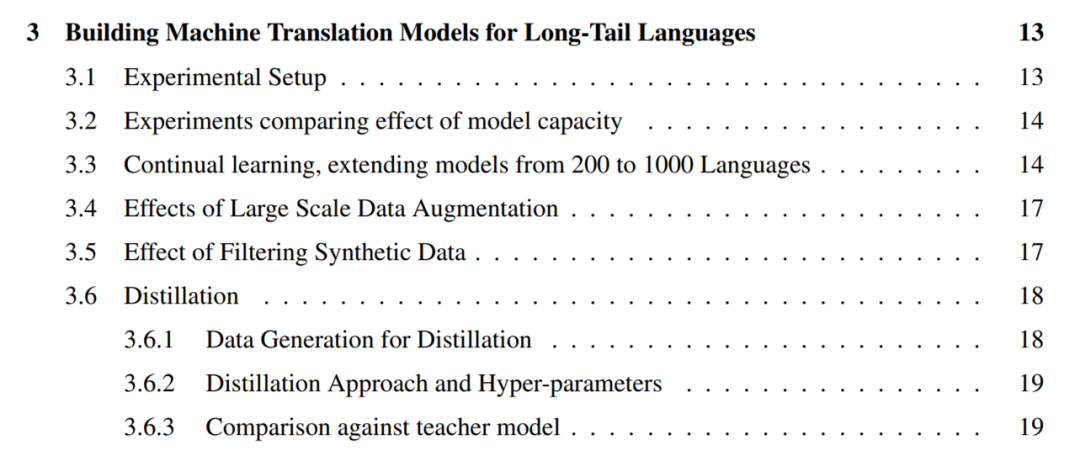
对于从 web 挖掘的单语言数据,下一个挑战是从数量有限的单语言训练数据中创建高质量的通用机器翻译模型。为此,研究者采用了这样一种实用方法,即利用所有可用于更高资源语言的并行数据来提升只有单语言数据可用的长尾语言的质量。他们将这一设置称为「零资源」(zero-resource),这是因为长尾语言没有直接的监督。
研究者利用过去几年为机器翻译开发的几种技术来提升长尾语言零资源翻译的质量。这些技术包括从单语言数据中进行自监督学习、大规模多语言监督学习、大规模回译和自训练、高容量模型。他们利用这些工具创建了能够翻译 1000 + 种语言的机器翻译模型,并利用现有覆盖大约 100 种语言的并行语料库和从 web 中构建的 1000-language 的单语言数据集。
具体地,研究者首先通过比较 15 亿和 60 亿参数 Transformers 在零资源翻译上的性能来强调模型容量在高度多语言模型中的重要性(3.2),然后将自监督语言的数量增加到 1000 种,验证了随着来自相似语言中更多单语言数据变得可用,大多数长尾语言的性能也相应提高(3.3)。虽然研究者的 1000-language 模型表现出了合理的性能,但为了了解使用方法的优点和局限性,他们融入了大规模数据增强。
此外,研究者通过自训练和回译对包含大量合成数据的 30 种语言的子集上的生成模型进行微调(3.4)。他们进一步描述了过滤合成数据的实用方法以增强这些微调模型对幻觉(hallucinations)和错误语言翻译的稳健性(3.5)。
研究者还使用序列级蒸馏将这些模型提炼成更小、更易于推理的架构,并强调了教师和学生模型之间的性能差距(3.6)。
章节目录如下:
评估
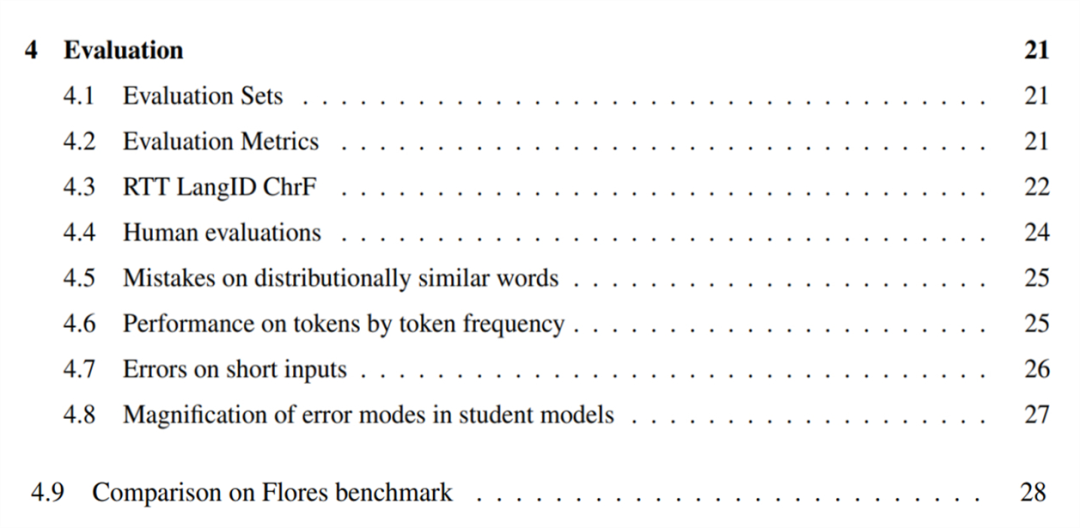
为了评估自己的机器翻译模型,研究者首先将英文句子翻译成了这些语言,为选择的 38 种长尾语言构建了一个评估集(4.1)。他们强调了 BLEU 在长尾设置中的局限性,并使用 CHRF 评估这些语言(4.2)。
研究者还提出了一个近似的、基于往返(round-trip)翻译的无参考指标,用来了解模型在参考集不可用的语言上的质量,并报告了以该指标衡量的模型的质量(4.3)。他们对模型在 28 种语言的子集上进行人工评估并报告了结果,确认可以按照文中描述的方法构建有用的机器翻译系统(4.4)。
为了了解大规模多语言零资源模型的弱点,研究者在几种语言上进行了定性误差分析。结果发现,模型经常混淆在分布上相似的单词和概念,比如「老虎」变成了「小型鳄鱼」(4.5)。并且在更低资源的设置下(4.6),模型翻译 tokens 的能力在出现频率降低的 tokens 上下降。
研究者还发现,这些模型通常无法准确地翻译短的或者单个单词输入(4.7)。对提炼模型的研究结果表明,所有模型都更有可能放大训练数据中存在的偏见或噪声(4.8)。
章节目录如下:
额外的实验和注释
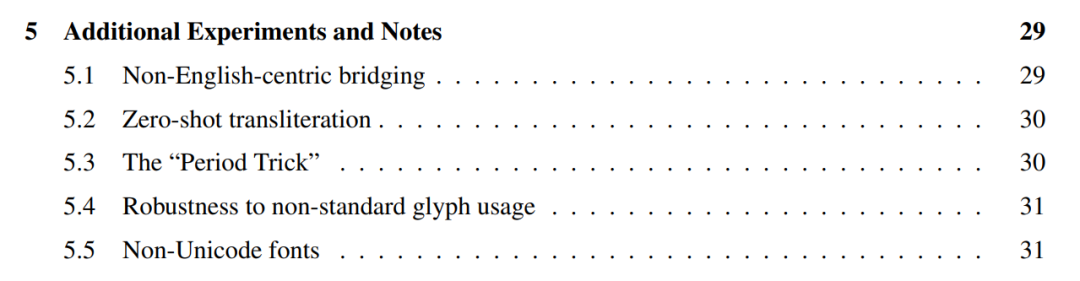
研究者对上述模型进行了一些额外的实验,表明它们在相似语言之间直接进行翻译通常效果更好,而不使用英语作为支点(5.1),并且它们可以用于不同 scripts 之间的零样本音译(5.2)。
他们描述了一种将终端标点符号附加到任何输入的实用技巧,称为「句号技巧」(period trick),可以用它来提升翻译质量(5.3)。
此外,研究者还证明了这些模型对一些而不是所有语言的非标准 Unicode 字形使用都是稳健的(5.4),并探索了几种 non-Unicode 字体(5.5)。
章节目录如下:
想要了解更多研究细节,请参考原论文。
手机早已成为中青年人的标配,不同年龄段对手机的需求其实差别不小。iPhone 15 Plus 作为当前热度颇高的机型,功能与服务覆盖得相当全面,能满足各类用户的需求。不过,有个实用问题很多人都会遇到——怎么把照片传到电脑上?今天就把两种主流方法掰开揉碎讲清楚,看完你就知道该怎么操作了。 方法一:数据
谷歌正式推送安卓17系统,首批覆盖Pixel6至10系列共21款机型。新功能包括长按应用气泡菜单、应用内存限制机制、精确/大致定位权限选择,以及遗失设备追踪的FindHub功能,进一步优化隐私与设备管理体验。
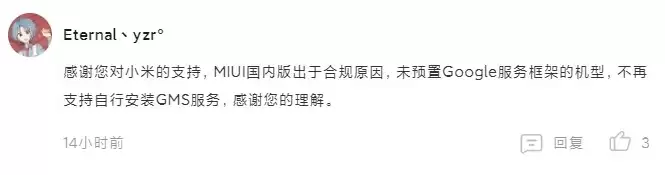
这几天,一些MIUI用户发现手机装不上谷歌GMS(谷歌移动服务)了。这事儿怎么说呢?小米社区里,多位认证为解答组的人员给出了统一回复:国内版MIUI出于合规原因,没有预置Google服务框架的机型,以后不再支持用户自己安装GMS服务。解答组还贴心地补了一句——如果真要用,可以去酷安搜相关教程。 受影
微软Edge浏览器计划于2026年7月直接支持谷歌账号登录,用户无需微软账号即可跨设备同步浏览器数据。此举为偏好Edge但不想使用微软账号的用户提供原生单点登录体验,无需再走间接路径。
小米MIXFold3未预装谷歌服务,需手动安装:先下载谷歌服务框架并开启未知来源,再安装GooglePlay商店并登录账号。但设备不支持完整GMS,部分应用可能有兼容性问题。
多机构研究发现,深度研究智能体在跨语言场景存在致命盲点:证据与问题语言不一致时,AI正确率从64.70%降至42.29%,检索召回率降20个百分点,且更盲目自信。即便提供翻译后的正确证据,表现仍不及英文,暴露检索与理解双重瓶颈。
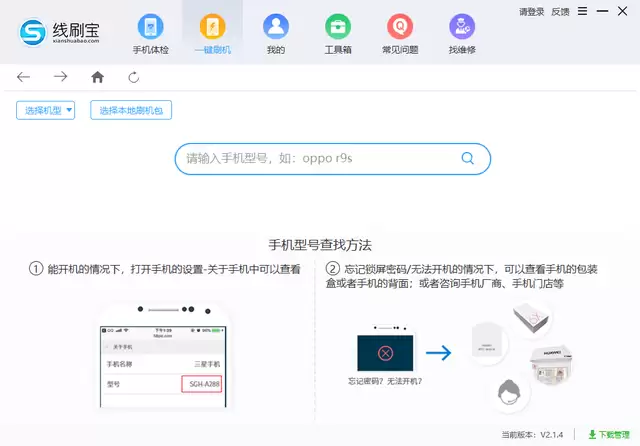
安卓手机忘记密码时,可通过三种方式解锁:一、开启USB调试后,用ADB命令删除密码文件;二、连续错误输入五次,利用绑定的谷歌账号重置;三、使用刷机软件清除锁屏密码。
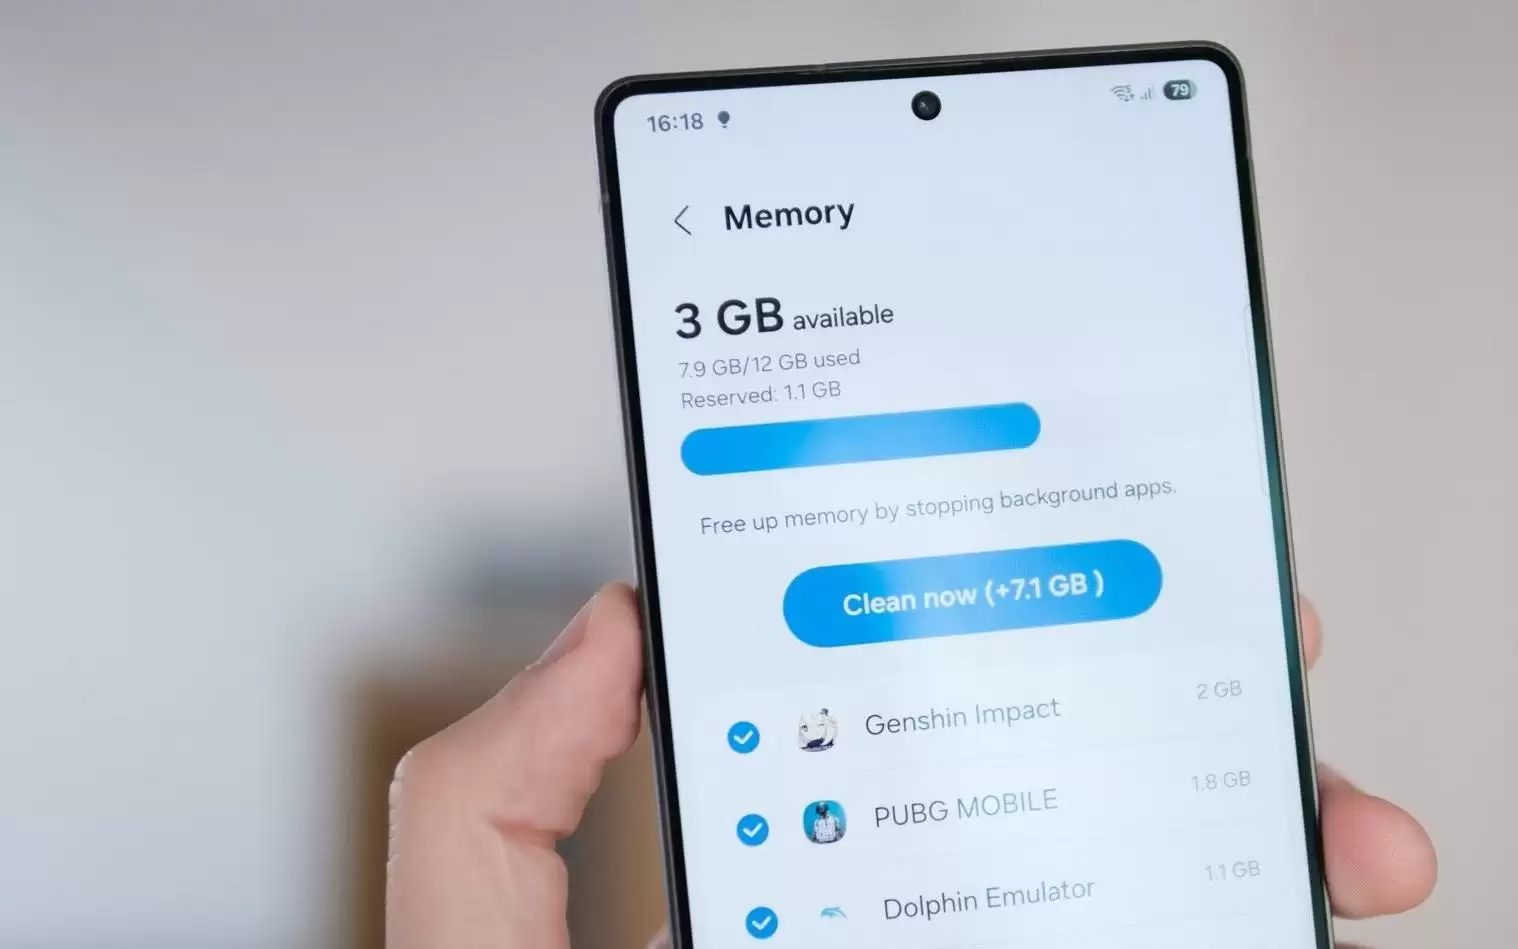
安卓17引入四项重要安全改进:包括主动终止内存异常应用、新增本地网络权限防止设备扫描、强制动态加载库只读防止恶意注入、默认启用证书透明度防止伪造证书,全面提升系统安全。
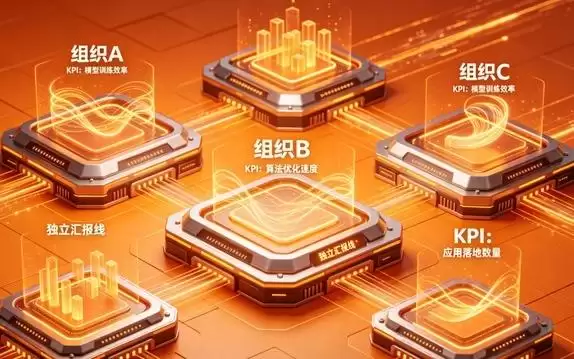
不到一周内,谷歌两位核心人物诺姆·沙泽尔与约翰·江珀相继离职。谷歌在AIAgent领域明显落后,产品线混乱,Antigravity2.0表现差强人意。尽管评测分数领先,但任务交付能力不足,组织架构的割裂是根本原因。
谷歌与加州大学圣地亚哥分校利用2000台退役Pixel手机,去除电池和外壳后组成分布式服务器集群。该方案将手机主板分组联网,提供边缘计算能力,缓解算力与存储短缺,但受限于可靠性和维护成本,无法替代传统数据中心。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
