

Meta 版 Sora 无预警来袭!抛弃扩散模型,音视频生成 / 画面编辑全包,92 页论文无保留公开
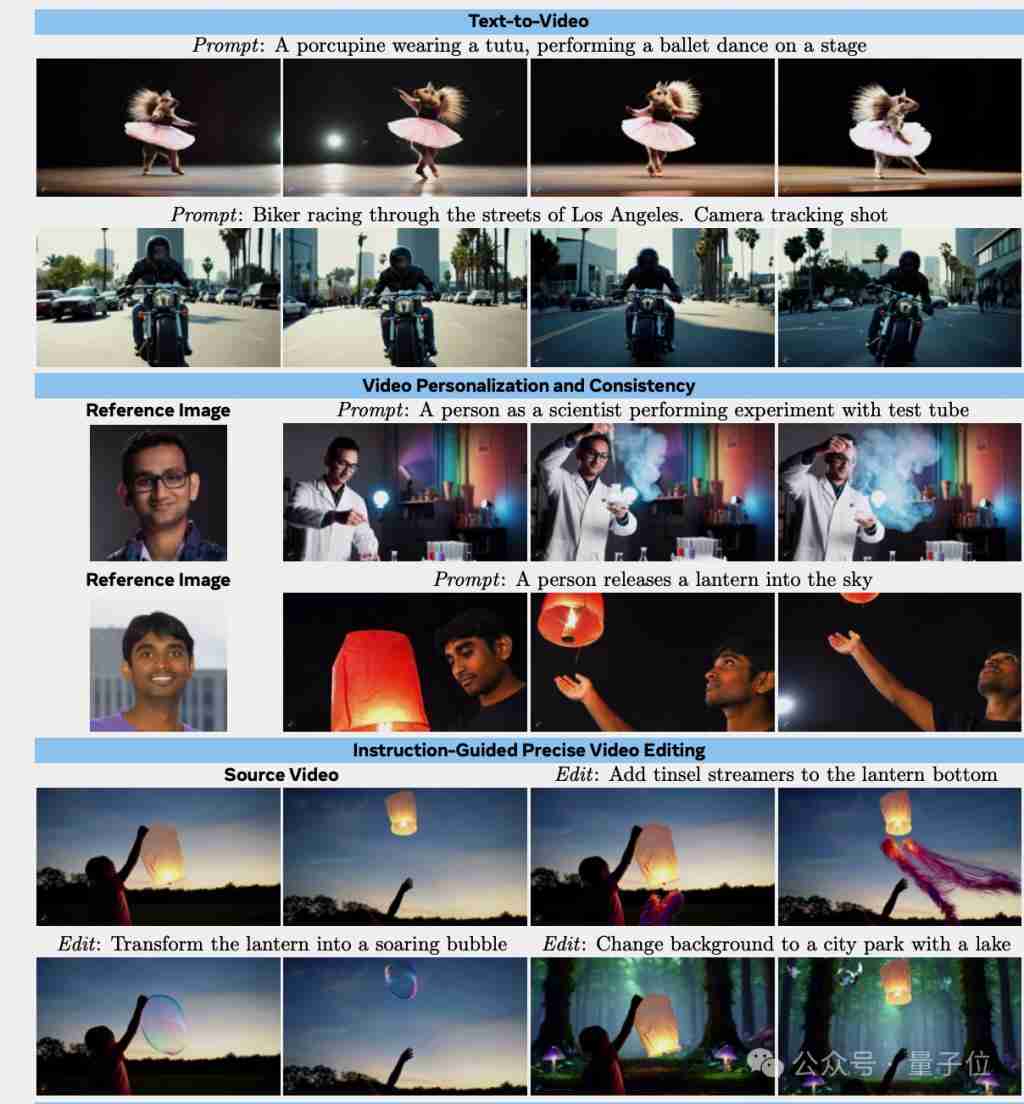
刚刚,Meta抢在OpenAI之前推出自己的Sora——MetaMovieGenSora有的它都有,可创建不同宽高比的高清长视频,支持1080p、16秒、每秒16帧。Sora没有的它还有,能生成配套的背景音乐和音效、根据文本指令编辑视频,以及根据用户上传的图像生成个性化视频。Meta表示,这是"迄今为止最先进的媒体基础模型(MediaFoundationModels)"。只需一句"把灯笼变成飞向空中的泡泡",就能替换视频中的物体,同时透明的泡泡正确反射了背景环境。上传一张自己的照片,就能成为AI电影的主角
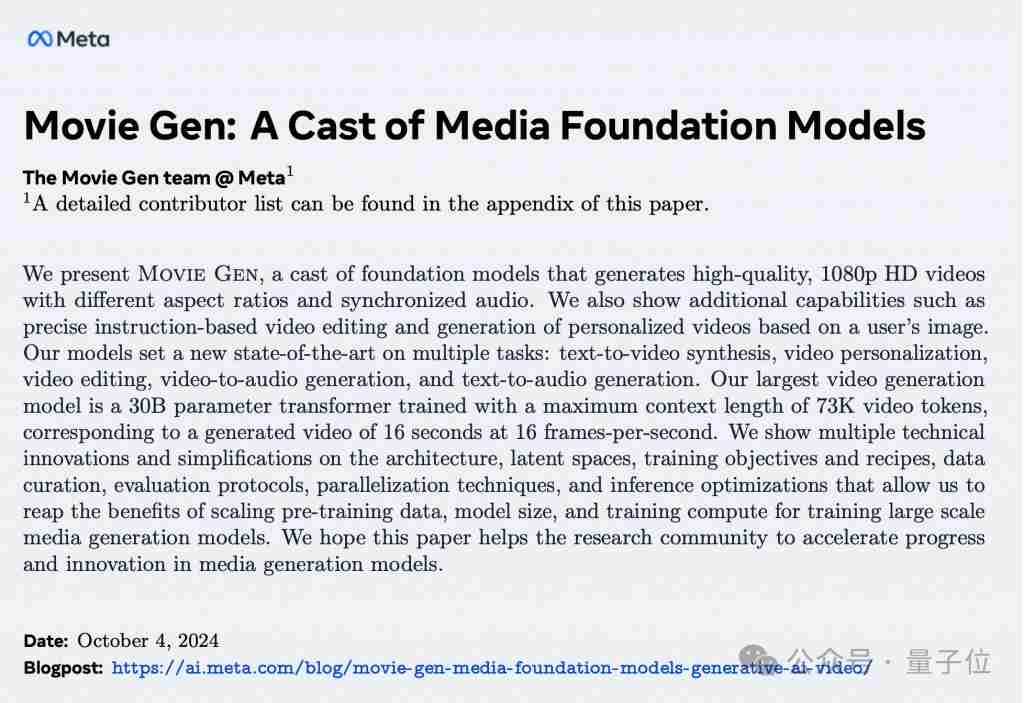
刚刚,Meta 抢在 OpenAI 之前推出自己的 Sora ——Meta Movie Gen
Sora 有的它都有,可创建不同宽高比的高清长视频,支持 1080p、16 秒、每秒 16 帧。
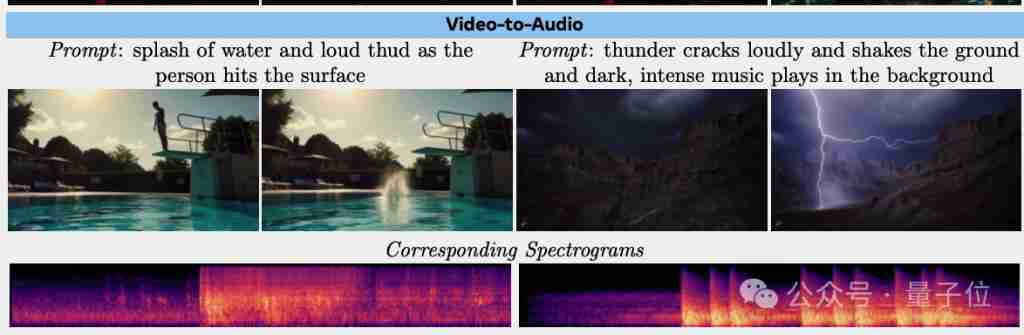
Sora 没有的它还有,能生成配套的背景音乐和音效、根据文本指令编辑视频,以及根据用户上传的图像生成个性化视频。
Meta 表示,这是 " 迄今为止最先进的媒体基础模型(Media Foundation Models)"。
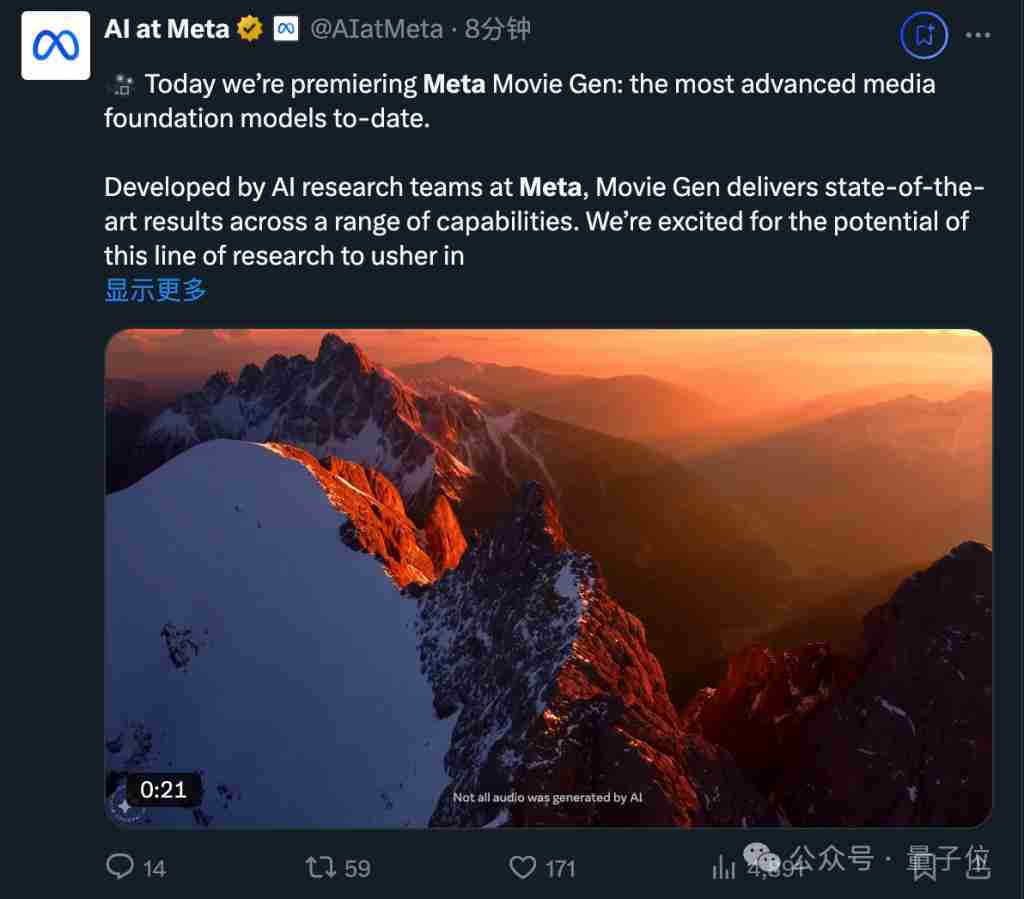
只需一句 " 把灯笼变成飞向空中的泡泡 ",就能替换视频中的物体,同时透明的泡泡正确反射了背景环境。
上传一张自己的照片,就能成为 AI 电影的主角。
生成的视频不再无声,也不只是能安一个背景音乐。
比如看这里!视频会配合滑板轮子转动和落地配上逼真音效。(注意打开声音)
有人表示,随着大量创作者学会使用 AI 视频编辑工具,很难想象几年后长视频和短视频会变成什么样。
这一次,与 Sora 只有演示和官网博客不同,Meta 在92 页的论文中把架构、训练细节都公开了。
不过模型本身还没开源,遭到抱抱脸工程师贴脸开大,直接在评论区扔下 Meta 的开源主页链接:
在这等着您嗷。
Meta 在论文中特别强调,数据规模、模型大小、训练算力的扩展对于训练大规模媒体生成模型至关重要。通过系统地提升这几个维度,才使得如此强大的媒体生成系统成为可能。
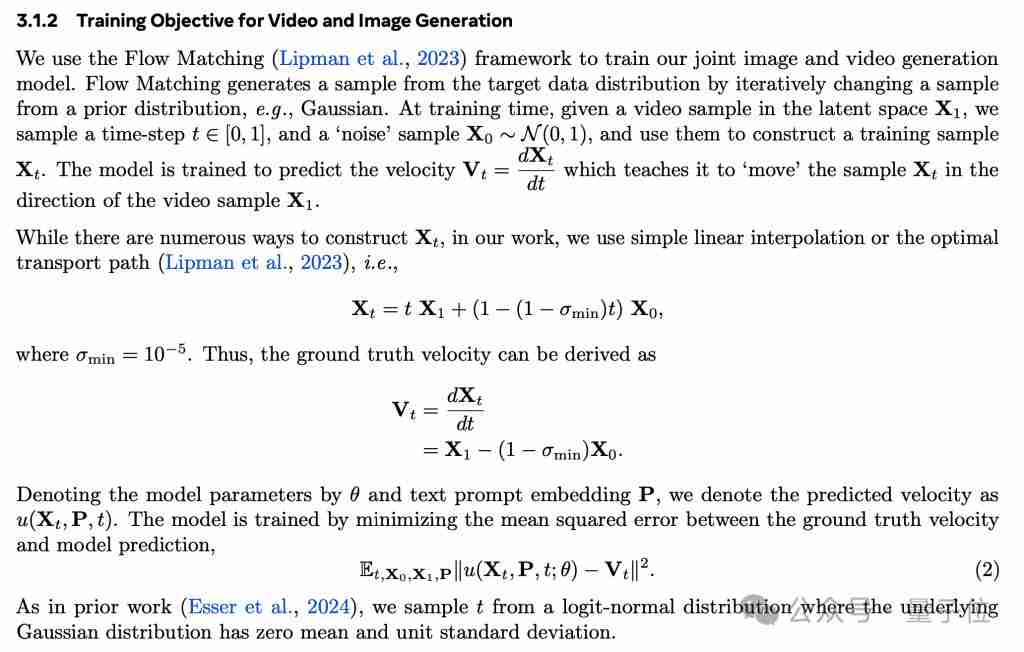
其中最另业界关注的一点是,这一次他们完全扔掉了扩散模型和扩散损失函数,使用 Transformer 做骨干网络,流匹配(Flow Matching)做训练目标。
用 Llama3 架构做视频模型
具体来说 Movie Gen 由视频生成和音频生成两个模型组成。
Movie Gen Video:30B 参数 Transformer 模型,可以从单个文本提示生成 16 秒、16 帧每秒的高清视频,相当于 73K 个视频 tokens。
对于精确视频编辑,它可以执行添加、删除或替换元素,或背景替换、样式更改等全局修改。
对于个性化视频,它在保持角色身份一致性和运动自然性方面取得 SOTA 性能。
Movie Gen Audio:13B 参数 Transformer 模型,可以接受视频输入以及可选的文本提示,生成与视频同步的高保真音频。
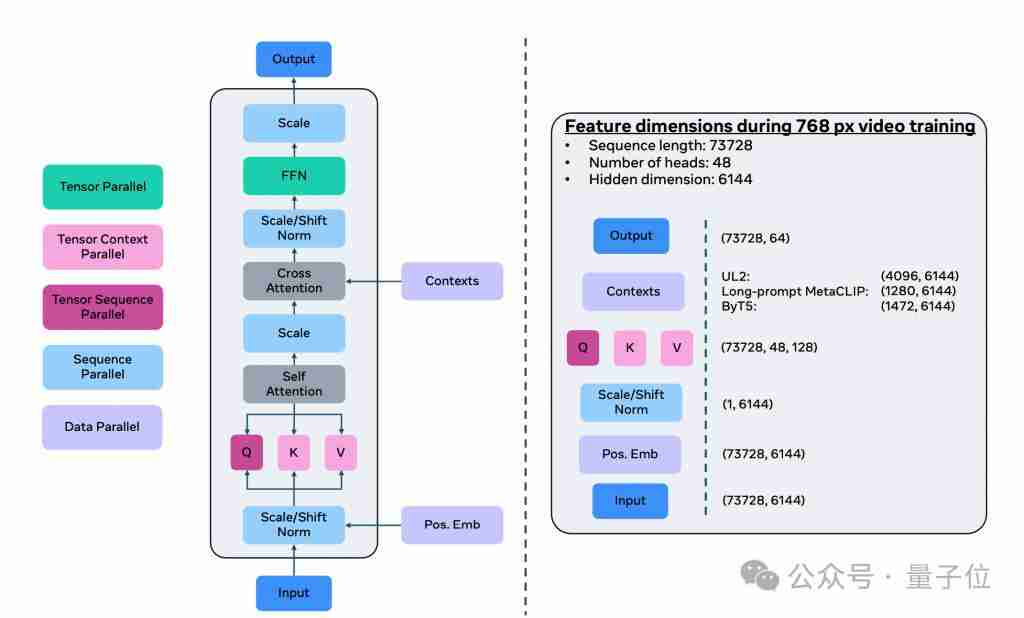
Movie Gen Video 通过预训练 - 微调范式完成,在骨干网络架构上,它沿用了 Transoformer,特别是 Llama3 的许多设计。
预训练阶段
在海量的视频 - 文本和图像 - 文本数据集上进行联合训练,学习对视觉世界的理解。这个阶段的训练数据规模达到了 O ( 100 ) M 视频和 O ( 1 ) B 图像,用以学习运动、场景、物理、几何、音频等概念。
微调阶段
研究人员精心挑选了一小部分高质量视频进行有监督微调,以进一步提升生成视频的运动流畅度和美学品质。
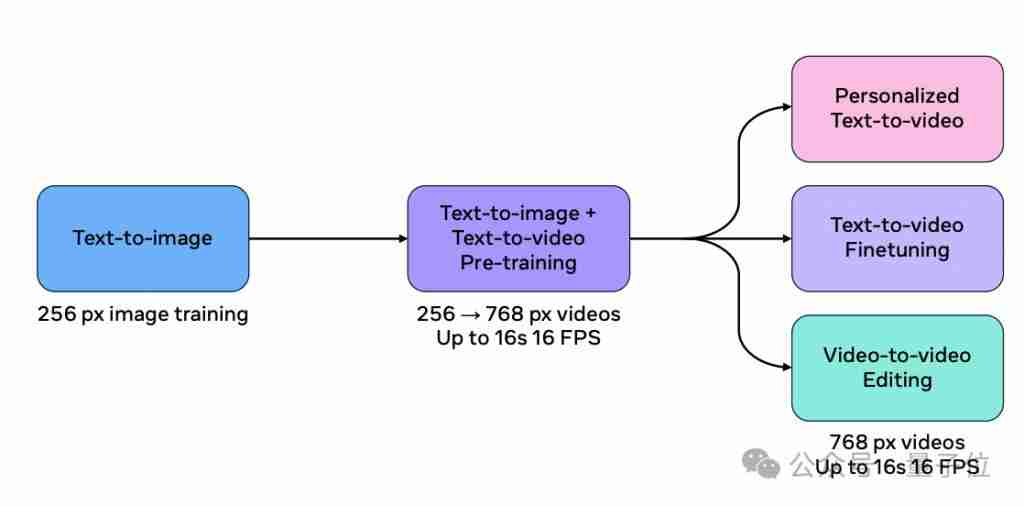
为了进一步提高效果,模型还引入了流匹配(Flow Matching)作为训练目标,这使得视频生成的效果在精度和细节表现上优于扩散模型。
扩散模型通过从数据分布逐渐加入噪声,然后在推理时通过逆过程去除噪声来生成样本,用大量的迭代步数逐步逼近目标分布。
流匹配则是通过直接学习样本从噪声向目标数据分布转化的速度,模型只需通过估计如何在每个时间步中演化样本,即可生成高质量的结果。
与扩散模型相比,流匹配方法训练更加高效,计算成本更低,并且生成的结果在时间维度上具有更好的连续性和一致性。
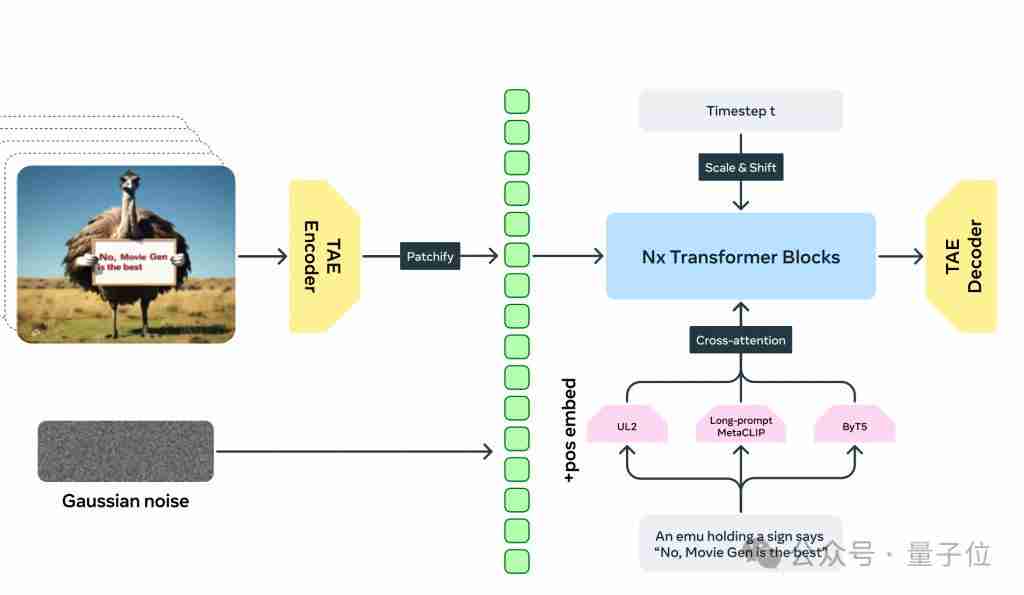
在整体架构上,首先通过时空自编码器(Temporal AutoEncoder, TAE)将像素空间的 RGB 图像和视频压缩到一个时空潜空间,学习一种更加紧凑的表征。
接着,输入的文本提示被一系列预训练的文本编码器编码成向量表示,作为模型的条件信息。这里用到了多种互补的文本编码器,包括理解语义的编码器如 UL2、与视觉对齐的编码器如 Long-prompt MetaCLIP,以及理解视觉文本的字符级编码器如 ByT5。
最后,生成模型以 Flow Matching 的目标函数进行训练,从高斯分布采样的噪声向量作为输入,结合文本条件,生成一个输出潜码。这个潜码经过 TAE 解码,就得到最终的图像或视频输出。
此外 Movie Gen Video 在技术上还引入了多项创新:
为了让模型同时适配图像和视频,设计了一套因子化的可学习位置编码(factorized learnable positional embedding)机制。对高度、宽度、时间三个维度分别编码,再相加。这样即适配了不同宽高比,又能支持任意长度的视频。
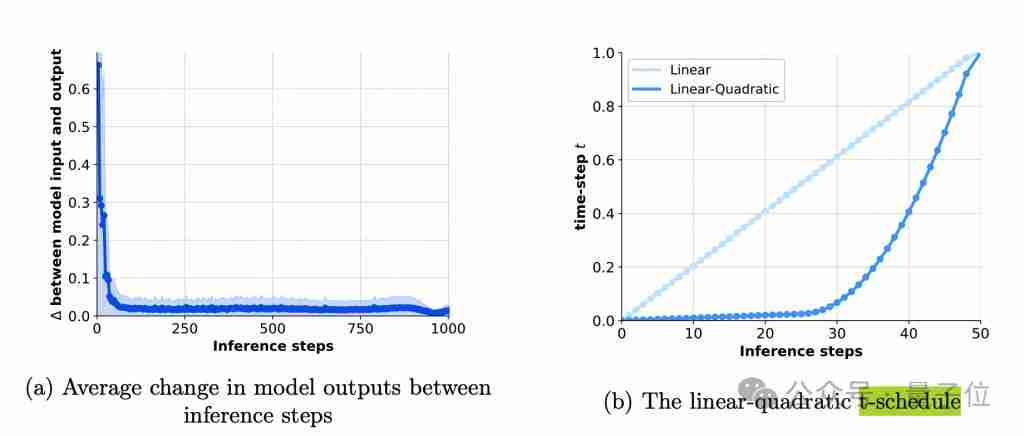
针对推理效率问题,它采用了线性 - 二次时间步长调度(linear-quadratic t-schedule)策略。仅用 50 步就能逼近 1000 步采样的效果,大幅提升了推理速度。
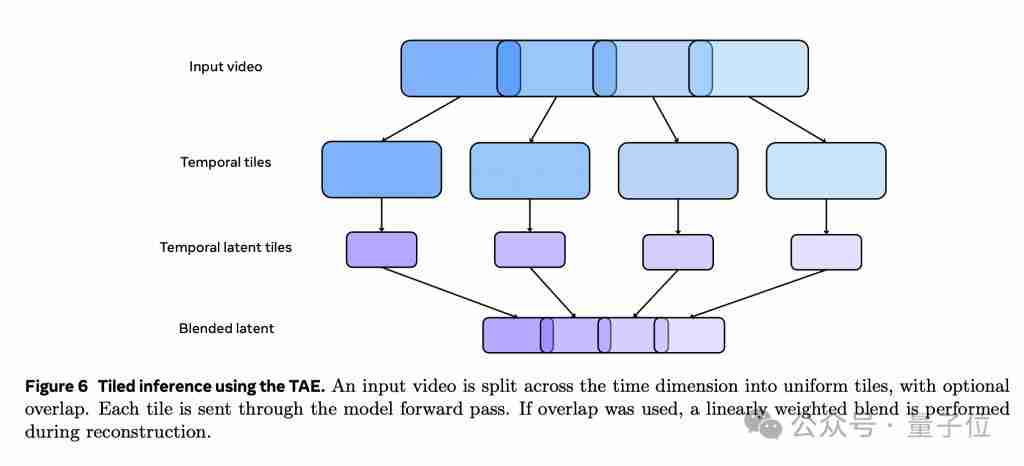
为了进一步提高生成效率,Movie Gen Video 模型还采用了基于时间平铺(temporal tiling)的推理方法。应对生成高分辨率长视频时,直接对整个视频进行编码和解码可能会遇到的内存限制问题。
在时间平铺推理中,输入视频在时间维度上被分割成多个片段,每个片段独立进行编码和解码,然后在输出时将所有片段重新拼接在一起。这种方法不仅降低了对内存的需求,还提高了推理的效率。
此外,在解码阶段使用了重叠和混合的方式来消除片段边界处的伪影问题,即通过在片段之间引入重叠区域,并对重叠区域进行加权平均,确保生成的视频在时间维度上保持平滑和一致。
另外 Meta 还开源了多个基准测试数据集,包括 Movie Gen Video Bench、Movie Gen Edit Bench 和 Movie Gen Audio Bench,为后续研究者提供了权威的评测工具,有利于加速整个领域的进步。
这篇长达 92 页的论文还介绍了更多在架构、训练方法、数据管理、评估、并行训练和推理优化、以及音频模型的更多信息。
感兴趣的可到文末链接查看。
One More Thing
AI 视频生成这块,这两天热闹不断。
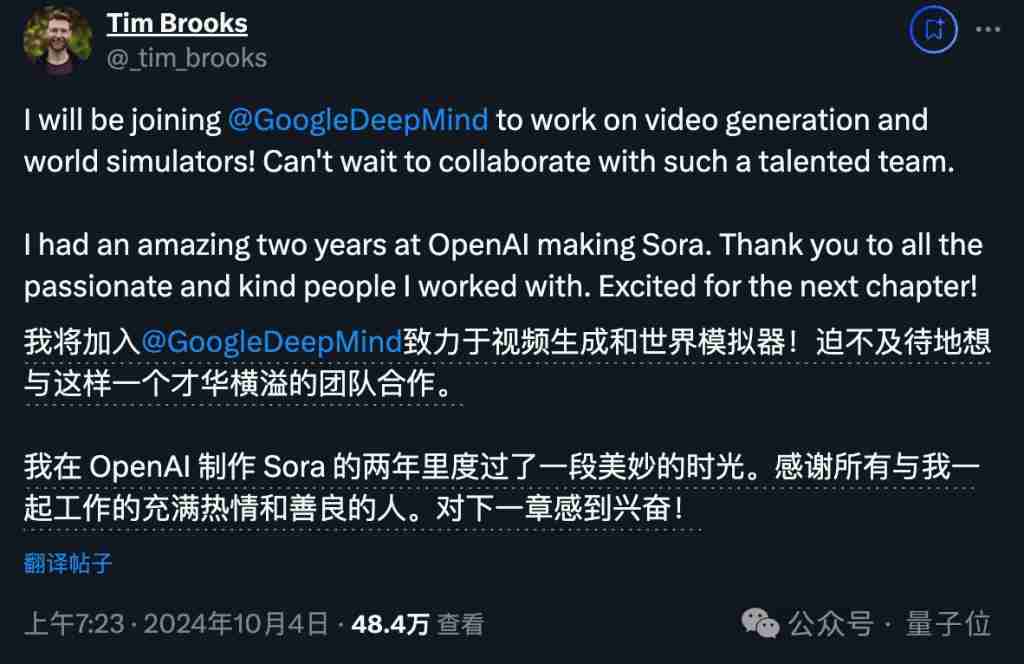
就在 Meta 发布 Movie Gen 之前不久,OpenAI Sora 主创之一Tim Brooks跳槽谷歌 DeepMind,继续视频生成和世界模拟器方面的工作。
这让很多人想到,就像当年谷歌迟迟不推出大模型应用,Transformer 8 个作者纷纷出走。
现在 OpenAI 迟迟发布不了 Sora,主要作者也跑了。
不过另外也有人认为,Tim Brooks 选择现在离开,或许说明他在 OpenAI 的主要工作完成了,也让人开始猜测:
Meta 的发布会迫使 OpenAI 放出 Sora 来回应吗?
(截至目前为止,Sora 的另一位主创 Bill Peebles 还未发声。)
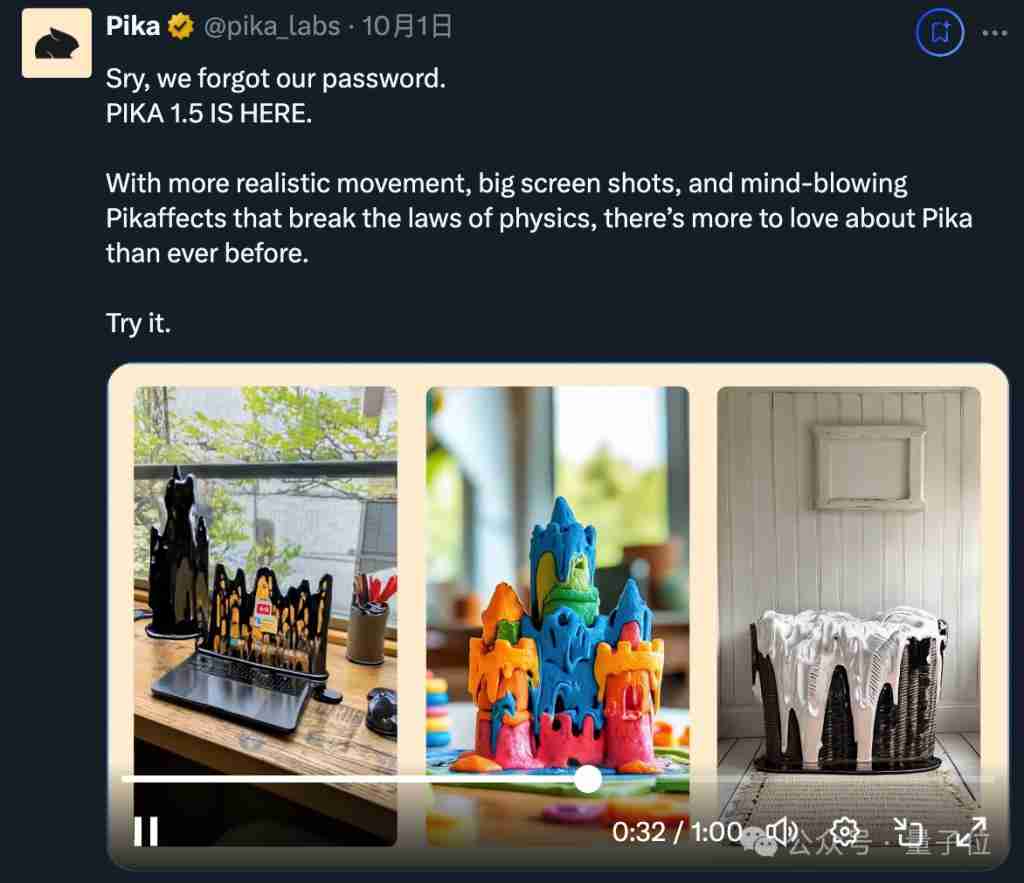
现在 Meta 放出了带有视频编辑功能的模型,再加上 10 月 1 日 Pika 1.5 更新,主打给视频中物体加上融化、膨胀、挤压等物理特效。
不难看出,AI 视频生成下半场,要开始卷向 AI 视频编辑了。
论文地址:
https://ai.meta.com/static-resource/movie-gen-research-paper
参考链接:
[ 1 ] https://ai.meta.com/research/movie-gen/
[ 2 ] https://x.com/AIatMeta/status/1842188252541043075

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
Meta多轮裁员致员工士气降至冰点,上月裁员约8000人。幸存员工被迫承担AI训练杂活,对CEO扎克伯格提出的黑客松活动反应冷淡。扎克伯格承诺今年不再裁员,但承认可能犯更多错误。
Meta首席技术官承认员工士气跌至历史最低点,源于AI转型中裁员8000人及强制调派员工从事枯燥数据标注。管理层致歉并推出涨零食预算、限制管理幅度等福利,但外界对效果持保留态度。
Meta新AI团队MSL成立不到半年,已完成首批核心模型内部交付并进入测试阶段,涵盖文本与图像处理能力。工程化落地仍是难点,公司已重组架构、引进人才并集中资源,计划2026至2027年推出搭载自主AI的终端产品,包括Ray-BanDisplay智能眼镜,目前暂停海外铺货以保障美国订单。
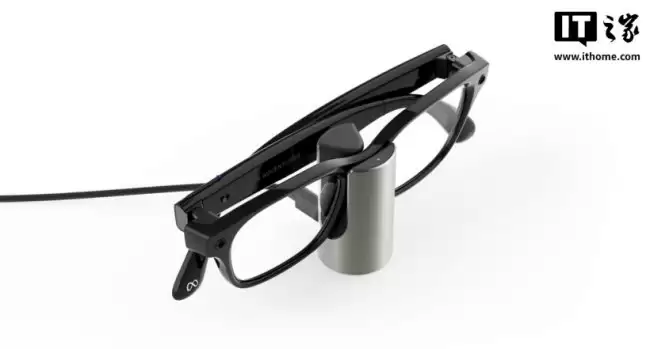
Meta推出一款60美元不锈钢充电底座,专为雷朋联名款及OakleyMetaHSTN智能眼镜设计,但不支持雷朋Display。底座重108克,支持20分钟充至50%、一小时充满,采用USB-C接口但需自备充电线,主打随手一放的便捷体验。
墨刀将AIPPT纳入产品导航,支持AI生成与美化PPT,与原型、流程图等工具协同,为方案表达提供完整链路。AIPPT可快速梳理结构、初步美化,但最终输出仍需人工校对,不能替代真实业务数据与决策。
Meta收回强制工程师加入AI团队的指令,承认重组存在失误。此前调动7000名员工,现改为尊重个人选择,并给予调岗优先安置权。员工曾抱怨工作类似数据标注,士气跌至近二十年最低。
豆包大模型2.1Pro正式发布,多项基准测试接近GPT-5.5等水平,日均Tokens调用量达180万亿。Meta推出299美元智能眼镜新系列。甲骨文上财年裁员约2.1万人,部分岗位被AI取代。高通拟40亿美元收购AI芯片初创公司Modular。
溧阳市博物馆展出号称“八十年代拍摄”的老照片,因文字模糊扭曲被质疑AI生成。馆方回应称,原版照片模糊,主办方使用AI修复导致变形,目前已撤展,并将加强审核。
Meta公司近日暂停了一项内部计划,该计划原拟通过追踪员工鼠标移动及数字活动来训练AI模型,但由于存在数据安全漏洞——敏感数据可被所有员工访问,已承认正就此展开调查,但未透露暂停将持续多久。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



