

如何在Java中实现分布式缓存的一致性和容错机制
如何在Java中实现分布式缓存的一致性和容错机制分布式缓存是互联网高并发系统中常用的技术,它可以提高系统的性能和扩展性。然而,分布式缓存面临着一致性和容错的挑战。在本文中,我们将讨论如何在Java中实现分布式缓存的一致性和容错机制,并提供具体的代码示例。一、一致性机制在分布式环境下,缓存的一致性是非常重要的。分布式缓存的一致性可以通过以下两种机制实现:缓存更
如何在Java中实现分布式缓存的一致性和容错机制
分布式缓存是互联网高并发系统中常用的技术,它可以提高系统的性能和扩展性。然而,分布式缓存面临着一致性和容错的挑战。在本文中,我们将讨论如何在Java中实现分布式缓存的一致性和容错机制,并提供具体的代码示例。
一、一致性机制
在分布式环境下,缓存的一致性是非常重要的。分布式缓存的一致性可以通过以下两种机制实现:
- 缓存更新策略
当缓存中的数据更新时,需要保证缓存中的数据与数据库中的数据保持一致。常见的缓存更新策略有两种:
(1)写回策略(Write-Back):当数据库中的数据发生变化时,只更新缓存中的数据标志位,而不实际更新缓存中的数据。当读取缓存的时候,如果缓存中的数据标志位为“更新”,则从数据库中读取最新数据存入缓存,并将标志位置为“正常”。这种策略可以减少数据库的读写操作,提高性能和并发能力。
(2)写通知策略(Write-Through):当数据库中的数据发生变化时,除了更新数据库中的数据,还需要更新缓存中的数据。这种策略保证了缓存中的数据与数据库中的数据一致,但同时增加了数据库的读写操作。需要注意的是,在更新缓存数据时,可以选择同步更新或异步更新。
- 缓存失效策略
缓存失效是指由于业务变化、数据更新等原因导致缓存中的数据不再有效。为了保证缓存一致性,可以采用以下策略:
(1)基于时间的失效策略:为每个缓存设置一个存活时间,超过该时间则认为缓存失效。常见的时间单位有秒、分钟等。
(2)基于大小的失效策略:为每个缓存设置一个最大容量,当缓存数量超过最大容量时,根据一定策略(如LRU、LFU)淘汰一部分缓存。
(3)基于事件的失效策略:当数据库中的数据发生变化时,发出一个事件通知,缓存接收到通知后失效。这种策略通常需要与消息队列等技术结合使用。
代码示例:
// 初始化缓存
Cache cache = new Cache();

// 写回策略示例
public void updateData(String key, Object data) {
    // 更新数据库数据
    updateDatabase(key, data);

    // 更新缓存数据标志位
    cache.setFlag(key, CacheFlag.UPDATE);
}

public Object getData(String key) {
    // 从缓存中读取数据
    Object data = cache.getData(key);

    // 判断缓存数据标志位
    if (cache.getFlag(key) == CacheFlag.UPDATE) {
        // 从数据库中读取最新数据
        data = readDatabase(key);
        cache.setData(key, data);
        cache.setFlag(key, CacheFlag.NORMAL);
    }

    return data;
}

// 写通知策略示例
public void updateData(String key, Object data) {
    // 更新数据库数据
    updateDatabase(key, data);

    // 更新缓存数据
    cache.setData(key, data);

    // 发送缓存更新事件
    sendMessage(key);
}

public void handleMessage(String key) {
    // 接收到缓存更新事件后,失效缓存
    cache.invalidate(key);
}

// 基于时间的失效策略示例
public void putData(String key, Object data, int expireTime) {
    cache.setData(key, data, expireTime);
}

public Object getData(String key) {
    // 判断缓存是否超时
    if (cache.isExpired(key)) {
        // 从数据库中读取最新数据,重新设置缓存
        Object data = readDatabase(key);
        cache.setData(key, data);
    }

    return cache.getData(key);
}

// 基于大小的失效策略示例(使用LinkedHashMap实现LRU淘汰策略)
public void putData(String key, Object data) {
    if (cache.size() >= maximumCapacity) {
        // 淘汰最近最少使用的缓存数据
        cache.removeEldest();
    }

    cache.setData(key, data);
}

public Object getData(String key) {
    return cache.getData(key);
}
二、容错机制
在分布式环境下,容错机制可以保证即使有部分节点出现故障,系统仍然能正常运行,提高系统的可用性和可靠性。常见的容错机制有以下几种:
- 数据备份
在分布式缓存中,数据备份是常见的容错机制之一。在将数据存入缓存之前,可以将数据同时存入多个节点,当某个节点不可用时,可以从其他节点获取备份数据。备份可以通过复制、镜像等方式实现。需要注意的是,数据备份会增加系统的存储和网络开销。
- 请求重试
当某个节点出现故障时,可以尝试从其他节点获取数据,以保证请求的正常完成。请求重试机制可以通过设置超时时间、重试次数等方式实现。同时,可以将请求重试与负载均衡策略结合使用,选择最优的节点进行请求。
- 故障转移
当某个节点出现故障时,可以将其上的缓存数据迁移到其他节点上,以确保系统的可用性。故障转移机制可以通过主从模式、集群模式等方式实现。在实现故障转移时,需要考虑数据一致性和数据迁移的开销。
代码示例:
// 数据备份示例
public void putData(String key, Object data) {
    // 将数据存入本地节点和多个备份节点
    cache.setData(key, data);
    backupNode1.setData(key, data);
    backupNode2.setData(key, data);
}

public Object getData(String key) {
    // 尝试从本地节点获取数据
    Object data = cache.getData(key);

    if (data == null) {
        // 尝试从备份节点获取数据
        data = backupNode1.getData(key);

        if (data == null) {
            data = backupNode2.getData(key);
        }

        // 将备份数据存入本地节点
        cache.setData(key, data);
    }

    return data;
}

// 请求重试示例
public Object getData(String key) {
    int retryTimes = 3;
    for (int i = 0; i < retryTimes; i++) {
        try {
            // 尝试从节点获取数据
            return getNode().getData(key);
        } catch (Exception e) {
            // 出现异常,重试
            continue;
        }
    }

    return null;
}

// 故障转移示例
public void migrateData() {
    // 当节点不可用时,将其上的缓存数据迁移到其他节点
    if (!isAvailable(node)) {
        // 将节点上的缓存数据迁移到其他可用节点
        migrateDataToAvailableNodes(node);
    }
}

public Object getData(String key) {
    // 从可用节点获取数据
    Object data = getNode().getData(key);

    // 如果获取的数据为null,则说明节点不可用,从其他可用节点获取数据
    if (data == null) {
        for (Node n : availableNodes) {
            if (!n.equals(getNode())) {
                data = n.getData(key);

                if (data != null) {
                    // 将数据缓存到本地节点
                    cache.setData(key, data);
                    break;
                }
            }
        }
    }

    return data;
}
总结:
本文介绍了在Java中实现分布式缓存的一致性和容错机制的方法,并提供了具体的代码示例。在实际应用中,可以根据具体业务需求选择适合的一致性策略和容错机制,提高系统的性能和可用性。同时,需要考虑数据一致性、数据备份、请求重试和故障转移等方面,以确保分布式缓存的稳定运行。
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
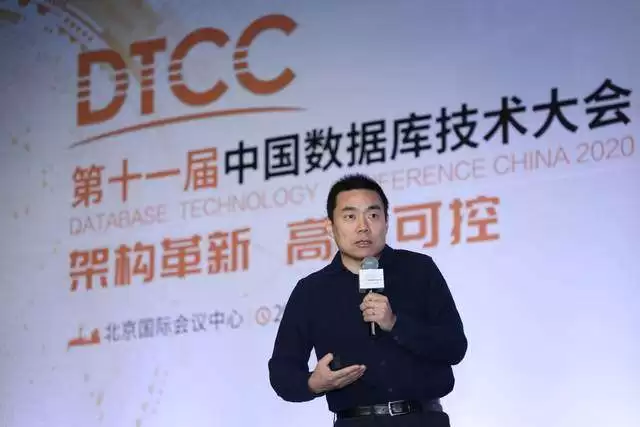
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
SpringCloud ConfigSpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集产生背景:在微服务场景下,若继续采用传统方式管理配置文件,配置文件管理器将变得极为复杂。而且在生产环境中,一旦配置文件发生改变,就需要重新配

1 前言 在现在工作中,为保障服务的高可用,应对单点故障、负载量过大等单机部署带来的问题,生产环境常用多机部署。为解决多机房部署导致的数据不一致问题,我们常会选择用分布式锁。目前其他比较常见的实现方案我列举在下面:基于缓存实现分布式锁(本文主要使用redis实现)基于数据库实现分布式锁基于zooke
简介 Hadoop作为被广泛运用的大数据框架,依靠Hadoop分布式文件系统(HDFS)来存储和管理海量数据。但有时会出现HDFS权限问题,影响数据的访问和处理。本教程将带你了解识别和解决HDFS权限问题的流程,助你维护一个强健且安全的Hadoop生态系统。 HDFS 权限概述 HDFS(Hadoo
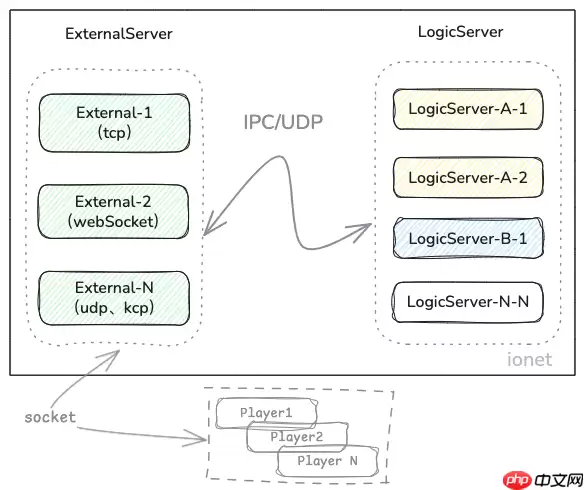
ionet25.3版本发布,基于Aeron构建,实现纳秒级延迟与真零拷贝,无需第三方中间件即可搭建分布式服务器。框架轻量级,15MB启动,支持游戏、物联网、高频交易等场景。采用对外服与逻辑服架构,动态扩缩,类MVC编码,自动生成多前端交互代码。
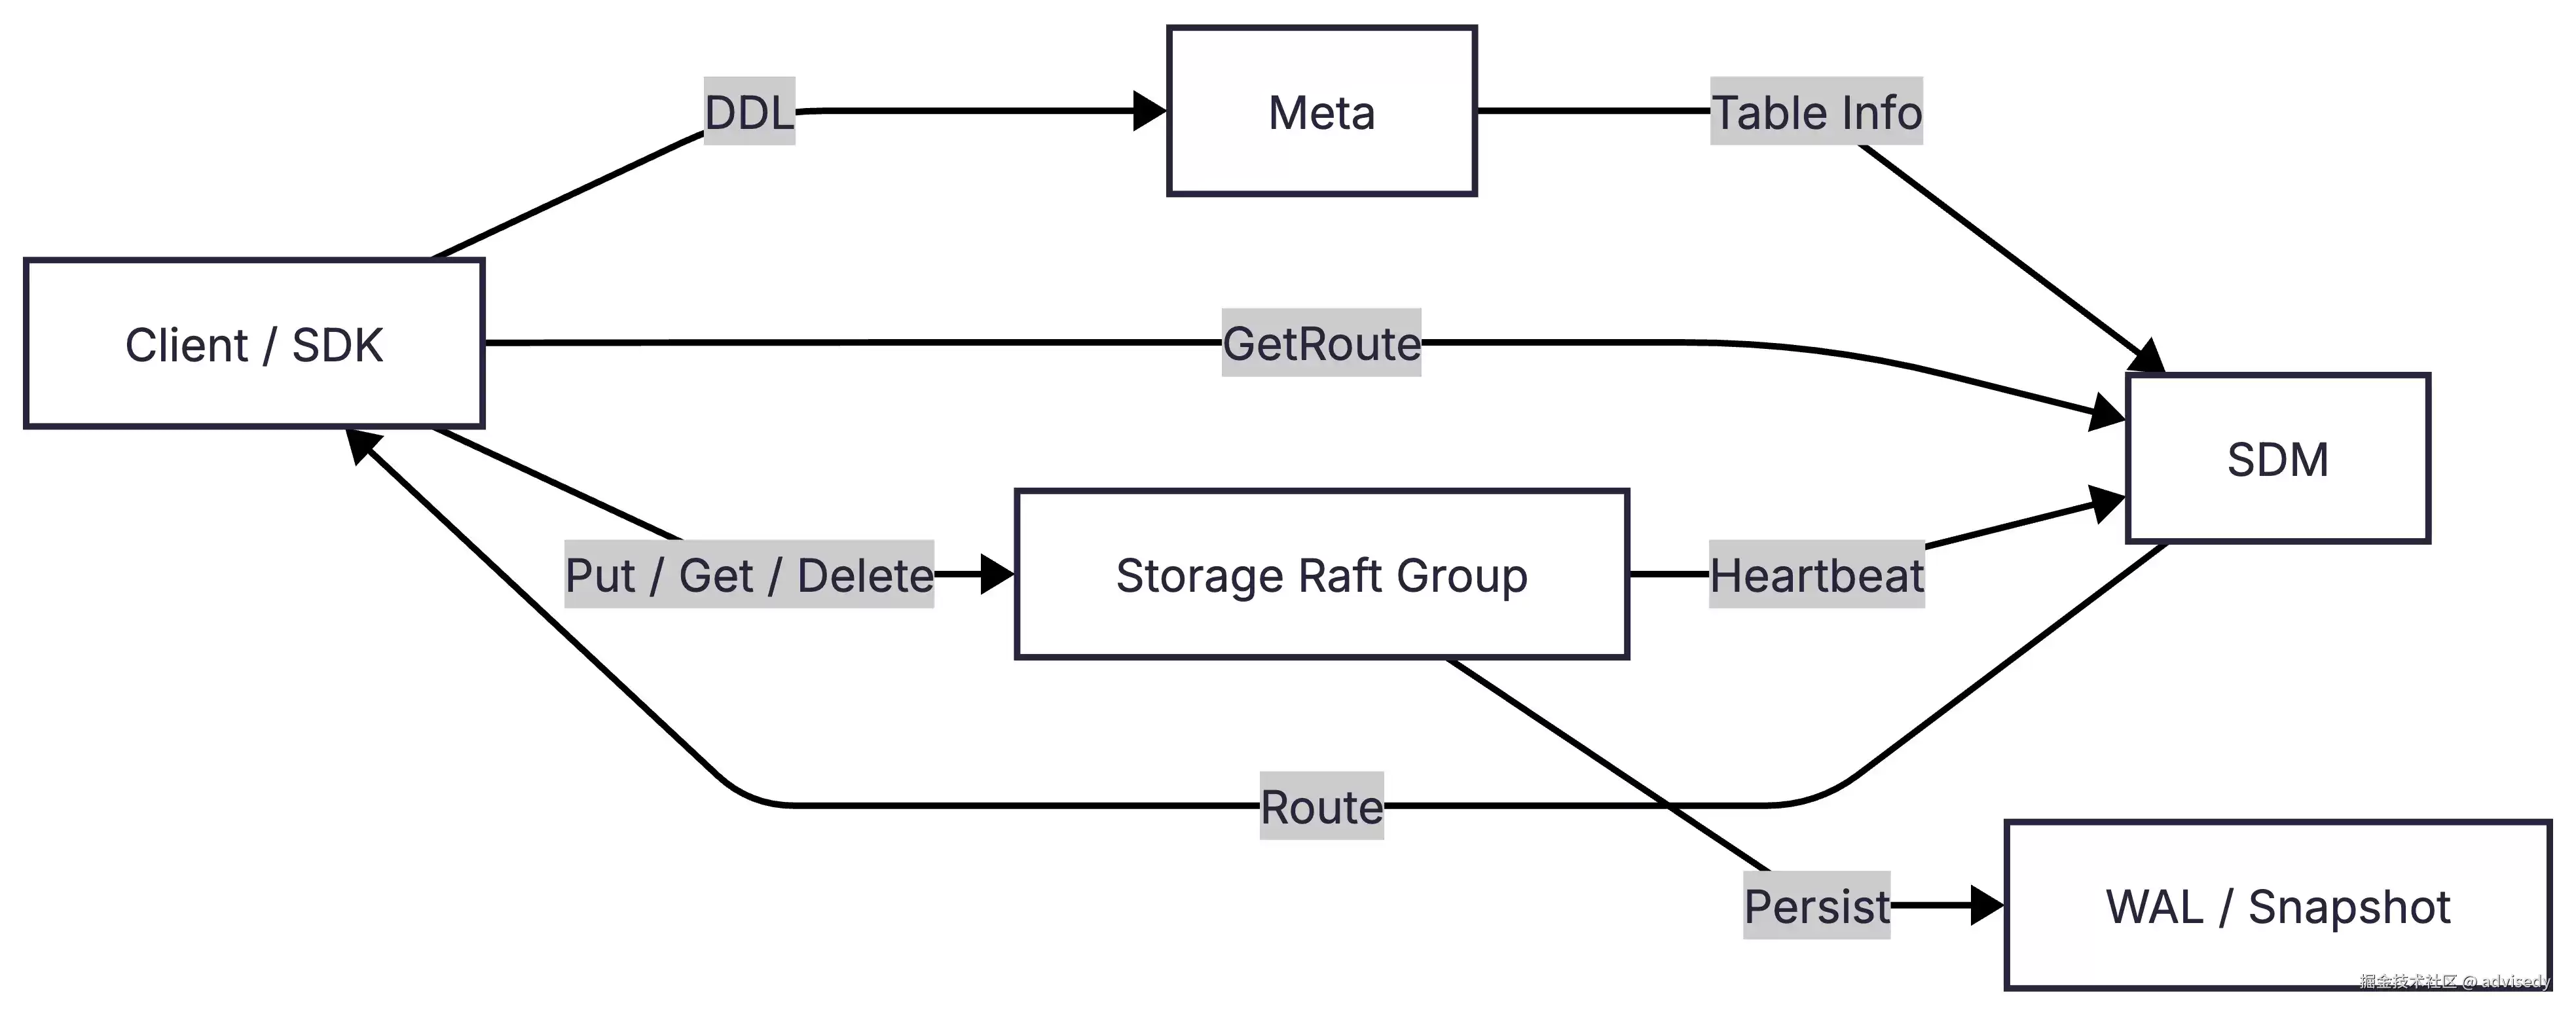
日期: 2026.7.6 写在开头的开头 AdvisKV 是我用 C++17 从零写的一个分布式 KV 存储系统原型,包含 Meta、SDM、Storage、SDK 四个主要模块,覆盖建库建表、路由查询、KV 读写、副本数扩缩容、坏副本替换、Raft、WAL/snapshot 恢复,跑了gtest
Redis配合Lua脚本通过原子性执行实现分布式限流的强一致性,Java仅负责安全调用,不可参与状态判断。生产环境推荐EVALSHA并提前预热脚本。令牌桶限流时,客户端传入时间戳等参数。Java层需正确配置序列化、返回值类型和连接池,否则易破坏一致性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



