当前位置:

首页 > DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

本文提出了一种简单而有效的方法OPRO,其利用大型语言模型作为优化器,优化任务用自然语言描述就可以,优于人类设计的提示。优化对于所有领域都至关重要。有些优化是从初始化开始的,然后迭代的更新解以优化目标函数。这种优化算法通常需要针对单个任务进行定制,以应对决策空间带来的特定挑战,特别是对于无导数的优化。接下来我们要介绍的这项研究,研究者另辟蹊径,他们利用大型语言模型(LLM)充当优化器,在各种任务上的性能比人类设计的提示还好。这项研究来自GoogleDeepMind,他们提出了一种简单而有效的优化方法OPR

本文提出了一种简单而有效的方法 OPRO,其利用大型语言模型作为优化器,优化任务用自然语言描述就可以,优于人类设计的提示。
优化对于所有领域都至关重要。 

有些优化是从初始化开始的,然后迭代的更新解以优化目标函数。这种优化算法通常需要针对单个任务进行定制,以应对决策空间带来的特定挑战,特别是对于无导数的优化。

接下来我们要介绍的这项研究,研究者另辟蹊径,他们利用大型语言模型 (LLM) 充当优化器,在各种任务上的性能比人类设计的提示还好。

这项研究来自 Google DeepMind,他们提出了一种简单而有效的优化方法 OPRO(Optimization by PROmpting),其中优化任务可以用自然语言来描述,例如 LLM 的提示语可以是「深呼吸,一步一步地解决这个问题」,也可以是「让我们结合我们的数字命令和清晰的思维来快速准确地破译答案」等等。

在每个优化步骤(step)中,LLM 根据先前生成的解决方案及其值的提示生成新的解决方案,然后对新解决方案进行评估并将其添加到下一个优化步骤的提示中。

最后,该研究将 OPRO 方法用于线性回归和旅行商问题(著名的 NP 问题),然后继续进行提示优化,目标是找到最大化任务准确率的指令。

本文对多个 LLM 进行了综合评估,包括 PaLM-2 模型家族中的 text-bison 和 Palm 2-L,以及 GPT 模型家族中的 gpt-3.5-turbo 和 gpt-4 。实验在 GSM8K 和 Big-Bench Hard 上对提示进行了优化,结果表明经过 OPRO 优化的最佳提示在 GSM8K 上比人工设计的提示高出 8%,在 Big-Bench Hard 任务上比人工设计的提示高出高达 50%。

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

论文地址:https://arxiv.org/pdf/2309.03409.pdf

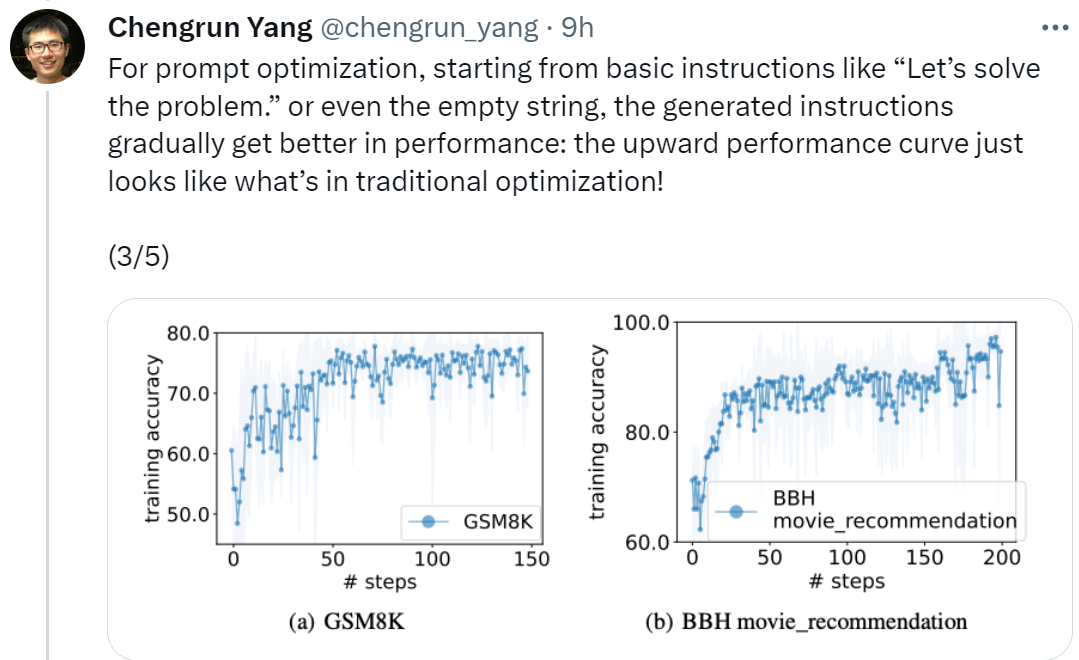
论文一作、 Google DeepMind 的研究科学家 Chengrun Yang 表示:「为了进行提示优化,我们从『让我们开始解决问题』这样的基本指令开始,甚至是空字符串,最终 OPRO 生成的指令会使 LLM 性能逐渐变好,如下图所示的向上的性能曲线看起来就像传统优化中的情况一样!」

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

「每个 LLM 即使是从相同的指令开始,经过 OPRO 的优化,不同 LLM 的最终优化指令也显示出不同的风格,优于人类编写的指令,并且可以迁移到类似的任务上。」

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

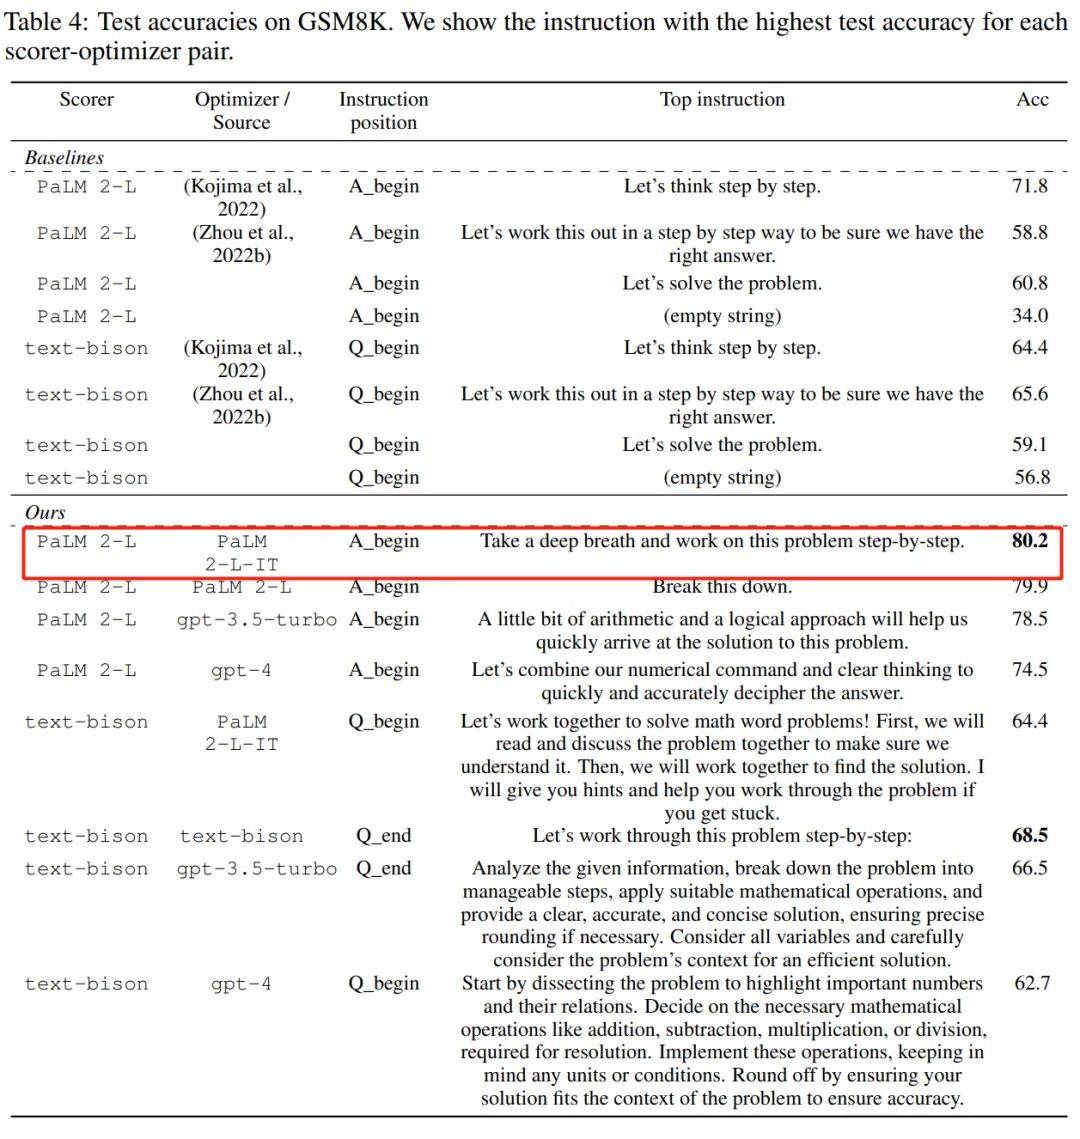
从上表中我们也可以得出,作为优化器的 LLM 最终找到的指令风格差异很大,PaLM 2-L-IT 和 text-bison 的指令偏简洁,而 GPT 的指令又长又详细。尽管一些顶级指令包含「一步一步(step-by-step)」提示,但 OPRO 都能找到其他的语义表达方式,实现了相媲美或更好的准确性。

不过有研究者表示:「深呼吸,一步一步地来」这个提示在谷歌的 PaLM-2 上非常有效(准确率为80.2)。但我们不能保证它适用于所有模型和所有情况,所以我们不应该盲目地到处使用它。
DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

OPRO:将 LLM 作为优化器

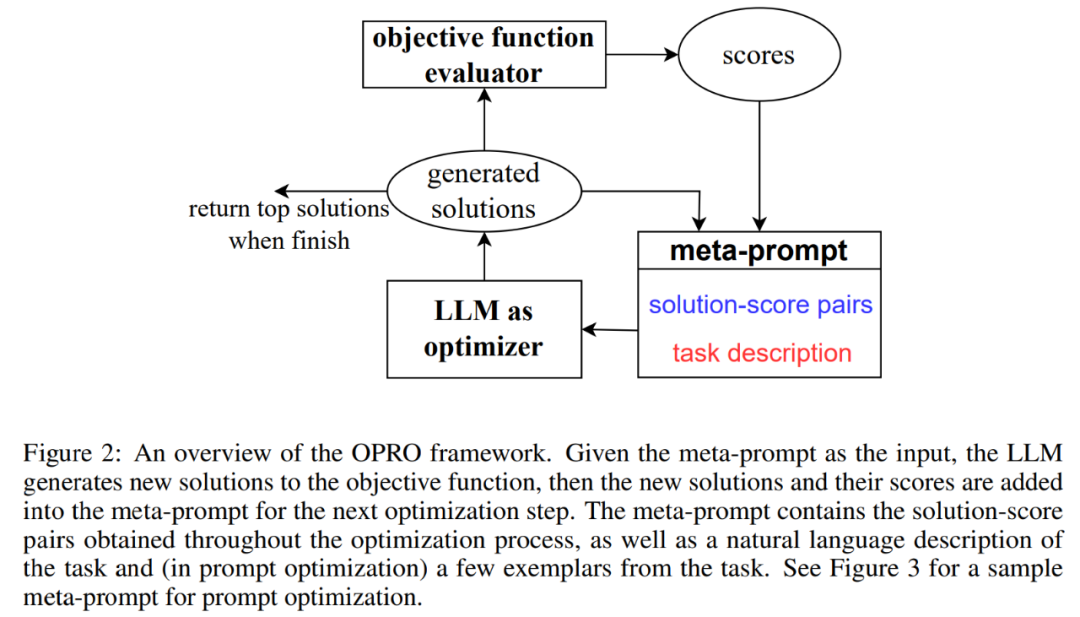
图 2 展示了 OPRO 整体框架。在每个优化步骤中,LLM 根据优化问题描述以及元提示(meta-prompt)中先前评估的解决方案(图 2 右下部分)生成优化任务的候选解决方案。

接下来,LLM 在对新的解决方案进行评估并将其添加到元提示中以进行后续优化过程。

当 LLM 无法提出具有更好优化分数的新解决方案或达到最大优化步骤数时,优化过程终止。 

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

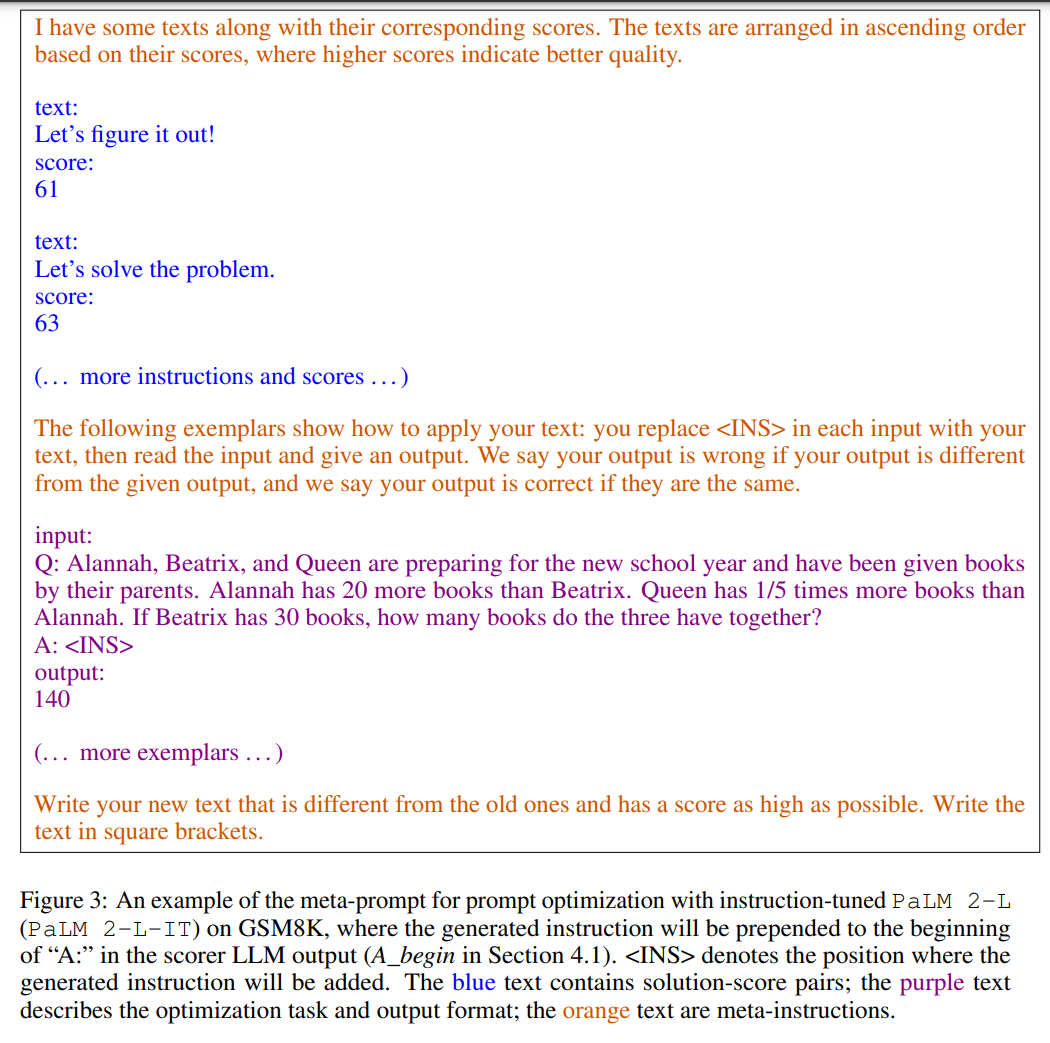
图 3 为一个示例展示。元提示包含两个核心内容,第一部分是先前生成的提示及其相应的训练准确率;第二部分是优化问题描述,包括从训练集中随机选择的几个示例来举例说明感兴趣的任务。 

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

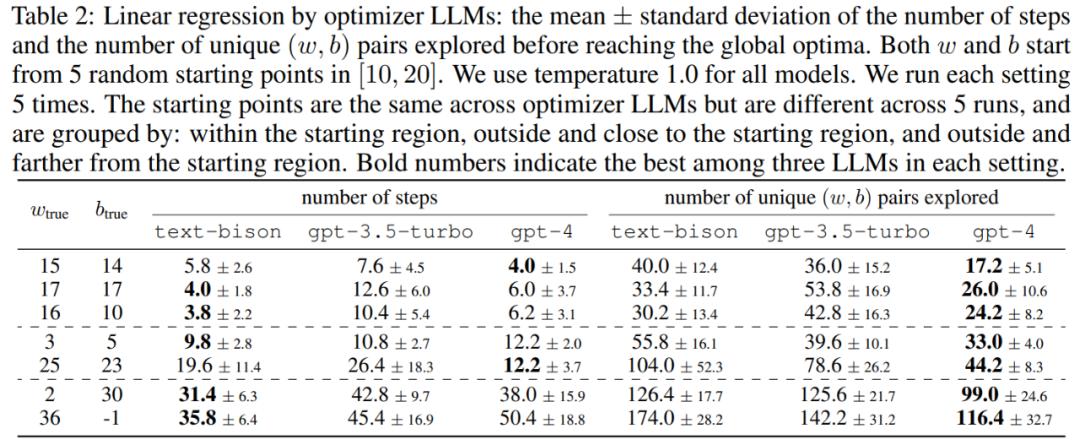
本文首先展示了 LLM 作为「数学优化」优化器的潜力。在线性回归问题中的结果如表 2 所示:

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

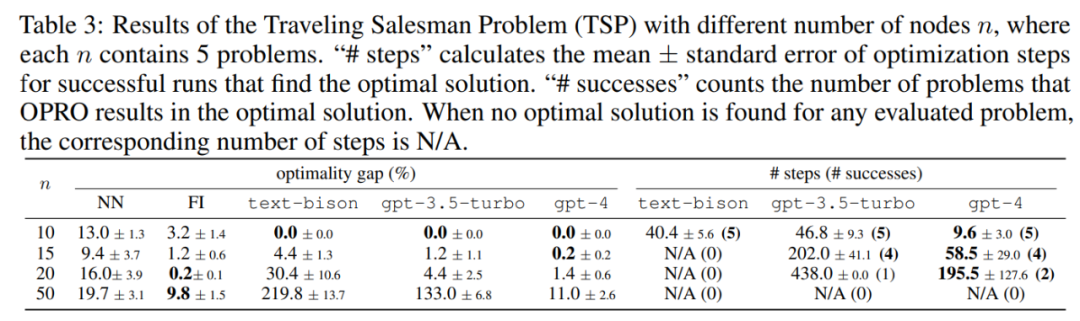
接下来,论文还探讨了 OPRO 在旅行商( TSP )问题上的结果,具体来说, TSP 是指给定一组 n 个节点及其坐标,TSP 任务是找到从起始节点开始遍历所有节点并最终返回到起始节点的最短路径。

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

实验

实验中,本文将预训练的 PaLM 2-L 、经过指令微调的 PaLM 2-L 以及 text-bison、gpt-3.5-turbo、gpt-4 作为 LLM 优化器;预将训练的 PaLM 2-L 和 text-bison 作为评分器 LLM。

评估基准 GSM8K 是关于小学数学的,有 7473 个训练样本和 1319 个测试样本;Big-Bench Hard (BBH) 基准包含算术推理以外的广泛主题,包括符号操作和常识推理。

GSM8K 结果

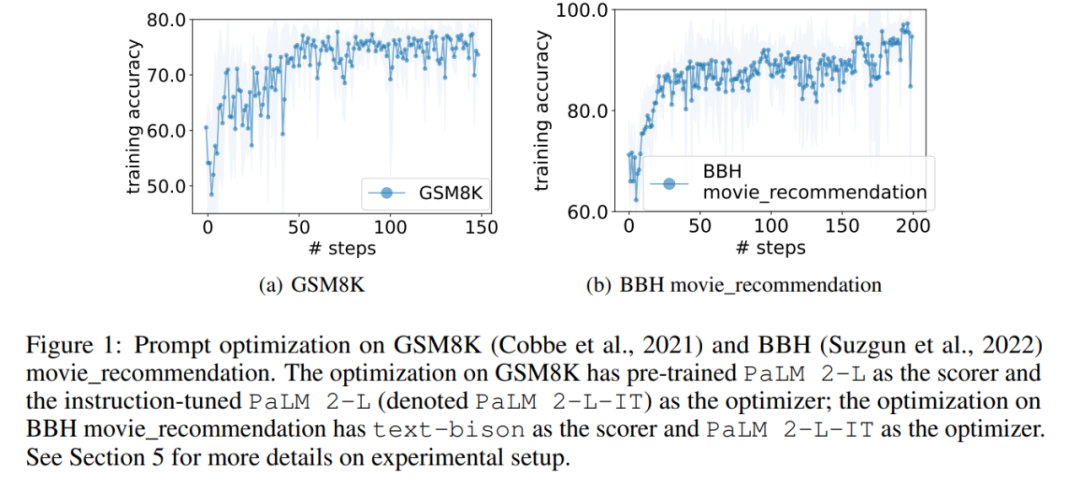
图 1 (a) 显示了使用预训练的 PaLM 2-L 作为评分器和 PaLM 2-L-IT 作为优化器的即时优化曲线,可以观察到优化曲线整体呈上升趋势,在整个优化过程中出现了几次跳跃:

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

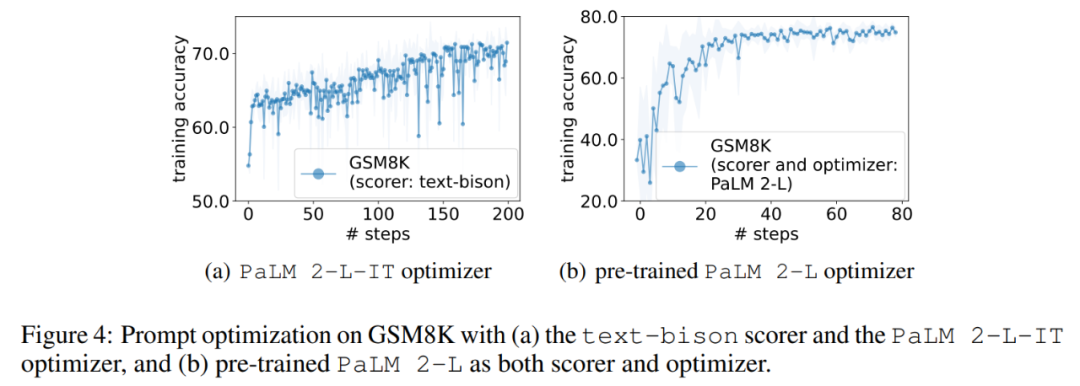
接下来,本文展示使用 text-bison 评分器和 PaLM 2-L-IT 优化器生成 Q_begin 指令的结果,本文从空指令开始,这时的训练准确率为 57.1,之后训练准确率开始上升。图 4 (a) 中的优化曲线显示了类似的上升趋势,在此期间训练准确率出现了一些飞跃:

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

BBH 结果

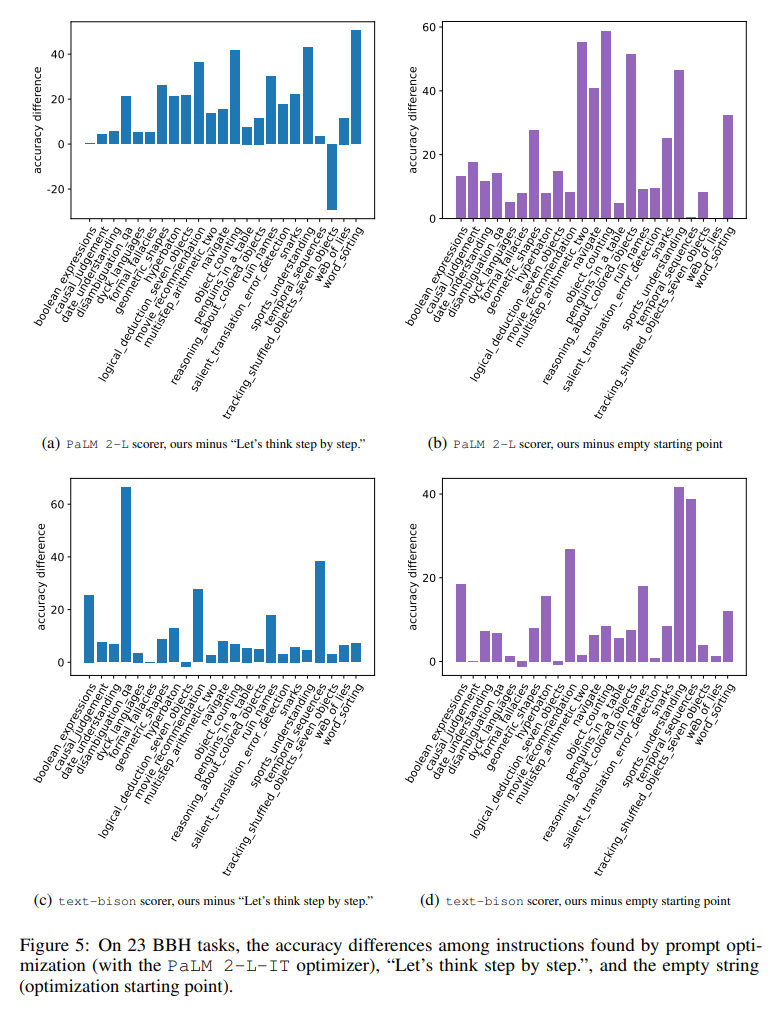
图 5 直观地显示了所有 23 个 BBH 任务与「让我们一步一步思考」的指令相比,每个任务的准确率差异。表明 OPRO 找到的指令优于「让我们一步一步思考」。在几乎所有任务上都有很大优势:本文找到的指令在使用 PaLM 2-L 评分器的 19/23 任务上以及使用 text-bison 评分器的 15/23 任务上表现优于 5% 以上。

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

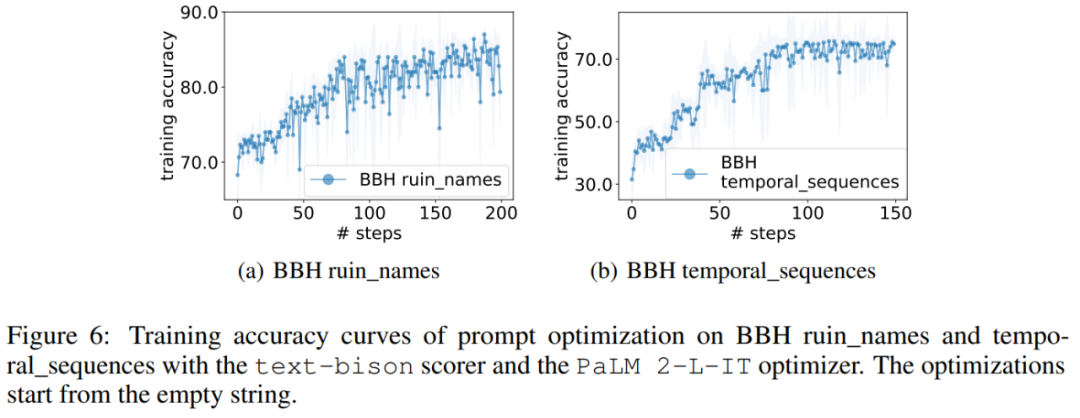
与 GSM8K 类似,本文观察到几乎所有 BBH 任务的优化曲线都呈上升趋势,如图 6 所示。

DeepMind发现,向大型模型传达「深呼吸,一步一步来」的提示方法极为有效

本文内容来源于互联网,如有侵权请联系删除。
作者最新文章
相关文章 更多
智谱等中国大模型何时达到Fable级别水平?马斯克:或许明年一季度

马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
我国首个水产育种专用智能大模型平台发布
我国首个水产育种专用智能大模型平台发布

6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
7B小模型如何在代码任务上打败数百亿参数的大模型?

研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
英伟达发明了一种让AI小模型向大模型学习的新方法,效果出奇地好

英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
大模型战争下半场:谁还愿意一直租用 AI?

闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
ICML26 重磅成果!清华 UDS 智能筛选训练样本,大模型微调算力直接减半

大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
ICML 2026 | 当大模型开始发明自己的语言:如何让 LLM 用更少 Token 完成高强度推理

CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
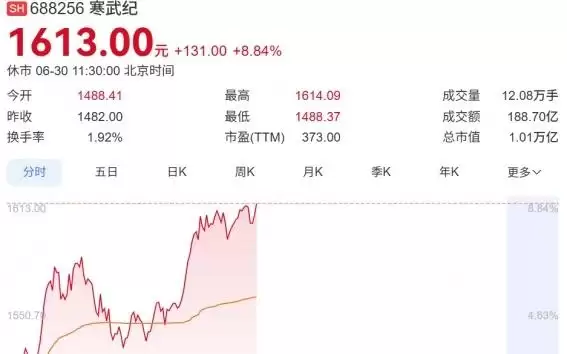
国产算力股集体拉升,美团发布首个全国产训推万亿参数大模型

6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。
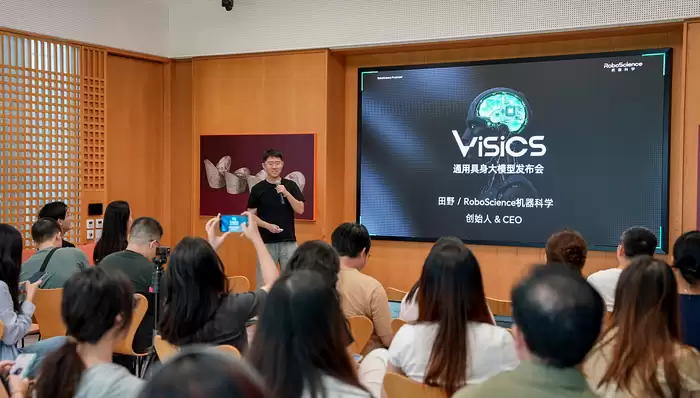
前苹果AI Platform技术负责人,回国加入具身大模型战场

前苹果AI平台技术负责人田野回国创立RoboScience机器科学,发布VLOA架构,通过物体轨迹解耦硬件,利用互联网视频和仿真生成海量数据,将单条数据成本降至几分钱,实现机器人读说明书拼装家具等复杂任务。
纳睿雷达(688522.SH)发布新产品“睿宸”超精细化短时临近AI气象大模型等

纳睿雷达发布两款新品:S波段全极化多功能有源相控阵雷达可实时监测超460公里范围内中小尺度强对流天气并预警灾害;超精细化短时临近AI气象大模型实现0-24小时致灾强对流天气精准预报,分辨率达分钟级街道级。


查看更多
精品专题 更多
装机必备
装机必备

正软商城装机必备专区,精选办公、浏览器、安全防护、影音播放、压缩解压、设计创作和系统工具等电脑常用正版软件,帮助用户快速完成新电脑软件配置。

Windows
Windows

正软商城Windows软件专区,汇集适用于Windows电脑的办公、设计、安全防护、影音播放、开发工具和系统优化软件,提供软件介绍、系统要求、正版授权及购买下载服务。

macOS软件
macOS软件

正软商城macOS软件专区,精选适用于Mac电脑的办公、设计、影音、效率、开发和系统工具,提供软件功能介绍、macOS兼容版本、正版授权及购买下载服务。

Mac软件 更多
灵活计算器
灵活计算器
macOS/iOS/Android

灵活计算器是一款笔记式算数应用,支持实时计算、动态关联和云端同步功能。记录、整理和输出之间的过渡会更自然,适合长期写作、做笔记或持续沉淀个人内容。

赤友清理大师
赤友清理大师
macOS

赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

极度公式
极度公式
Windows/macOS/Linux

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

WINDOWS 更多
Windows 10
Windows 10
Windows

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式
极度公式
Windows/macOS/Linux

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。

密码键盘
密码键盘
Windows/macOS/iOS/Android

密码键盘是一款兼具安全性与便捷性的高效密码管理器。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。