

数据预处理在模型训练中的重要性问题
数据预处理在模型训练中的重要性及具体代码示例引言:在进行机器学习和深度学习模型的训练过程中,数据预处理是一个非常重要且必不可少的环节。数据预处理的目的是通过一系列的处理步骤,将原始数据转化为适合模型训练的形式,以提高模型的性能和准确度。本文旨在探讨数据预处理在模型训练中的重要性,并给出一些常用的数据预处理代码示例。一、数据预处理的重要性数据清洗数据清洗是数据
数据预处理在模型训练中的重要性及具体代码示例
引言:
在进行机器学习和深度学习模型的训练过程中,数据预处理是一个非常重要且必不可少的环节。数据预处理的目的是通过一系列的处理步骤,将原始数据转化为适合模型训练的形式,以提高模型的性能和准确度。本文旨在探讨数据预处理在模型训练中的重要性,并给出一些常用的数据预处理代码示例。
一、数据预处理的重要性
- 数据清洗
数据清洗是数据预处理的第一步,其目的是处理原始数据中的异常值、缺失值、噪音等问题。异常值是指与正常数据明显不符的数据点,如果不进行处理,可能会对模型的性能造成很大影响。缺失值是指在原始数据中部分数据缺失的情况,常用的处理方法包括删除包含缺失值的样本、使用均值或中位数填充缺失值等。噪音是指数据中包含的误差等不完整或错误信息,通过合适的方法去除噪音,可以提高模型的泛化能力和鲁棒性。
- 特征选择
特征选择是根据问题的需求,从原始数据中挑选出最相关的特征,以降低模型复杂度和提高模型性能。对于高维数据集,过多的特征不仅会增加模型训练的时间和空间消耗,同时也容易引入噪音和过拟合问题。因此,合理的特征选择是非常关键的。常用的特征选择方法有过滤法、包装法和嵌入法等。
- 数据标准化
数据标准化是将原始数据按照一定的比例进行缩放,使其落入一定的区间内。数据标准化常用于解决数据特征之间量纲不统一的问题。在进行模型的训练和优化时,不同维度上的特征可能具有不同的重要性,数据标准化可以使得不同维度上的特征具有相同的比重。常用的数据标准化方法有均值方差归一化和最大最小值归一化等。
二、数据预处理的代码示例
我们以一个简单的数据集为例,来展示数据预处理的具体代码示例。假设我们有一个人口统计数据集,包含年龄、性别、收入等特征,并且有一个标签列表示是否购买某个商品。
import pandas as pd
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.feature_selection import SelectKBest, chi2
from sklearn.model_selection import train_test_split

# 读取数据集
data = pd.read_csv("population.csv")

# 数据清洗
data = data.dropna()  # 删除包含缺失值的样本
data = data[data["age"] > 0]  # 删除异常年龄的样本

# 特征选择
X = data.drop(["label"], axis=1)
y = data["label"]
selector = SelectKBest(chi2, k=2)
X_new = selector.fit_transform(X, y)

# 数据标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X_new)

# 数据集划分
X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2, random_state=42)以上代码中,我们使用Pandas库读取数据集,并通过dropna()方法删除包含缺失值的样本,通过data["age"] > 0选取正常年龄的样本。接下来,我们使用SelectKBest方法进行特征选择,其中chi2表示使用卡方检验进行特征选择,k=2表示选择最重要的两个特征。然后,我们使用StandardScaler方法对选取的特征进行数据标准化。最后,我们使用train_test_split方法将数据集划分为训练集和测试集。
结论:
数据预处理在模型训练中的重要性不可忽视。通过合理的数据清洗、特征选择和数据标准化等预处理步骤,可以提高模型的性能和准确度。本文通过给出一个简单的数据预处理代码示例,展示了数据预处理的具体方法和步骤。希望读者能够在实际应用中灵活运用数据预处理技术,以提高模型的效果和应用价值。
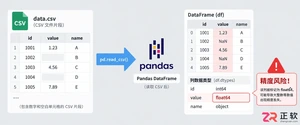
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
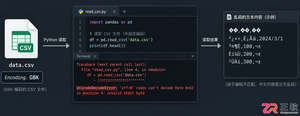
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
数据清洗中过度使用Stream操作会导致内存内耗严重,原因包括惰性求值引发全量物化、中间对象链加重GC负担、装箱拆箱使内存翻倍,以及分支反复遍历同一数据。传统循环仅占用恒定内存,建议采用按需供给、单次遍历和原生数组优化。
数据清洗中,文本格式不统一是常见难题。SUBSTITUTE函数能精准替换指定内容,适用于多种场景:可进行基础单次替换;通过参数选择替换第N次出现的字符;通过嵌套实现批量符号统一;结合CHAR函数清理不可见字符;其区分大小写的特性利于精准控制。掌握这些用法能有效解决多数文本清洗问题。
Excel透视表结果不对劲?十有八九是源数据在“捣鬼”。一套标准的“纠错六步法”送给你:先揪出错误数据,再清理那些看不见的字符,接着修复文本数字和混乱的日期格式,然后摆平缺失值和异常值,之后果断删除重复记录,最后别忘了刷新并验证你的透视表。 有没有遇到过这种情况?在Excel里埋头苦干,好不容易做出
选用 LongAdder 而非 AtomicInteger 是因高并发下其分段累加机制可避免 CAS 争抢,实测性能提升 5–8 倍;需在业务规则失败处统一调用 increment(),确保语义准确,并在任务完成后调用 sum() 获取最终值。 为什么不用 AtomicInteger 而选 Long
<p>在Excel中合并不同格式数字并标准化需先统一格式再合并和标准化。1.使用TEXT函数如=TEXT(A1,"0.00")将数字转为统一文本格式,含货币或百分比的单元格先去符号后转换;2.用CONCATENATE或&运算符合并数据,可添加分隔符;3.标准化采用Z-Score=(x-μ)/σ或Min-Max=(x-min)/(max-min)公式处理。对于文本格式数字导致的计算错误,可用VALUE函数转换或点击错误提示选择“转换为数字”。处理大量数据时避免公式低效的方法包括编写VBA
在数据清洗管道中实现“跳过错误记录+生成错误报告”双机制的方法是:1.在每个关键步骤使用try-except块捕获异常,确保流程不中断;2.在except块中记录错误信息至日志文件或数据库;3.通过continue或默认值跳过错误记录;4.将机制集成到所有数据转换环节;5.定期分析错误报告并优化清洗规则。对于错误报告格式,小数据量可选CSV/JSON,大数据量适合数据库表。在Spark中可通过try-except捕获异常并结合广播变量或mapPartitions方法收集错误信息。应对数据质量问题导致的数据
PHP数据清洗是将脏数据转换为干净数据的过程,脏数据包括格式不统一、缺失值、重复项、错误数据等。解决方案包括字符串处理(trim(),str_replace(),strtolower(),preg_replace())、数组操作(array_unique(),array_filter(),array_map())、类型转换(intval(),floatval(),strval())、数据验证(正则表达式或自定义函数)以及缺失值处理(isset(),empty())。针对乱码问题,需确保PHP文件、数据库和

Python调用阿里云接口,实现数据清洗功能在数据处理的过程中,数据清洗是必不可少的一环。而使用云服务提供商的API接口来实现数据清洗功能,可以提高效率和准确性。本文将介绍如何使用Python调用阿里云接口来实现数据清洗。首先,我们需要在阿里云控制台中开通阿里云API网关和数据清洗服务。开通完成后,我们可以获得相应的APIKey和APISecret,这将





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



