

C语言实现LRU缓存:哈希表与链表结合应用
C语言实现LRU缓存的核心在于结合哈希表与双向链表。1.哈希表用于快速查找,时间复杂度为O(1);2.双向链表维护访问顺序,最近使用项置于头部,最久未用项置于尾部;3.缓存项结构包含key、value及前后指针;4.初始化时分配内存并初始化哈希表和互斥锁;5.获取缓存时命中则移动至链表头部;6.设置缓存时若存在则更新并移动,否则新建节点插入头部并可能淘汰尾部节点;7.使用链地址法处理哈希冲突,头插法插入节点;8.通过添加pthread互斥锁解决线程安全问题,在操作缓存前加锁,操作后解锁;9.哈希函数选择需
C语言实现LRU缓存的核心在于结合哈希表与双向链表。1. 哈希表用于快速查找,时间复杂度为O(1);2. 双向链表维护访问顺序,最近使用项置于头部,最久未用项置于尾部;3. 缓存项结构包含key、value及前后指针;4. 初始化时分配内存并初始化哈希表和互斥锁;5. 获取缓存时命中则移动至链表头部;6. 设置缓存时若存在则更新并移动,否则新建节点插入头部并可能淘汰尾部节点;7. 使用链地址法处理哈希冲突,头插法插入节点;8. 通过添加pthread互斥锁解决线程安全问题,在操作缓存前加锁,操作后解锁;9. 哈希函数选择需考虑均匀性、高效性和简单性,如MurmurHash、FNV-1a或DJB2等,以提升性能。
C语言实现LRU缓存,核心在于结合哈希表快速查找和双向链表维护访问顺序。哈希表用于O(1)时间复杂度查找缓存项,双向链表则用于记录缓存项的使用情况,最近使用的放在链表头部,最久未使用的放在尾部。
解决方案
数据结构定义:
typedef struct CacheNode {
    char *key;
    void *value;
    struct CacheNode *prev;
    struct CacheNode *next;
} CacheNode;

typedef struct LRUCache {
    size_t capacity;
    size_t size;
    CacheNode *head;
    CacheNode *tail;
    // 哈希表,存储 key -> CacheNode* 的映射
    CacheNode **table;
} LRUCache;
初始化LRU缓存:
LRUCache* lruCacheCreate(size_t capacity) {
    LRUCache* cache = (LRUCache*)malloc(sizeof(LRUCache));
    cache->capacity = capacity;
    cache->size = 0;
    cache->head = NULL;
    cache->tail = NULL;
    cache->table = (CacheNode**)calloc(capacity, sizeof(CacheNode*)); // 哈希表初始化
    return cache;
}
哈希函数(简单示例):
unsigned long hash(const char *key) {
    unsigned long hash = 5381;
    int c;

    while ((c = *key++))
        hash = ((hash << 5) + hash) + c; /* hash * 33 + c */

    return hash;
}
获取缓存项:
void* lruCacheGet(LRUCache* cache, const char *key) {
    unsigned long index = hash(key) % cache->capacity;
    CacheNode* node = cache->table[index];

    // 查找哈希表中是否存在该key
    while (node != NULL) {
        if (strcmp(node->key, key) == 0) {
            // 命中缓存,将节点移动到链表头部
            // 1. 从链表中移除
            if (node->prev != NULL) {
                node->prev->next = node->next;
            } else {
                cache->head = node->next; // 如果是头节点,更新头节点
            }

            if (node->next != NULL) {
                node->next->prev = node->prev;
            } else {
                cache->tail = node->prev; // 如果是尾节点,更新尾节点
            }

            // 2. 将节点添加到链表头部
            node->prev = NULL;
            node->next = cache->head;
            if (cache->head != NULL) {
                cache->head->prev = node;
            }
            cache->head = node;

            if (cache->tail == NULL) {
                cache->tail = node; // 如果是第一个节点,同时更新尾节点
            }

            return node->value;
        }
        node = node->next; // 哈希冲突,链表解决
    }

    return NULL; // 未找到
}
设置缓存项:
void lruCachePut(LRUCache* cache, const char *key, void *value) {
    unsigned long index = hash(key) % cache->capacity;
    CacheNode* existingNode = cache->table[index];

    // 检查key是否已存在
    while (existingNode != NULL) {
        if (strcmp(existingNode->key, key) == 0) {
            // Key已存在,更新value并移动到链表头部
            existingNode->value = value;
            // 移动到头部 (同get操作)
            if (existingNode->prev != NULL) {
                existingNode->prev->next = existingNode->next;
            } else {
                cache->head = existingNode->next;
            }

            if (existingNode->next != NULL) {
                existingNode->next->prev = existingNode->prev;
            } else {
                cache->tail = existingNode->prev;
            }

            existingNode->prev = NULL;
            existingNode->next = cache->head;
            if (cache->head != NULL) {
                cache->head->prev = existingNode;
            }
            cache->head = existingNode;

            if (cache->tail == NULL) {
                cache->tail = existingNode;
            }
            return;
        }
        existingNode = existingNode->next; // 处理哈希冲突
    }

    // Key不存在,创建新节点
    CacheNode* newNode = (CacheNode*)malloc(sizeof(CacheNode));
    newNode->key = strdup(key); // 复制key,避免外部修改
    newNode->value = value;
    newNode->prev = NULL;
    newNode->next = cache->head;

    if (cache->head != NULL) {
        cache->head->prev = newNode;
    }
    cache->head = newNode;

    if (cache->tail == NULL) {
        cache->tail = newNode;
    }

    // 添加到哈希表
    newNode->next = cache->table[index]; // 头插法解决哈希冲突
    cache->table[index] = newNode;

    cache->size++;

    // 如果超出容量,移除链表尾部节点
    if (cache->size > cache->capacity) {
        CacheNode* tailNode = cache->tail;
        if (tailNode != NULL) {
            // 1. 从链表中移除
            cache->tail = tailNode->prev;
            if (cache->tail != NULL) {
                cache->tail->next = NULL;
            } else {
                cache->head = NULL; // 链表为空
            }

            // 2. 从哈希表中移除(需要遍历哈希表对应链表)
            unsigned long tailIndex = hash(tailNode->key) % cache->capacity;
            CacheNode* current = cache->table[tailIndex];
            CacheNode* prev = NULL;
            while (current != NULL) {
                if (current == tailNode) {
                    if (prev == NULL) {
                        cache->table[tailIndex] = current->next; // 移除头节点
                    } else {
                        prev->next = current->next;
                    }
                    break;
                }
                prev = current;
                current = current->next;
            }

            free(tailNode->key);
            free(tailNode);
            cache->size--;
        }
    }
}
释放LRU缓存:
void lruCacheFree(LRUCache* cache) {
    CacheNode* current = cache->head;
    while (current != NULL) {
        CacheNode* next = current->next;
        free(current->key);
        free(current);
        current = next;
    }
    free(cache->table);
    free(cache);
}
C语言LRU缓存实现中的哈希冲突如何处理?
在lruCachePut函数中,当计算出的哈希索引对应的位置已经存在节点时,采用链地址法解决冲突。新的节点会以头插法的方式插入到哈希表对应索引的链表中。在lruCacheGet函数中,如果发生哈希冲突,会遍历链表,直到找到匹配的key。
C语言实现LRU缓存的线程安全性问题
上述代码并非线程安全。在多线程环境下,对缓存的并发访问可能导致数据竞争和不一致。例如,多个线程同时尝试插入或删除节点,可能导致链表结构损坏或哈希表数据不一致。
为了实现线程安全,需要使用互斥锁(mutex)来保护对缓存数据结构的访问。
添加互斥锁: 在
LRUCache结构体中添加一个互斥锁成员。typedef struct LRUCache { size_t capacity; size_t size; CacheNode *head; CacheNode *tail; CacheNode **table; pthread_mutex_t mutex; // 互斥锁 } LRUCache;初始化互斥锁: 在
lruCacheCreate函数中初始化互斥锁。LRUCache* lruCacheCreate(size_t capacity) { // ... 其他初始化代码 ... pthread_mutex_init(&cache->mutex, NULL); // 初始化互斥锁 return cache; }加锁和解锁: 在
lruCacheGet、lruCachePut和lruCacheFree函数中,在访问或修改缓存数据结构之前加锁,操作完成后解锁。void* lruCacheGet(LRUCache* cache, const char *key) { pthread_mutex_lock(&cache->mutex); // 加锁 // ... 缓存访问代码 ... pthread_mutex_unlock(&cache->mutex); // 解锁 return result; } void lruCachePut(LRUCache* cache, const char *key, void *value) { pthread_mutex_lock(&cache->mutex); // 加锁 // ... 缓存修改代码 ... pthread_mutex_unlock(&cache->mutex); // 解锁 } void lruCacheFree(LRUCache* cache) { pthread_mutex_lock(&cache->mutex); // 加锁 // ... 缓存释放代码 ... pthread_mutex_unlock(&cache->mutex); // 解锁 pthread_mutex_destroy(&cache->mutex); // 销毁互斥锁 // ... 其他释放代码 ... }
如何选择合适的哈希函数以提高LRU缓存性能?
哈希函数的选择对LRU缓存的性能至关重要。一个好的哈希函数应该具有以下特点:
- 均匀性: 哈希函数应该将不同的key均匀地映射到哈希表的各个槽位,避免出现大量的哈希冲突。
- 高效性: 哈希函数的计算速度应该足够快,以减少缓存操作的延迟。
- 简单性: 哈希函数的实现应该简单易懂,方便维护和调试。
一些常用的哈希函数包括:
- MurmurHash: 一种非加密哈希函数,具有良好的均匀性和高效性。
- FNV-1a: 另一种非加密哈希函数,实现简单,性能也不错。
- DJB2: 一种经典的哈希函数,广泛应用于各种场景。
选择哈希函数时,需要根据具体的应用场景进行权衡。如果对性能要求非常高,可以考虑使用MurmurHash或FNV-1a。如果对实现简单性要求较高,可以使用DJB2。此外,还可以根据key的特点选择特定的哈希函数,例如,如果key是字符串,可以使用专门为字符串设计的哈希函数。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。
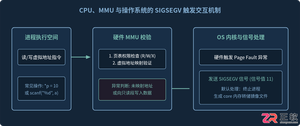
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
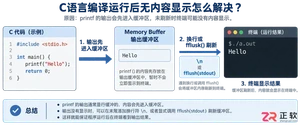
本文详细解析C语言程序编译成功但运行时无内容显示的常见原因,包括输出缓冲区未刷新、程序立即退出、条件分支未命中及IDE配置问题,提供针对性的代码示例和排查步骤。
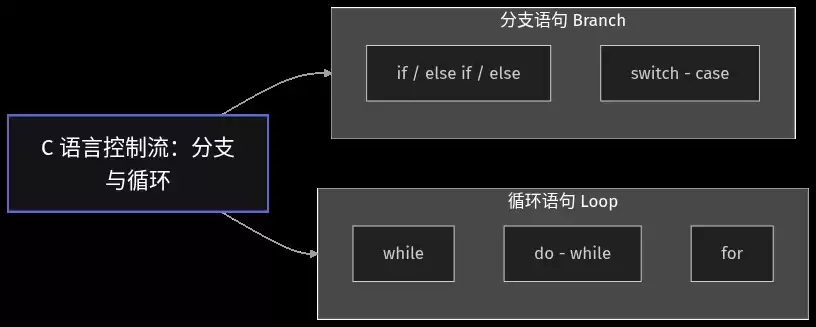
C语言程序执行顺序由分支与循环语句控制。分支语句包括if-else和switch-case,用于条件判断与多路选择;循环语句包括while、do-while和for,实现重复执行。break可跳出循环,continue跳过本次剩余代码。掌握这些控制流语句是编写逻辑程序的基础。
学习编程的核心是解决问题,而非掌握编程语言本身。编程语言只是工具,真正的重点在于推理、算法和逻辑。沉迷于语言学习反而会忽视编程的本质,即通过编程语言实现自动解决问题。
编程是编写程序指令,让设备按意图运行,常用Python、C等语言或Scratch图形化编程。学习编程能跟上科技时代,锻炼自学与解决问题能力,提升逻辑思维,代表行动力,推动事物前进。各司其职,编程者尽本分。
双非大一计科新生与编程相遇后,生活发生巨变。他通过网课、书籍、项目及竞赛,每天利用课余时间投入四小时以上练习,从零基础起步,坚持不懈。立志进入腾讯,用编程解决实际问题,实现自我价值。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



