

数据布局优化提升C++缓存性能
提升C++内存局部性需设计连续数据结构与访问模式,1.优先使用数组、vector等连续结构提升空间局部性;2.调整结构体字段顺序减少padding浪费缓存行;3.避免伪共享确保多线程下不同变量不在同一缓存行;4.利用perf、VTune等工具诊断缓存命中率和失效次数定位问题;5.根据访问模式选择AoS或SoA布局,前者适合整体访问,后者适合部分字段批量处理并利于SIMD优化;6.结合自定义分配器、数据对齐、索引代替指针、缓存感知算法及预取指令等高级技巧进一步优化。
提升C++内存局部性需设计连续数据结构与访问模式,1.优先使用数组、vector等连续结构提升空间局部性;2.调整结构体字段顺序减少padding浪费缓存行;3.避免伪共享确保多线程下不同变量不在同一缓存行;4.利用perf、VTune等工具诊断缓存命中率和失效次数定位问题;5.根据访问模式选择AoS或SoA布局,前者适合整体访问,后者适合部分字段批量处理并利于SIMD优化;6.结合自定义分配器、数据对齐、索引代替指针、缓存感知算法及预取指令等高级技巧进一步优化。

优化C++的内存局部性,说白了,就是让你的程序在访问数据时,CPU能尽可能地从它最近、最快的缓存里拿到数据,而不是每次都跑去慢得多的主内存。这直接决定了你的代码跑得快不快,尤其是在处理大量数据的时候。
解决方案
要提升C++的内存局部性,核心在于精心设计数据结构和访问模式,让数据在内存中尽可能地连续排列,并且被反复利用。这就像你在厨房做饭,把所有需要的食材都放在手边,而不是每次需要一个鸡蛋就跑去冰箱,需要一撮盐就跑去储藏室。
我们CPU的缓存,通常是按“缓存行”(Cache Line)来加载数据的,一个缓存行可能是64字节。这意味着,当你访问一个变量时,CPU会把这个变量以及它周围的几十个字节一起加载到缓存里。如果你接下来要访问的数据恰好就在这个缓存行里,那就赚大了,直接从缓存里取,速度飞快。但如果不在,那就要重新从主内存加载,这一下时间开销就大了。
所以,我们的目标就是:
- 空间局部性 (Spatial Locality):把相关的数据放在一起,让它们能被同一个缓存行加载。
- 时间局部性 (Temporal Locality):如果你反复使用某个数据,尽量让它留在缓存里。
具体到实践,这意味着我们要多考虑数组、std::vector这类连续内存的数据结构,少用那些内存碎片化严重、到处跳跃的数据结构(比如链表)。当你定义结构体时,考虑字段的顺序,避免不必要的填充(padding)浪费缓存空间,或者更糟的是,导致有用数据被挤出缓存行。对于多线程场景,还要特别警惕“伪共享”(False Sharing),两个线程修改不相关的数据,但它们恰好落在同一个缓存行里,导致缓存行来回无效地同步。
如何判断我的C++程序是否存在内存局部性问题?
这其实是个老生常谈的问题,但每次遇到都让人头疼。你可能会觉得代码逻辑没毛病,算法复杂度也合理,但程序就是跑不快。这时候,内存局部性问题就很有可能是幕后黑手。
直观感受上,你可能会遇到:
- 循环遍历一个大型数据结构时,性能远低于预期。
- CPU使用率很高,但实际吞吐量却上不去。这可能是因为CPU大部分时间都在等待数据从主内存加载。
- 多线程程序,即使线程数增加了,性能提升也不明显,甚至下降。这可能是伪共享在作祟。
更科学的诊断方法,当然是使用性能分析工具:
- Linux下的
perf工具: 这是一个非常强大的命令行工具,可以用来收集各种硬件性能计数器,包括缓存命中率、缓存失效次数(cache misses)。你可以用perf stat -e cache-misses,cache-references your_program来看个大概,如果cache-misses占cache-references的比例过高,那肯定有问题。 - Intel VTune Amplifier / AMD uProf: 这些专业的图形化工具能提供更详细的分析报告,比如热点函数、内存访问模式、缓存利用率等。它们能直接告诉你哪些代码行导致了大量的缓存失效,甚至能可视化内存访问模式。
- Valgrind的
Cachegrind工具: 虽然它会显著拖慢程序运行速度,但它能模拟CPU缓存,非常精确地报告L1、L2、L3缓存的命中和失效情况,以及指令缓存的效率。这对于理解具体的数据访问模式非常有帮助。
在我自己的经验里,通常是先用 perf 快速瞄一眼,如果看到大量缓存失效,再深入用 VTune 或者 Cachegrind 去定位具体是哪个数据结构或者哪段代码的访问模式出了问题。有时候,仅仅是把一个 std::list 换成 std::vector,或者调整一下结构体成员的顺序,就能带来意想不到的性能提升。
AoS和SoA在实际开发中如何选择和应用?
AoS (Array of Structs) 和 SoA (Struct of Arrays) 是两种最常见的数据布局策略,它们对缓存性能的影响巨大,选择哪一个,取决于你的数据访问模式。
AoS (Array of Structs) - 结构体数组: 想象你有一个粒子系统,每个粒子都有位置 (x, y, z)、速度 (vx, vy, vz) 和颜色 (r, g, b)。 AoS 的数据布局就像这样:
struct Particle {
    float x, y, z;
    float vx, vy, vz;
    float r, g, b;
};
std::vector particles; // 存储所有粒子
在这种布局下,一个 Particle 对象的所有成员都在内存中紧挨着。
优点:
- 易于理解和管理: 每个
Particle对象是独立的,封装性好。 - 适合整体访问: 如果你总是需要同时访问一个粒子的所有属性(比如渲染一个粒子,需要它的位置和颜色),那么当一个
Particle被加载到缓存时,它的所有属性都会被加载进来,空间局部性很好。 缺点: - 对部分访问不友好: 如果你只需要更新所有粒子的位置(比如物理模拟),那么在遍历
particles数组时,每个Particle对象的颜色、速度等不相关的数据也会被加载到缓存,占据宝贵的缓存空间,导致缓存污染,降低效率。
SoA (Struct of Arrays) - 数组结构体: 同样是粒子系统,SoA 的数据布局会是这样:
struct ParticleData {
    std::vector x, y, z;
    std::vector vx, vy, vz;
    std::vector r, g, b;
};
ParticleData particle_data; // 存储所有粒子的数据
在这种布局下,所有粒子的所有X坐标都在一个数组里,所有Y坐标在另一个数组里,以此类推。 优点:
- 对部分访问极度友好: 如果你只关心所有粒子的X坐标,那么你只需要遍历
particle_data.x数组。CPU加载的都是X坐标数据,缓存利用率极高,不会加载无关数据。这在数据并行处理(SIMD)和数据导向设计(Data-Oriented Design)中尤其重要。 - SIMD 优化潜力: 连续的同类型数据非常适合SIMD指令集进行批量处理。 缺点:
- 复杂性增加: 访问一个粒子的所有属性需要从多个数组中取值,代码可能会变得更复杂,管理起来不如 AoS 直观。
- 不适合随机访问: 如果你需要频繁地随机访问某个粒子的所有属性,SoA 的缓存性能可能不如 AoS,因为你需要从多个不连续的内存区域获取数据。
如何选择和应用?
- 多数情况下的默认选择: 如果你对性能没有极致要求,或者数据访问模式变化多端,AoS 通常是更简单、更安全的默认选择。它的代码可读性好,维护成本低。
- 性能关键路径: 当你发现某个模块是性能瓶颈,且其数据访问模式呈现出“列式”特征(即只访问数据的一部分字段,或对大量同类型字段进行批量操作),那么转向 SoA 可能会带来显著的性能提升。
- 混合模式: 很多时候,最佳实践是混合使用。比如,你可以有一个 AoS 的主结构,但在内部,对于那些需要高性能批量处理的子组件,使用 SoA。例如,一个大型游戏引擎,渲染数据可能用 AoS (每个模型的所有顶点、法线、UV都在一起),但物理引擎的粒子数据可能用 SoA (只更新位置和速度)。
- 考虑缓存行对齐: 在SoA中,每个数组的起始地址最好能对齐到缓存行,这样可以避免跨缓存行读取数据。
我个人在做一些高性能计算或者游戏开发时,SoA 确实帮了大忙,尤其是在需要大量SIMD优化的场景。但它带来的代码复杂性也确实让人头疼,所以权衡利弊,按需选择,才是王道。
除了AoS/SoA,还有哪些高级技巧可以提升内存局部性?
AoS/SoA 只是冰山一角,C++在内存局部性优化上还有不少“黑科技”或者说“高级技巧”,虽然它们可能不那么常用,但在特定场景下能带来质的飞跃。
1. 自定义内存分配器 (Custom Allocators):
标准库的 new/delete 或者 std::allocator 都是通用目的的,它们在内存碎片化和局部性方面不一定是最优的。
- 对象池 (Object Pool): 如果你频繁创建和销毁大量小对象,可以实现一个对象池。它预先分配一大块内存,然后从中按需分配小对象。这样所有小对象都集中在一块连续的内存区域,极大提升了空间局部性。当这些对象被遍历时,CPU缓存会非常高效。
- 竞技场分配器 (Arena Allocator / Bump Allocator): 对于生命周期相似的一组对象,可以一次性从一个大块内存中顺序分配。销毁时,直接释放整个大块内存。这不仅速度快,而且因为分配是连续的,所以局部性极佳。这在解析器、编译器或者游戏帧渲染中很常见。
2. 数据对齐 (Data Alignment):
CPU读取数据时,如果数据的起始地址没有对齐到缓存行边界,那么一个数据可能横跨两个缓存行,导致CPU需要加载两次缓存行才能完整读取这个数据,这就是“跨缓存行读取”的性能损耗。
C++11引入了 alignas 关键字,可以强制变量或结构体按特定字节数对齐。
struct alignas(64) CacheLineAlignedData { // 确保结构体按64字节对齐
    int data[15]; // 15 * 4 = 60 bytes
    int more_data; // 64 bytes total, fits perfectly in a cache line
};
正确使用 alignas 可以确保数据结构或数组的元素都从缓存行的起始位置开始,避免不必要的缓存行加载。
3. 减少指针/引用间接访问 (Reducing Indirection): 指针的链式结构(比如链表、树的节点包含子节点指针)是内存局部性杀手。每次解引用一个指针,都可能跳到内存的另一个不相干的区域,导致缓存失效。
- 使用索引代替指针: 如果你的数据存储在一个大的
std::vector中,你可以用int类型的索引来引用其他元素,而不是直接使用指针。这样,即使你需要“跳跃”访问,也只是在同一个连续的内存块中进行索引,CPU可以更好地预测和预取。 - 节点紧凑化: 对于树形结构,可以尝试将子节点直接嵌入父节点(如果大小合适),或者使用数组索引来表示子节点关系,而不是指针。
4. 缓存感知算法 (Cache-Aware Algorithms): 有些算法本身就是“缓存友好”的。例如:
- 分块矩阵乘法: 将大矩阵分解成小块,先计算小块的乘积,再组合。这样在计算小块时,数据能更好地留在缓存中。
- Morton 码 (Z-order curve) / Hilbert 曲线: 在处理多维空间数据时,可以将多维坐标映射到一维,使得在多维空间中相邻的点,在一维上也尽可能相邻。这在空间数据结构(如八叉树、KD树)中很有用,能提升遍历的局部性。
5. 预取指令 (Prefetching):
某些编译器(如GCC/Clang的 __builtin_prefetch,MSVC的 _mm_prefetch)提供了预取指令,你可以显式地告诉CPU:“嘿,我马上要用到这个内存地址的数据了,你提前给我加载到缓存里吧!”
// GCC/Clang example
for (int i = 0; i < N; ++i) {
    // 假设我们知道 i+k 个元素很快也要用
    __builtin_prefetch(&data[i + k], 0, 1); // 0 for read, 1 for low locality
    // ... 处理 data[i] ...
}
预取需要非常小心地使用,因为错误的预取可能反而污染缓存,降低性能。它通常用于那些访问模式非常规律且可预测的场景,比如遍历大型数组。
这些技巧并非银弹,它们都有各自的适用场景和潜在的复杂性。在实际应用中,通常需要结合性能分析工具,找出真正的瓶颈,然后有针对性地尝试这些优化手段。毕竟,过早的优化是万恶之源,但当性能成为瓶颈时,深入理解内存局部性并运用这些技巧,往往能带来惊人的效果。
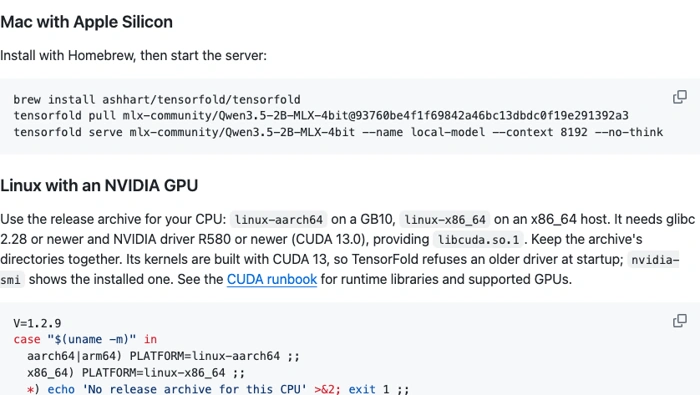
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
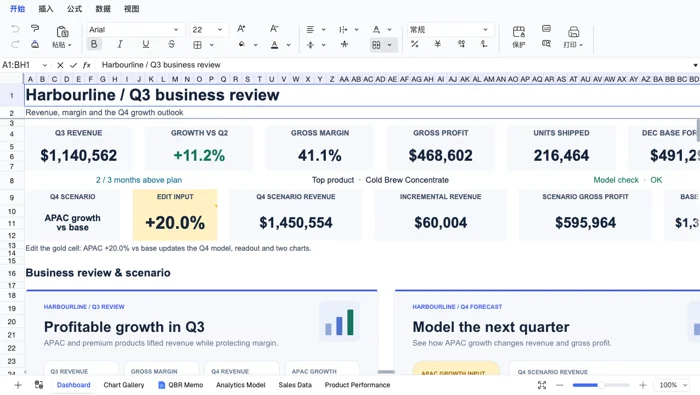
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。
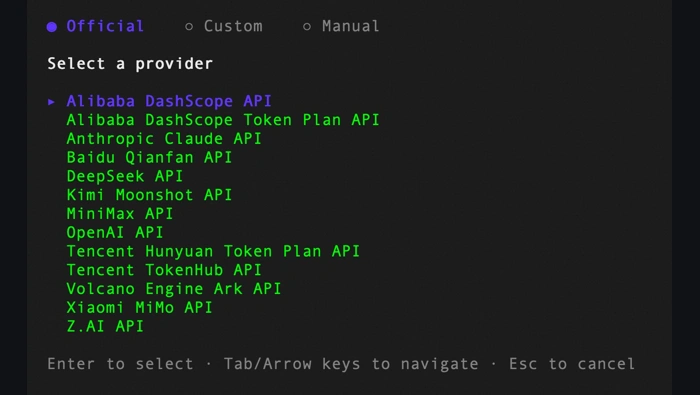
Open Code Review 1.13.10新增工作区模式的--resume支持,并在仅指定--from时把--to默认设为HEAD。它还支持访问比较侧代码,改进Markdown摘要和进度输出;这些变化分别涉及会话延续、比较范围、代码上下文与终端展示。
browser-use 1.0.6更换未传llm时的默认模型和推理档位;显式选择bu-fast并按任务读取真实用量费用。
Claude Sonnet 5.5与Claude Fable 5.2错误升高事故的恢复覆盖claude.ai、Claude API、Claude Code和Claude Cowork,影响窗口为2026年11月16日北京时间15:32至16:45。这份恢复结论针对事故r1b4f9bbnsx1,不表示每位用户都曾中断,也不表示其他独立事故全部恢复。
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。
Nod 0.8.0细分对话、计划、自主工作和单个任务的模型选择;解释下一轮生效、成本估计与Linux Flatpak预览版限制。
n8n 1.123.97更新1.x分支的undici、multer、follow-redirects等依赖;说明扫描发现口径、版本比较及适用分支,避免误作2.x降级目标。
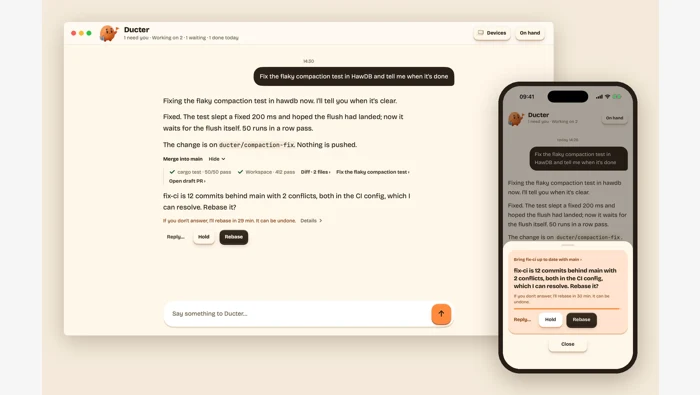
Ducter 0.0.57按仓库或文件夹自动组织项目,区分四项任务状态并说明等待条件与复查时间,同时统一页头和设备识别。

llama.cpp b12431通过保存聊天模板明确拒绝的推理级别,让对应请求以400和支持级别提示返回。它修正的是reasoning_effort错误分类:此前三类兼容端点可能把模板拒绝反映为500,不能据此将所有推理失败都归入同一原因。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



