

机器学习模型的过拟合问题
机器学习模型的过拟合问题及其解决方法在机器学习领域中,模型的过拟合是一个常见且具有挑战性的问题。当一个模型在训练集上表现优秀,但在测试集上表现较差时,就表明该模型出现了过拟合现象。本文将介绍过拟合问题的原因及其解决方法,并提供具体的代码示例。过拟合问题的原因过拟合问题主要是由于模型过于复杂,参数过多所致。当模型的参数过多时,模型会过分关注训练集中的噪声和异常
机器学习模型的过拟合问题及其解决方法
在机器学习领域中,模型的过拟合是一个常见且具有挑战性的问题。当一个模型在训练集上表现优秀,但在测试集上表现较差时,就表明该模型出现了过拟合现象。本文将介绍过拟合问题的原因及其解决方法,并提供具体的代码示例。
- 过拟合问题的原因
过拟合问题主要是由于模型过于复杂,参数过多所致。当模型的参数过多时,模型会过分关注训练集中的噪声和异常值,导致在新的数据上表现较差。此外,数据不足也是导致过拟合问题的原因之一。当训练集中的样本较少,模型容易记住每一个样本的细节,而无法泛化到未见过的数据。 - 解决过拟合的方法
为了解决过拟合问题,我们可以采取以下几种方法:
2.1 数据扩充 (Data Augmentation)
数据扩充是指通过对训练集进行一系列变换,生成更多的样本。例如,在图像分类任务中,可以对图像进行旋转、缩放、翻转等操作来扩充数据。这样做可以增加训练集的大小,帮助模型更好地泛化。
下面是一个使用Keras库进行图像数据扩充的示例代码:
from keras.preprocessing.image import ImageDataGenerator

# 定义数据扩充器
datagen = ImageDataGenerator(
    rotation_range=20,  # 随机旋转角度范围
    width_shift_range=0.1,  # 水平平移范围
    height_shift_range=0.1,  # 垂直平移范围
    shear_range=0.2,  # 剪切变换范围
    zoom_range=0.2,  # 缩放范围
    horizontal_flip=True,  # 随机水平翻转
    fill_mode='nearest'  # 填充模式
)

# 加载图像数据集
train_data = datagen.flow_from_directory("train/", target_size=(224, 224), batch_size=32, class_mode='binary')
test_data = datagen.flow_from_directory("test/", target_size=(224, 224), batch_size=32, class_mode='binary')

# 训练模型
model.fit_generator(train_data, steps_per_epoch=len(train_data), epochs=10, validation_data=test_data, validation_steps=len(test_data))
2.2 正则化 (Regularization)
正则化是通过在模型的损失函数中添加正则化项,对模型的复杂度进行惩罚,从而减少模型的过拟合风险。常见的正则化方法有L1正则化和L2正则化。
下面是一个使用PyTorch库进行L2正则化的示例代码:
import torch
import torch.nn as nn

# 定义模型
class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.fc1 = nn.Linear(10, 10)
        self.fc2 = nn.Linear(10, 1)

    def forward(self, x):
        x = self.fc1(x)
        x = nn.ReLU()(x)
        x = self.fc2(x)
        return x

model = MyModel()

# 定义损失函数
criterion = nn.MSELoss()

# 定义优化器
optimizer = torch.optim.SGD(model.parameters(), lr=0.01, weight_decay=0.001)  # 注意weight_decay参数即为正则化项的系数

# 训练模型
for epoch in range(100):
    optimizer.zero_grad()
    outputs = model(inputs)
    loss = criterion(outputs, labels)
    loss.backward()
    optimizer.step()
2.3 Dropout
Dropout是一种常用的正则化技术,通过在训练过程中随机丢弃一些神经元,来减少模型的过拟合风险。具体来说,在每一次训练迭代中,我们以一定的概率p随机选择一些神经元丢弃。
下面是一个使用TensorFlow库进行Dropout的示例代码:
import tensorflow as tf

# 定义模型
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation=tf.nn.relu, input_shape=(10,)),
    tf.keras.layers.Dropout(0.5),  # dropout率为0.5
    tf.keras.layers.Dense(1)
])

# 编译模型
model.compile(optimizer='adam', loss=tf.keras.losses.BinaryCrossentropy(from_logits=True))

# 训练模型
model.fit(x_train, y_train, epochs=10, validation_data=(x_test, y_test))- 总结
过拟合是机器学习模型中常见的问题,但我们可以采取一些方法来解决它。数据扩充、正则化和Dropout都是常用的解决过拟合问题的方法。我们可以根据具体的应用场景选择合适的方法来处理过拟合问题,并通过调整参数等方法来进一步优化模型的性能。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
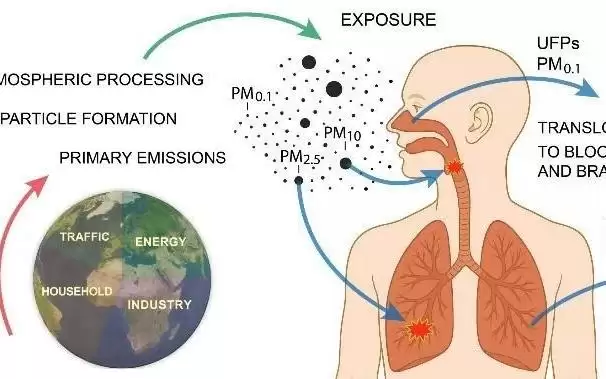
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
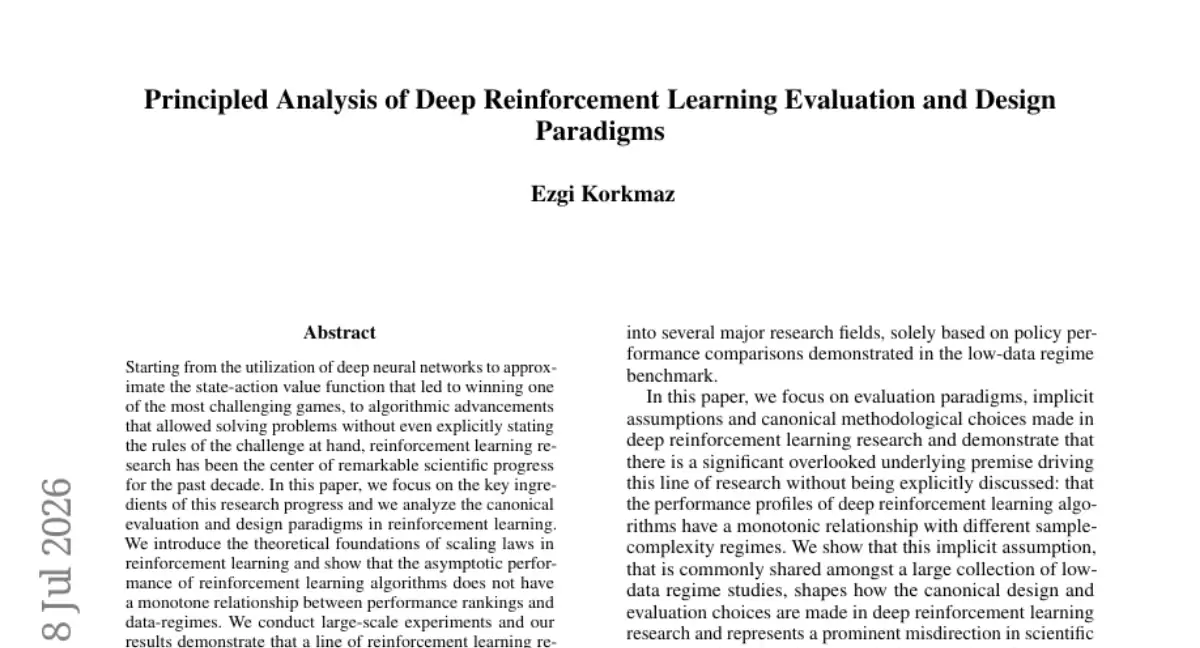
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



