

NumPy数组高效操作:条件替换与值处理
本文深入探讨了如何利用NumPy库高效处理数组中的特定模式,包括在两个数组共同位置为1时,根据回溯最近0的位置进行条件替换,以及如何将数组中连续的1中的第一个1替换为0。通过向量化操作,这些方法显著提升了数据处理的性能和代码的简洁性,避免了低效的迭代。

在数据分析和科学计算中,我们经常需要对大型数组进行复杂的条件判断和值替换。虽然Python的循环结构能够实现这些操作,但对于NumPy数组而言,其性能往往不尽如人意。NumPy提供的向量化操作是解决这类问题的关键,它能够将操作应用于整个数组,从而避免显式的Python循环,极大地提高执行效率。本文将详细介绍两种常见的数组操作场景,并提供基于NumPy的高效解决方案。
场景一:基于回溯最近0的条件替换
问题描述: 给定两个二进制数组arr1和arr2,我们希望找出它们在相同位置都为1的所有索引。对于这些共同为1的位置,我们需要进一步判断:向后追溯(即索引减小方向),哪个数组的1距离最近的0更近?然后将那个“更近0”的数组中的1替换为0。如果两个数组距离最近的0距离相同,则默认替换其中一个(例如arr2)。
迭代方法的局限性: 原始问题中提到的迭代解决方案,通过pandas.DataFrame和嵌套循环来实现,虽然功能上可行,但其效率低下。尤其当数组规模庞大时,每次迭代和条件判断都会带来显著的性能开销,违背了NumPy设计用于高效数值计算的初衷。
NumPy向量化解决方案: NumPy提供了一种巧妙的向量化方法来解决这个问题。核心思想是利用np.maximum.reduceat函数来高效地查找每个共同1位置之前最近的0的索引。
import numpy as np

def closest_zero(arr, arr_idx, n):
    """
    计算在指定索引arr_idx处,arr中向后(索引减小)最近的0的原始索引。

    参数:
    arr (np.array): 输入数组。
    arr_idx (np.array): 需要查找最近0的起始索引数组。
    n (np.array): 包含数组索引的序列,np.arange(arr.size)。

    返回:
    np.array: 对应arr_idx中每个元素,其向后最近0的原始索引。
    """
    # (1 - arr) 将0变为1,1变为0。
    # (1 - arr) * n 将0的索引保留,1的索引变为0。
    # 这样,对于一个1,它前面最近的0的索引就是这个序列中最大的非0值。
    temp_arr = (1 - arr) * n

    # np.r_[0, arr_idx] 创建了新的段边界。
    # np.maximum.reduceat 在这些段内执行最大值归约。
    # 结果[:-1] 去掉了最后一个不相关的最大值。
    return np.maximum.reduceat(temp_arr, np.r_[0, arr_idx])[:-1]

def compare_and_replace(arr1_orig, arr2_orig):
    """
    比较两个数组,并在共同为1的位置,根据向后最近的0进行条件替换。

    参数:
    arr1_orig (list or np.array): 第一个输入数组。
    arr2_orig (list or np.array): 第二个输入数组。

    返回:
    tuple: 包含修改后的arr1和arr2的元组。
    """
    A, B = np.array(arr1_orig), np.array(arr2_orig)
    n = np.arange(A.size) # 原始索引序列

    # 找出arr1和arr2在相同位置都为1的索引
    idx_common_ones = np.where((A == 1) & (B == 1))[0]

    if idx_common_ones.size == 0:
        return A, B # 没有共同的1,直接返回原数组

    # 计算arr1和arr2在这些共同1位置,向后最近的0的索引
    closest_zero_A = closest_zero(A, idx_common_ones, n)
    closest_zero_B = closest_zero(B, idx_common_ones, n)

    # 比较哪个数组的1距离最近的0更远(即最近的0的索引更小,表示0更靠前)
    # 如果closest_zero_A > closest_zero_B,表示arr1的0更靠后,即arr2的0更靠前/更近。
    # 那么我们应该替换arr1中的1。
    # 注意:这里逻辑是“更近0”的那个替换,如果closest_zero_A > closest_zero_B,说明A的0更远,B的0更近。
    # 所以,将B中对应的1替换为0。
    # 原始问题是“figure out which array has the closest "0" looking backwards and replace "1" in that array with "0".”
    # 如果A的0更近,A的1替换为0。如果B的0更近,B的1替换为0。
    # closest_zero值越大,表示0越靠后,即距离当前1越远。
    # 所以,如果 closest_zero_A > closest_zero_B,说明A的0更远,B的0更近,应替换B。
    # 如果 closest_zero_A < closest_zero_B,说明A的0更近,B的0更远,应替换A。

    # idx_to_replace_A 为 True 表示 A 的 0 更近 (closest_zero_A > closest_zero_B 是 B 的 0 更近)
    # 那么 (closest_zero_A < closest_zero_B) 才是 A 的 0 更近

    # 修正逻辑:如果closest_zero_A的值小于closest_zero_B,表示A的0更靠前(更近)。
    # 那么,A中对应的1应该被替换为0。
    replace_A_mask = closest_zero_A < closest_zero_B

    # 如果closest_zero_B的值小于等于closest_zero_A,表示B的0更靠前(更近)或距离相同。
    # 那么,B中对应的1应该被替换为0。
    # 注意:当距离相同时,按照惯例选择一个替换。这里选择替换B。
    replace_B_mask = closest_zero_B <= closest_zero_A

    # 应用替换
    A[idx_common_ones[replace_A_mask]] = 0
    B[idx_common_ones[replace_B_mask]] = 0

    return A, B

# 示例
arr1_ex = np.array([0,1,1,1,0,0,1])
arr2_ex = np.array([1,0,1,1,1,1,1])
result_A, result_B = compare_and_replace(arr1_ex, arr2_ex)
print(f"原始arr1: {arr1_ex}")
print(f"原始arr2: {arr2_ex}")
print(f"处理后arr1: {result_A}")
print(f"处理后arr2: {result_B}")

# 另一个复杂示例
arr1_long = np.array([0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 0, 0, 0, 0, 1, 0, 0, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0, 1, 0, 0, 1, 1, 0, 0, 0, 0, 0, 1, 1, 0, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 0, 0, 1, 0, 0, 1, 0, 0, 0, 1, 1, 1, 1, 1, 0, 0, 1, 1, 1, 1, 0, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 1, 1, 1, 1, 0, 1, 0])
arr2_long = np.array([0, 0, 0, 0, 1, 1, 1, 0, 1, 1, 1, 0, 1, 0, 0, 1, 0, 1, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 1, 0, 0, 0, 0, 1, 1, 1, 0, 0, 0, 0, 0, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 1, 0, 0, 1, 0, 1, 1, 1, 0, 0, 1, 0, 0, 0, 1, 0, 0, 0, 1, 1, 1, 1, 0, 0, 1, 0, 1, 0, 0, 1, 1, 1, 1, 1, 0, 0, 0, 1, 1, 0, 0])
result_A_long, result_B_long = compare_and_replace(arr1_long, arr2_long)
print("\n--- 复杂示例 ---")
print(f"处理后arr1 (长): {result_A_long}")
print(f"处理后arr2 (长): {result_B_long}")
代码解析:
- closest_zero函数是核心。它通过将arr中的0映射到其原始索引,将1映射到0,然后使用np.maximum.reduceat来查找每个指定索引arr_idx之前(或在其位置)的最大索引值。这个最大索引值就代表了向后最近的0的原始位置。
- (1 - arr) * n: 将数组中的0变为1,1变为0,然后乘以索引数组n。结果是:原数组中的0位置变为其索引值,原数组中的1位置变为0。
- np.maximum.reduceat(temp_arr, np.r_[0, arr_idx]): reduceat函数在由np.r_[0, arr_idx]定义的各个“段”内执行maximum操作。例如,对于arr_idx = [i1, i2, ...], 它会计算max(temp_arr[0:i1]), max(temp_arr[i1:i2])等。由于temp_arr中1的位置是0,0的位置是其索引,所以max操作有效地找到了每个段内最右侧(即最大索引)的0的索引。
- compare_and_replace函数首先找出arr1和arr2中都为1的共同位置idx_common_ones。
- 然后,它分别调用closest_zero函数,为每个共同1的位置计算arr1和arr2中向后最近的0的索引。
- 通过比较这两个索引,确定哪个数组的1距离最近的0更近(即closest_zero值更小),然后使用布尔索引将该数组中对应的1替换为0。
这种方法避免了显式循环,利用NumPy底层的C实现,极大地提高了计算效率。
场景二:替换连续的1
问题描述: 给定一个二进制数组,需要将所有后面跟着1的1替换为0。换句话说,如果数组中出现[..., 1, 1, ...], 则将第一个1替换为0,结果变为[..., 0, 1, ...]。
迭代方法的局限性: 同样,使用循环遍历数组并检查arr[i]和arr[i+1]的迭代方法虽然直观,但效率不高,尤其对于大型数组。
NumPy向量化解决方案: NumPy提供了一种非常简洁的“切片技巧”来实现这一操作。
def replace_consecutive_ones(x_orig):
    """
    将数组中所有后面跟着1的1替换为0。

    参数:
    x_orig (list or np.array): 输入数组。

    返回:
    np.array: 修改后的数组。
    """
    x = np.array(x_orig, copy=True) # 创建副本以避免修改原始数组

    # x[:-1] 表示数组中除了最后一个元素之外的所有元素
    # x[1:] 表示数组中除了第一个元素之外的所有元素
    # (x[1:] * x[:-1]) == 1 找出x[i]和x[i+1]都为1的位置
    # 然后将x[:-1]中对应这些位置的元素设置为0
    x[:-1][(x[1:] * x[:-1]) == 1] = 0
    return x

# 示例
arr_c1 = np.array([1, 1, 0, 1, 0, 1, 1, 1])
result_c1 = replace_consecutive_ones(arr_c1)
print(f"\n原始数组: {arr_c1}")
print(f"处理后数组: {result_c1}")

arr_c2 = np.array([0, 1, 1, 0, 1, 1, 1, 0, 0, 1, 1])
result_c2 = replace_consecutive_ones(arr_c2)
print(f"原始数组: {arr_c2}")
print(f"处理后数组: {result_c2}")
代码解析:
- x[:-1]代表数组从第一个元素到倒数第二个元素的所有元素。
- x[1:]代表数组从第二个元素到最后一个元素的所有元素。
- 当对这两个切片进行逐元素乘法x[1:] * x[:-1]时,结果数组中的1表示原始数组中x[i]和x[i+1]都为1。
- (x[1:] * x[:-1]) == 1生成一个布尔掩码,其中True表示x[i]和x[i+1]都是1。
- x[:-1][...] = 0利用这个布尔掩码,将x[:-1]中对应True位置的元素(即每个连续1对中的第一个1)设置为0。
这种方法仅用一行代码就完成了复杂的条件替换,充分展示了NumPy向量化操作的强大和简洁。
总结
通过上述两个示例,我们看到了NumPy在处理数组操作方面的卓越能力。无论是复杂的条件逻辑还是简单的模式匹配,NumPy的向量化操作都能提供比传统Python循环更高效、更简洁的解决方案。掌握这些技巧对于任何需要进行大量数值计算的Python开发者来说都至关重要。在实际应用中,应优先考虑使用NumPy内置函数和向量化操作来优化代码,以获得最佳的性能表现。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
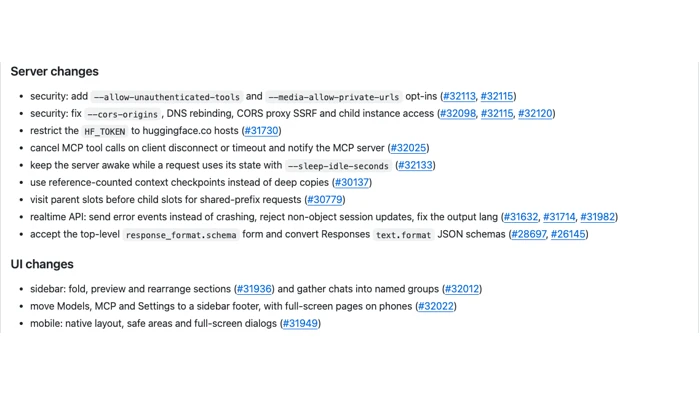
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
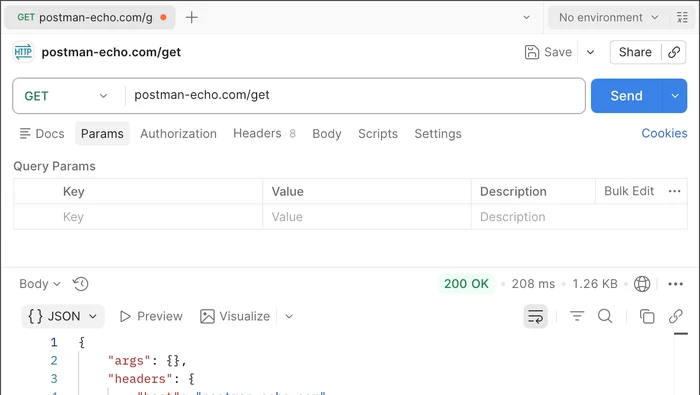
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
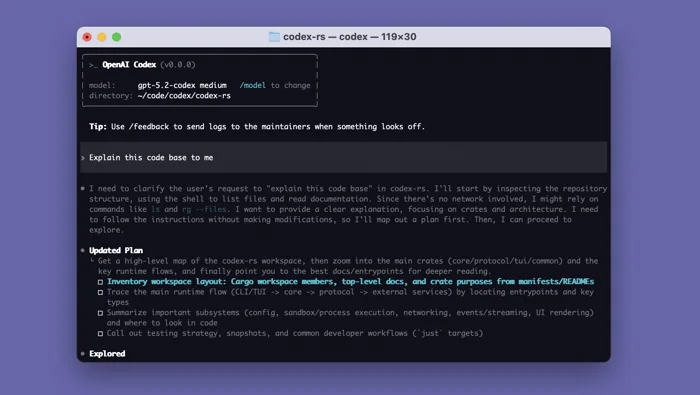
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



