

Python文本摘要方法及NLP实现技巧
文本摘要可通过Python实现,主要方法包括:1.使用现成库如Sumy和PyTextRank进行抽取式摘要;2.结合jieba分词与TextRank算法处理中文文本;3.利用HuggingFaceTransformers实现生成式摘要。Sumy支持多种算法,适合通用场景,PyTextRank更适合英文但也可用于中文预处理后的内容。中文需先分词再构建共现图并计算句子重要性,或使用Gensim的summarize方法。深度学习方法推荐Transformers库中的BART、T5等模型,可理解原文并生成摘要,其
文本摘要可通过Python实现,主要方法包括:1.使用现成库如Sumy和PyTextRank进行抽取式摘要;2.结合jieba分词与TextRank算法处理中文文本;3.利用HuggingFace Transformers实现生成式摘要。Sumy支持多种算法,适合通用场景,PyTextRank更适合英文但也可用于中文预处理后的内容。中文需先分词再构建共现图并计算句子重要性,或使用Gensim的summarize方法。深度学习方法推荐Transformers库中的BART、T5等模型,可理解原文并生成摘要,其中文模型有uer/t5-base-chinese-cluecorpussmall等选择。根据需求选择合适工具,简单任务可用基础算法,高质量摘要则用深度学习模型。
文本摘要其实就是从一段较长的文字中提取出关键信息,用更短的语句表达出来。Python做这个事,靠的是NLP(自然语言处理)技术,常见的方式包括抽取式摘要和生成式摘要两种。下面讲几个实际操作的方法,让你能快速上手。
1. 使用现成库:PyTextRank 或 Sumy
如果你不想从头开始训练模型,直接用现成的库是最省事的办法。像 Sumy 和 PyTextRank 都是基于算法的文本摘要工具,适合大多数通用场景。
- Sumy 支持多种算法,比如 Luhn、Lsa、TextRank 等。
- PyTextRank 是基于 TextRank 的增强版,更适合英文文本,但也可以尝试用于中文预处理后的内容。
安装方法很简单:
pip install sumy pytextrank
使用示例(以 Sumy 为例):
from sumy.parsers.plaintext import PlaintextParser
from sumy.nlp.tokenizers import Tokenizer
from sumy.summarizers.text_rank import Summarizer

parser = PlaintextParser.from_string("你的长文本内容", Tokenizer("english"))
summarizer = Summarizer()
summary = summarizer(parser.document, 3)  # 提取3句话作为摘要
for sentence in summary:
    print(sentence)
注意:如果是中文,需要先进行分词处理,或者换用支持中文的库。
2. 中文文本摘要怎么做?
中文不像英文那样有空格分隔单词,所以处理起来稍微麻烦一点。你可以结合 jieba 分词 和 TextRank 算法 来实现中文摘要。
步骤大致如下:
- 对文本进行分词
- 构建词语之间的共现图
- 利用 PageRank 算法计算每个句子的重要性
- 选出得分最高的几个句子作为摘要
可以自己写代码实现,也可以用 Gensim 库里的 summarize 方法,它默认支持英文,但稍作调整也能处理中文。
示例代码:
from gensim.summarization import summarize
import jieba.analyse

text = "你的中文长文本内容"
# 先用jieba做关键词提取试试看
keywords = jieba.analyse.extract_tags(text, top_n=5)
print("关键词:", keywords)

# 如果要摘要,可以用gensim的summarize函数(需对文本做适当预处理)
summary = summarize(text, word_count=50)  # 控制输出字数
print(summary)
注意:gensim 的 summarize 函数更适合比较规范的文章结构,如果是口语化或乱序文本,效果可能不理想。
3. 深度学习方法:用 HuggingFace Transformers
如果你希望得到更高质量的摘要,尤其是生成式的(不是简单抽取句子),那就要用深度学习模型了。目前最常用的就是 HuggingFace 的 Transformers 库,里面集成了很多预训练模型,比如 BART、T5、Pegasus 等。
这些模型可以做到“理解”原文并用自己的话重新组织摘要内容。
安装方式:
pip install transformers torch
使用示例(英文模型):
from transformers import pipeline

summarizer = pipeline("summarization")
text = "Your long article goes here..."
summary = summarizer(text, max_length=50, min_length=25, do_sample=False)
print(summary[0]['summary_text'])
中文的话,可以选择支持中文的模型,比如:
uer/t5-base-chinese-cluecorpussmallbert4keras/roformer-sim-char-small
加载模型时指定即可:
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

model_name = "uer/t5-base-chinese-cluecorpussmall"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSeq2SeqLM.from_pretrained(model_name)
基本上就这些。根据你的需求选择合适的方法就行。如果只是做个简单的摘要,用 Sumy 或 Gensim 就够了;要是想做高质量生成式摘要,那就上 Transformer 模型。关键是理解不同方法的适用场景,别一上来就跑模型,有时候简单的算法就够用了。
本文早在揭开语言模型的神秘面纱,阐明其处理原始文本数据的基本概念和机制。它涵盖了几种类型的语言模型和大型语言模型,重点关注基于神经网络的模型。语言模型定义语言模型专注于生成类似人类类的文本的能力。通用语言模型本质上是单词序列的统计模型或概率分布,用于解释单词在每个序列中出现的可能性。这有助于根据句子中的前一个单词预测下一个单词或单词。简化的概率语言模型可用于机器翻译、自动纠错、语音识别和自动完成等各种应用,为用户填写以下单词或建议可能的单词序列。该类型模型已经发展成为更先进的模型,包括变换器模型,通过考虑
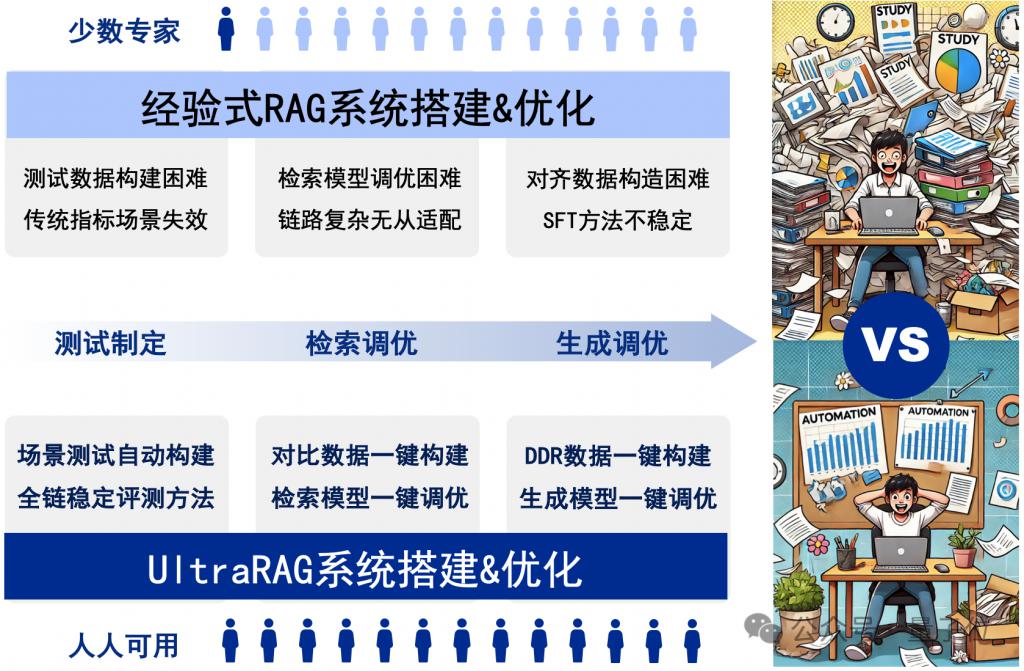
清华大学THUNLP团队联合多家机构推出UltraRAG框架,简化RAG系统搭建流程。传统RAG系统搭建复杂,UltraRAG框架提供“单反相机”级精细化配置和“卡片机”级一键式操作,显著降低学习成本和开发周期。UltraRAG框架的核心优势在于其对模型与知识库的适配,避免了反复的模型选型。其模块化设计也方便科研人员快速迭代。用户可轻松完成数据到模型的全流程管理。零代码WebUI,一键式数据构建UltraRAG的零代码WebUI是其一大亮点,即使没有编程经验的用户也能轻松构建、训练和评估模型。框架
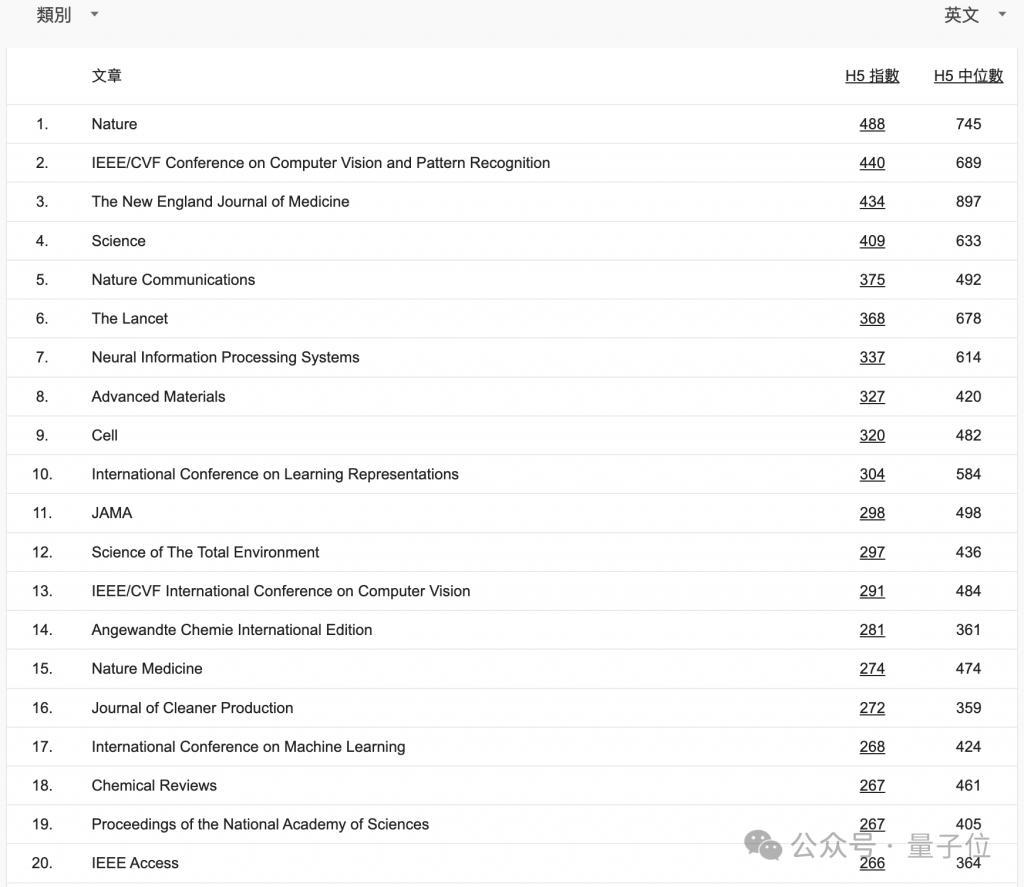
2024谷歌学术指标(GoogleScholarMetrics)出炉,AI顶会掀起狂欢——CVPR成为第二大学术出版物,超越Science,仅次于Nature。除此之外,NeurIPS排名第7;ICLR第10、ICCV第13、ICML第17…前20名中,四分之一被AI会议占据。网友纷纷表示今年这榜单有点"crazy":各领域学者教授也纷纷表示惊讶:CVPR成为第二大出版物谷歌学术指标评价体系主要基于h5指数(h5-index),h5指数指的过去整5年,即2019-2023年"发表的h篇文章中,每篇至少都被

Python是一种流行的编程语言,也是自然语言处理(NLP)中广泛使用的工具之一。NLP是计算机科学和人工智能的交叉领域,旨在使计算机系统能够理解、解释和生成人类语言。Python中的NLP主要涉及以下几个方面:1.文本处理文本处理是NLP的基础,这包括读取、分词、清理和转换文本数据。Python提供了许多工具和库来处理文本数据,例如字符串操作、正则表达式、
如何利用PythonforNLP将PDF文本转换为可分析的数据?引言:自然语言处理(NaturalLanguageProcessing,NLP)是人工智能领域中的一个重要分支,它致力于研究和开发使计算机能够理解、处理、生成自然语言的方法和技术。在NLP的应用中,将PDF文本转换为可分析的数据是一个常见的任务。本文将介绍如何利用Python及其相关库
如何使用PythonforNLP处理包含多个段落的PDF文本?摘要:自然语言处理(NLP)是一门专门处理和分析人类语言的领域。Python是一种功能强大的编程语言,广泛用于数据处理和分析。本文将介绍如何使用Python和一些流行的库来处理包含多个段落的PDF文本,以便进行自然语言处理。导入库:首先,我们需要导入一些库来帮助我们处理PDF文件和进行自然语言
如何用PythonforNLP提取文本PDF文件中的元数据?随着大数据时代的到来,信息的处理变得越来越重要。在自然语言处理(NLP)中,提取文本数据中的元数据是一个关键的任务。本文将介绍如何使用PythonforNLP技术提取PDF文件中的元数据,并提供具体的代码示例。Python是一种流行的编程语言,具有简洁、易读和强大的特点。Python有许多强
如何使用PythonforNLP处理含有缩写词的PDF文件在自然语言处理(NLP)中,处理包含缩写词的PDF文件是一个常见的挑战。缩写词在文本中经常出现,而且很容易给文本的理解和分析带来困难。本文将介绍如何使用Python进行NLP处理,解决这个问题,并附上具体的代码示例。安装所需的Python库首先,我们需要安装一些常用的Python库,包括PyPDF
PythonforNLP:如何自动整理和分类PDF文件中的文本?摘要:随着互联网的发展和信息的爆炸式增长,我们每天面临大量的文本数据。在这个时代中,自动整理和分类文本变得越来越重要。本文将介绍如何使用Python和其强大的自然语言处理(NLP)功能,自动从PDF文件中提取文本,并进行整理和分类。1.安装必要的Python库在开始之前,我们需要确保已经安装
PythonforNLP:如何处理包含嵌入式图像的PDF文本?摘要:本文将介绍如何使用Python处理包含嵌入式图像的PDF文本。我们将使用PyPDF2库来解析PDF文档,然后使用PythonImagingLibrary(PIL)来处理嵌入式图像。引言:在自然语言处理(NLP)中,处理包含嵌入式图像的PDF文本是一项常见的任务。这样的文本通常是从扫描





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



