

Python批量处理隐藏进度提示方法
答案:通过重定向sys.stdout、配置logging模块及使用库的静默参数可有效屏蔽Python批量处理中的冗余输出。具体包括利用contextmanager或redirect_stdout临时抑制标准输出,设置logging级别过滤日志信息,优先使用第三方库如tqdm、scikit-learn的disable或verbose参数控制进度提示,避免I/O开销、提升脚本效率与输出可读性,同时注意stderr未被屏蔽、调试信息丢失及多线程环境下的潜在问题。
答案:通过重定向sys.stdout、配置logging模块及使用库的静默参数可有效屏蔽Python批量处理中的冗余输出。具体包括利用contextmanager或redirect_stdout临时抑制标准输出,设置logging级别过滤日志信息,优先使用第三方库如tqdm、scikit-learn的disable或verbose参数控制进度提示,避免I/O开销、提升脚本效率与输出可读性,同时注意stderr未被屏蔽、调试信息丢失及多线程环境下的潜在问题。
在Python进行批量处理时,隐藏那些恼人的进度提示或冗余输出,通常涉及对标准输出流(sys.stdout)的重定向、调整第三方库的日志级别,或者利用库自身提供的静默模式参数。这不仅仅是为了让控制台看起来更清爽,更是为了提高脚本的运行效率,确保自动化流程的输出可读性和可解析性。
解决方案
要有效地屏蔽Python在批量处理时的输出信息和进度提示,可以从以下几个层面入手:
重定向
sys.stdout到空设备或文件: 这是最直接也最通用的方法,适用于任何写入到标准输出的内容,包括print()函数、某些C扩展库的直接输出等。import sys import os from contextlib import contextmanager @contextmanager def suppress_stdout(): """一个上下文管理器,用于临时屏蔽标准输出""" with open(os.devnull, 'w') as devnull: old_stdout = sys.stdout sys.stdout = devnull try: yield finally: sys.stdout = old_stdout # 示例用法: # with suppress_stdout(): # print("这段话不会显示在控制台") # # 这里可以调用你的批量处理函数,其中可能包含大量print或进度条 # print("这段话会正常显示")配置
logging模块: 如果你的程序或依赖库使用Python的logging模块进行输出,你可以通过调整日志级别来控制显示。import logging # 将根日志器的级别设置为CRITICAL,这样只有非常严重的错误才会显示 # logging.basicConfig(level=logging.CRITICAL) # 或者针对特定库的日志器进行设置 # logging.getLogger('some_noisy_library').setLevel(logging.WARNING) # 示例: # logger = logging.getLogger(__name__) # logger.warning("这是一个警告,如果日志级别高于WARNING则不会显示")利用第三方库的静默模式或
verbose参数: 许多流行的库,特别是那些涉及机器学习、数据处理或进度显示的库,都提供了内置的参数来控制输出。tqdm(进度条库):from tqdm import tqdm # for i in tqdm(range(100), disable=True): # disable=True 彻底关闭进度条 # pass
scikit-learn(机器学习库): 许多模型和工具函数都有verbose参数。from sklearn.linear_model import LogisticRegression # model = LogisticRegression(verbose=0) # 设置为0通常表示静默
pandas(数据处理库): 尽管不直接是进度条,但有时其显示选项会影响输出量。import pandas as pd # pd.set_option('display.max_rows', None) # 控制最大显示行数
为什么在批量处理中隐藏进度提示至关重要?
在我看来,隐藏进度提示在批量处理中并非可有可无,它几乎是效率和整洁度的代名词。想象一下,你正在处理一个包含数万个文件的任务,每个文件处理完毕都会在控制台打印一行“文件X处理完成”。这在测试几个文件时或许有用,但当数量级上升时,控制台会瞬间被海量的文本淹没。
首先,性能开销是不可忽视的。每一次I/O操作(包括向控制台写入)都会消耗CPU周期和内存带宽。虽然单次打印微不足道,但在高频次、大规模的批量处理中,这些累积的开销可能会显著拖慢整体执行速度。我曾经遇到过一个脚本,仅仅因为打印了过多的调试信息,导致运行时间翻倍。
其次,输出的可读性会急剧下降。当屏幕上充斥着密密麻麻的进度信息时,你很难从中迅速定位到真正的错误信息、关键结果或者你真正关心的摘要。这对于调试和后期分析来说,简直是一场灾难。你想要的是一份清晰的报告,而不是一堆“噪音”。
再者,对于自动化流程和集成而言,干净的输出至关重要。如果你的Python脚本是更大自动化工作流的一部分,其输出可能会被其他程序解析。冗余的进度提示会干扰解析器,导致流程中断或数据错误。一个干净、结构化的输出,是自动化协作的基石。
最后,从个人体验来说,那种看着屏幕被无尽的滚动信息刷屏的感觉,真的会让人产生一种“失控”的焦虑感。我更倾向于在任务完成后,得到一个简洁的“任务完成,耗时X秒,成功Y个,失败Z个”的总结,而不是在过程中被无数细节轰炸。
sys.stdout 重定向的实战技巧与潜在陷阱
sys.stdout 重定向是Python中一个非常强大且灵活的技巧,它能让你完全掌控程序的标准输出流。最常见的实战场景就是将输出导向 /dev/null(Linux/macOS)或 NUL(Windows)来实现静默,或者导向一个文件进行日志记录。
实战技巧:
使用
contextlib.redirect_stdout: 这是Python 3.4+ 推荐的现代方式,它提供了一个简洁的上下文管理器。import sys import os from contextlib import redirect_stdout def noisy_function(): print("我是一个吵闹的函数!") sys.stderr.write("但错误信息依然会显示!\n") # 注意stderr for i in range(3): print(f"进度:{i+1}/3") print("--- 开始静默执行 ---") with open(os.devnull, 'w') as f: with redirect_stdout(f): noisy_function() print("--- 静默执行结束 ---")这种方式的优点是代码清晰,且能确保在上下文退出时
sys.stdout会被正确恢复,避免了手动保存和恢复的麻烦。自定义上下文管理器: 如果你需要更复杂的逻辑,比如在特定条件下才静默,或者需要处理
stderr,可以自己编写。import sys import os class SuppressOutput: def __enter__(self): self._original_stdout = sys.stdout self._original_stderr = sys.stderr # 也可以选择屏蔽stderr sys.stdout = open(os.devnull, 'w') sys.stderr = open(os.devnull, 'w') # 屏蔽stderr def __exit__(self, exc_type, exc_val, exc_tb): sys.stdout.close() sys.stderr.close() # 关闭文件 sys.stdout = self._original_stdout sys.stderr = self._original_stderr # 恢复 # 如果需要,可以在这里处理异常 return False # 不抑制异常 # with SuppressOutput(): # print("这段话不会显示") # raise ValueError("这个错误也不会显示,因为stderr也被屏蔽了")这种方式提供了最大的灵活性,但需要注意文件句柄的关闭和异常处理。
潜在陷阱:
sys.stderr未受影响: 这是最常见的陷阱。sys.stdout只处理标准输出,而错误信息通常会写入sys.stderr。这意味着即使你屏蔽了stdout,程序的错误或警告(例如某些库的内部错误日志)仍然会显示出来。如果你想屏蔽所有输出,你需要同时重定向sys.stderr。- 隐藏了有用的调试信息: 有时候,那些看似冗余的输出实际上包含了重要的调试线索。在开发或调试阶段,过度屏蔽输出可能会让你对程序内部发生了什么一无所知,导致排查问题变得异常困难。我通常会在开发时保持输出,只在部署或进行大规模测试时才启用静默模式。
- 多线程/多进程环境: 在多线程或多进程环境中直接修改
sys.stdout可能会变得复杂,并引发竞争条件。每个线程或进程都有自己的sys.stdout副本,或者在某些情况下,它们可能共享同一个文件描述符。在这种情况下,你需要更细致的控制,例如为每个子进程单独重定向,或者使用进程间通信来收集日志。 - 文件句柄泄露: 如果你手动打开文件(例如
open(os.devnull, 'w'))但忘记在finally块或__exit__方法中关闭它,可能会导致文件句柄泄露,尤其是在循环中频繁重定向时。使用with open(...)语句或contextlib.redirect_stdout可以自动处理这个问题。 - 并非所有输出都走
sys.stdout: 有些底层C扩展库可能直接写入终端设备,绕过了Python的sys.stdout机制。这种情况下,重定向sys.stdout是无效的,你可能需要更底层的操作系统级别工具(如subprocess的stdout=subprocess.DEVNULL)来运行外部命令。
如何优雅地控制第三方库的冗余输出?
控制第三方库的冗余输出,往往比重定向 sys.stdout 更“优雅”,因为它通常能让你在保持程序核心功能不变的前提下,精细地管理信息流。这主要依赖于库自身的设计,尤其是它们对Python logging 模块的集成,以及提供的特定参数。
利用库的
verbose或silent参数: 这是最直接也是最推荐的方式。许多设计良好的库会提供一个verbose参数(通常是布尔值或整数,0表示静默,越大越详细)或者silent参数来控制其内部的打印行为。tqdm: 如果你用tqdm来显示进度条,直接在tqdm构造函数中设置disable=True就能彻底关闭它。这比重定向sys.stdout要轻量且针对性强。from tqdm import tqdm # for i in tqdm(range(1000), desc="处理中", disable=True): # # 你的批量处理逻辑 # pass
scikit-learn: 大多数scikit-learn的模型和工具都有verbose参数,设置为0通常意味着不输出任何训练过程信息。from sklearn.ensemble import RandomForestClassifier # model = RandomForestClassifier(n_estimators=100, verbose=0) # model.fit(X_train, y_train)
- 其他库: 在使用任何新库时,查看其文档中是否有关于
verbose、quiet、silent或log_level等参数的说明,通常能找到答案。
配置
logging模块: 如果第三方库内部使用Python的logging模块来输出信息,那么你可以通过配置日志器来控制它们的输出。这是更高级也更强大的方法。设置特定库的日志级别: 你可以获取某个库的日志器实例,然后单独设置它的日志级别,而不影响其他部分的日志。
import logging
# 假设某个库的日志器名为 'my_noisy_library'
# logging.getLogger('my_noisy_library').setLevel(logging.WARNING)
# logging.getLogger('another_library').setLevel(logging.CRITICAL)

# 示例:通常库会定义自己的logger
# import some_library_that_logs
# some_library_that_logs.logger.setLevel(logging.ERROR) # 假设它暴露了logger
全局设置日志级别: 如果你希望所有日志输出都保持在某个级别之上,可以配置根日志器。但这可能会屏蔽掉你程序中其他部分有用的信息。
# logging.basicConfig(level=logging.INFO) # 默认级别
# logging.basicConfig(level=logging.CRITICAL) # 屏蔽除CRITICAL外的所有信息
理解
DEBUG,INFO,WARNING,ERROR,CRITICAL这些日志级别很重要。设置为CRITICAL会屏蔽掉几乎所有非致命的输出。
处理无法控制的输出: 如果一个库既没有
verbose参数,也没有使用logging模块,或者其输出是直接写入sys.stdout或sys.stderr的底层C代码,那么你可能不得不回到sys.stdout或sys.stderr重定向的方案。这通常是最后的手段,因为它的影响范围更广。
在实践中,我通常会优先尝试库自身的参数。如果不行,我会检查它是否使用了 logging 模块,并尝试配置日志级别。只有当这些方法都无效时,我才会考虑全局的 sys.stdout 重定向。这样做的目的,是为了在控制输出的同时,最大限度地保持代码的清晰度和可维护性,并且避免不小心屏蔽掉关键的错误或调试信息。毕竟,我们想屏蔽的是噪音,而不是警报。

深入解析在FastAPI框架中实现文件下载接口的完整方案,涵盖基于FileResponse的本地静态文件传输、基于StreamingResponse的分块流式传输、RFC 5987中文文件名编码规范、路径穿越安全防御及BackgroundTasks临时文件清理,并配备详细代码示例与架构解析图。
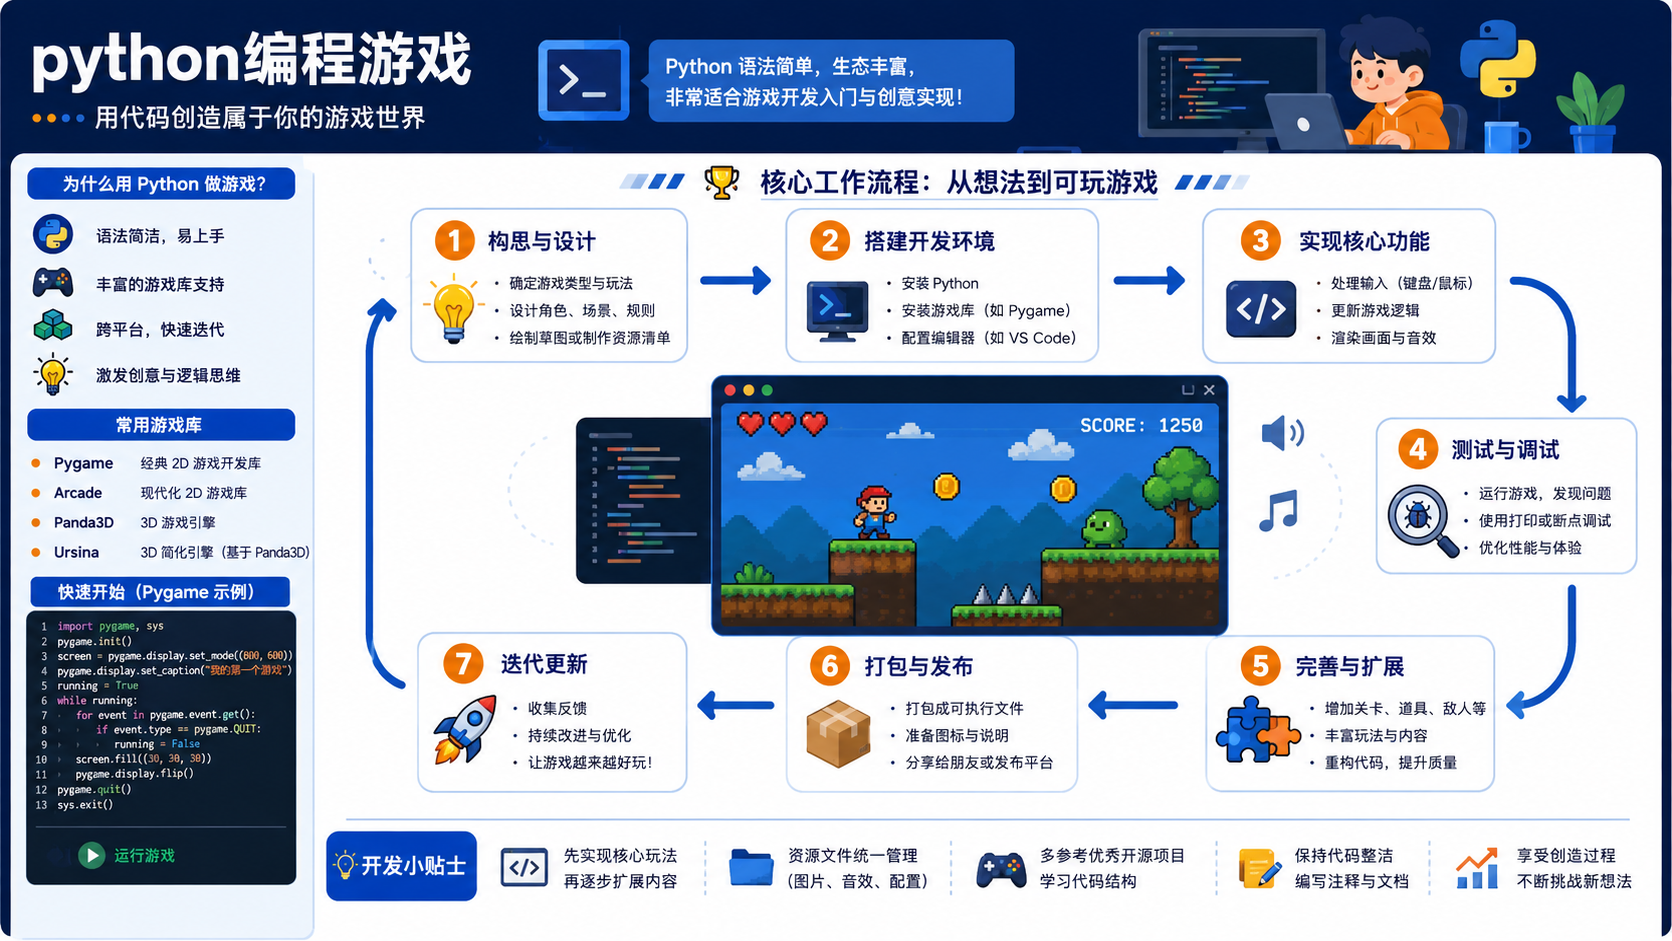
解析 python编程游戏 的核心开发流程,提供基于官方文档的环境准备、依赖安装命令及验证方法,包含清晰的决策图与排错路径,适用于具备基础命令行能力的后端开发者。
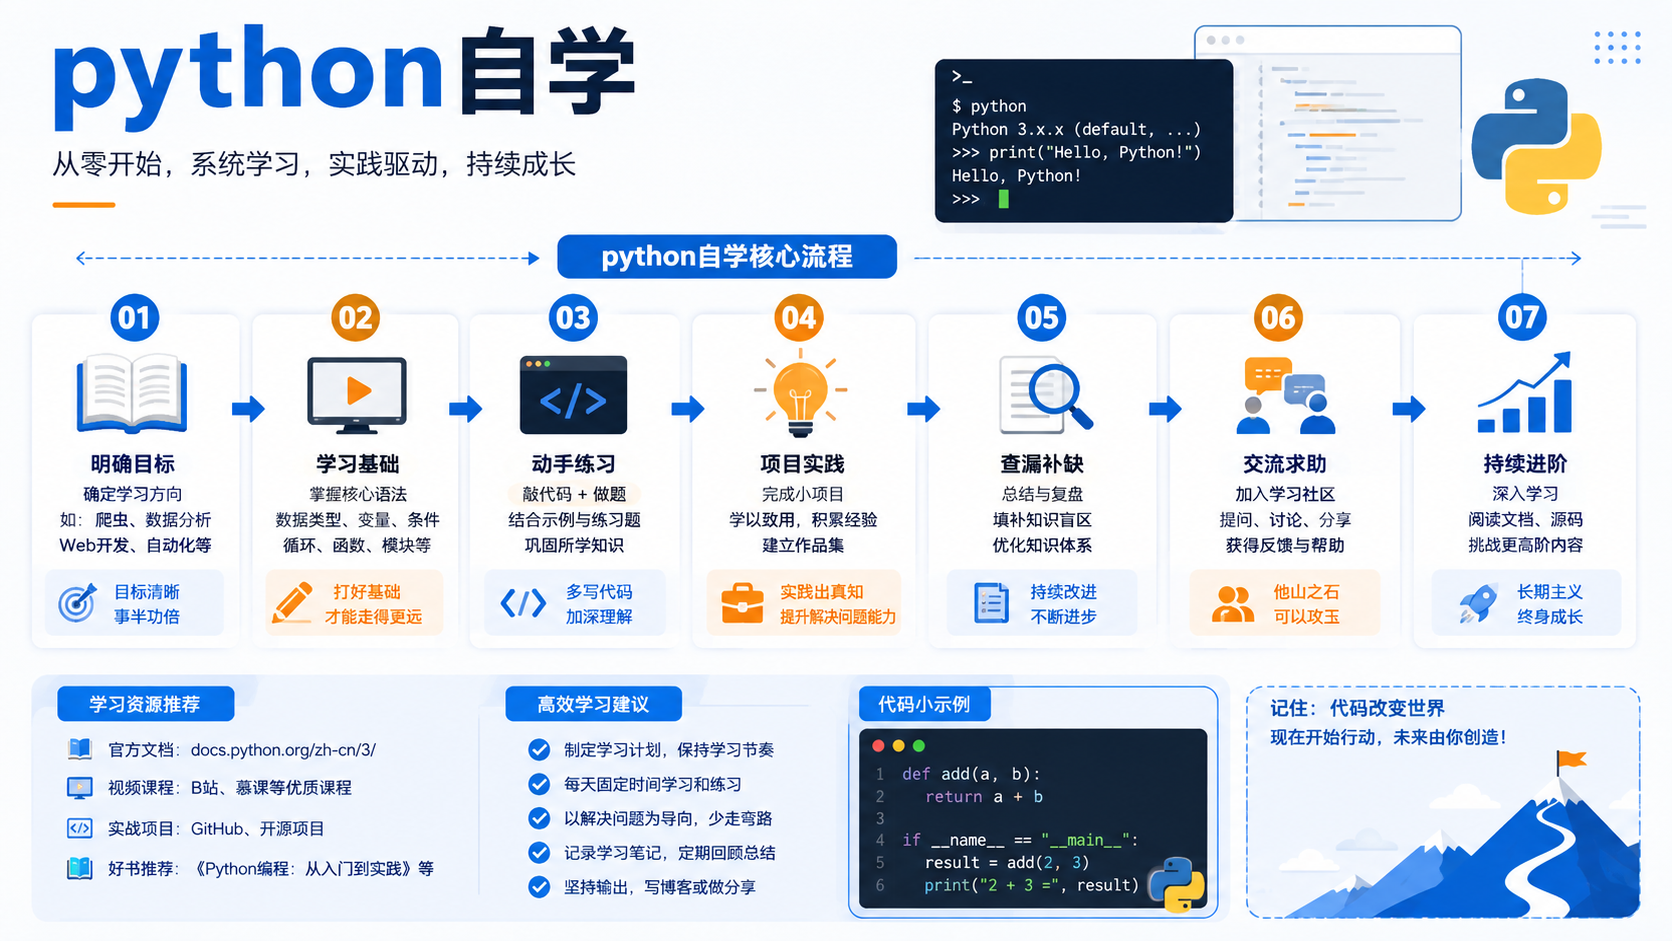
面向后端开发者的 python自学实操指南。涵盖 Python 官方概念界定、虚拟环境创建、依赖安装验证及常见排错路径,提供可执行的 Bash 命令与决策流程图。
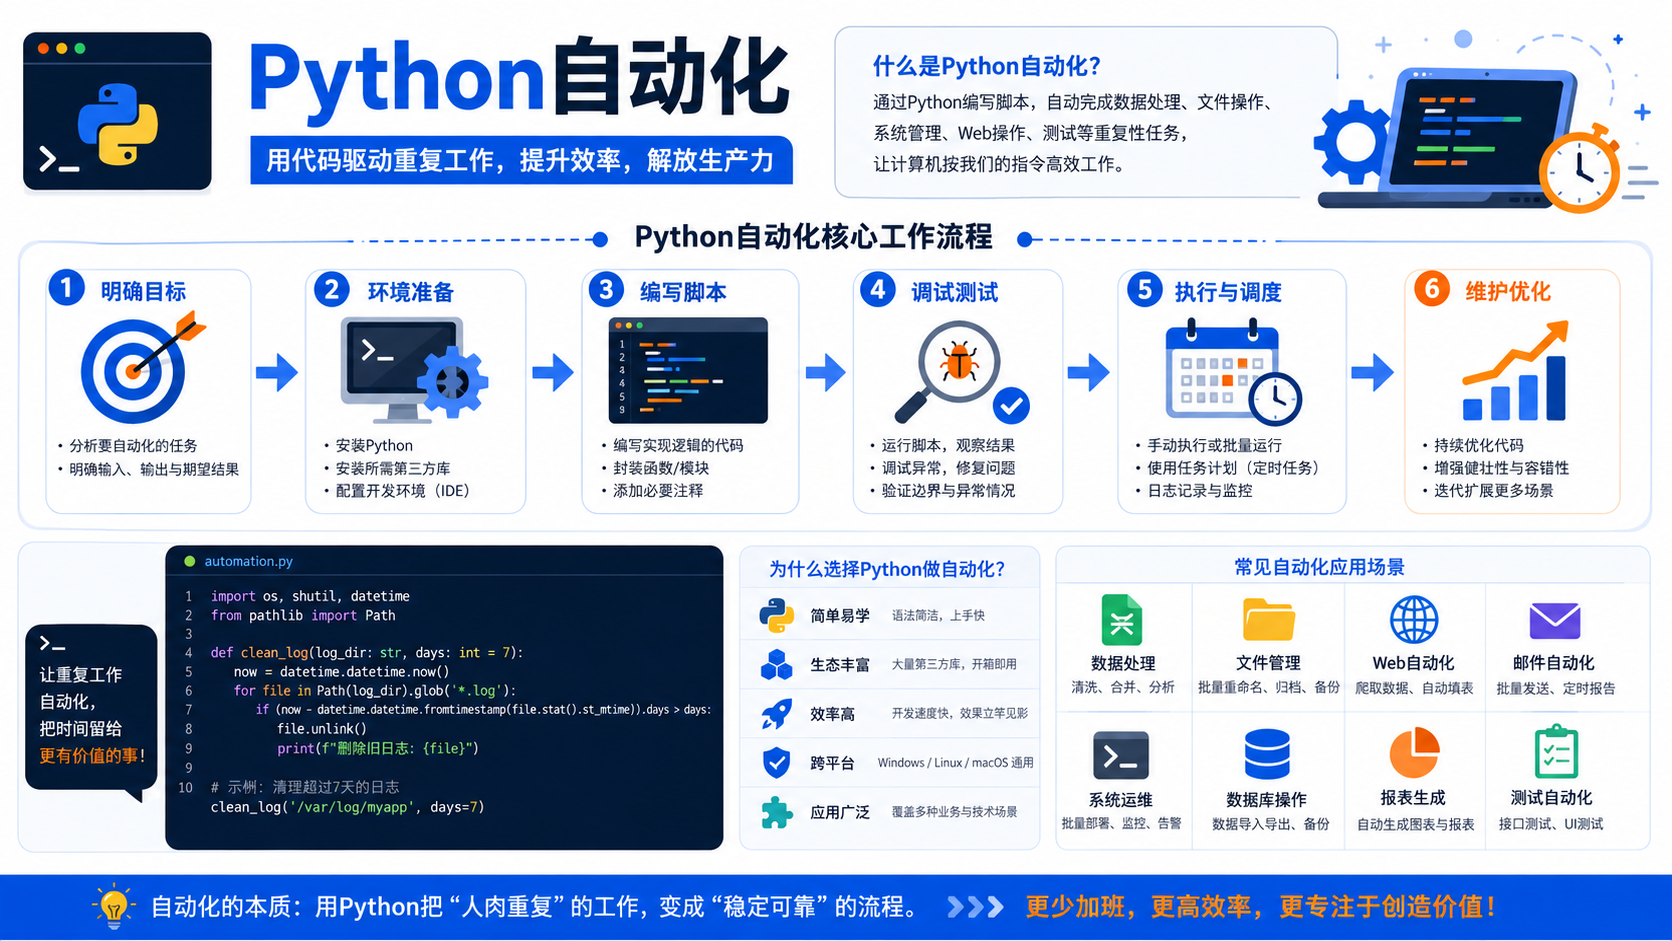
针对后端开发者的 python自动化 入门指南,涵盖 venv 虚拟环境创建、pip 依赖管理及官方文档依据的验证步骤,提供清晰的决策图与排错建议。
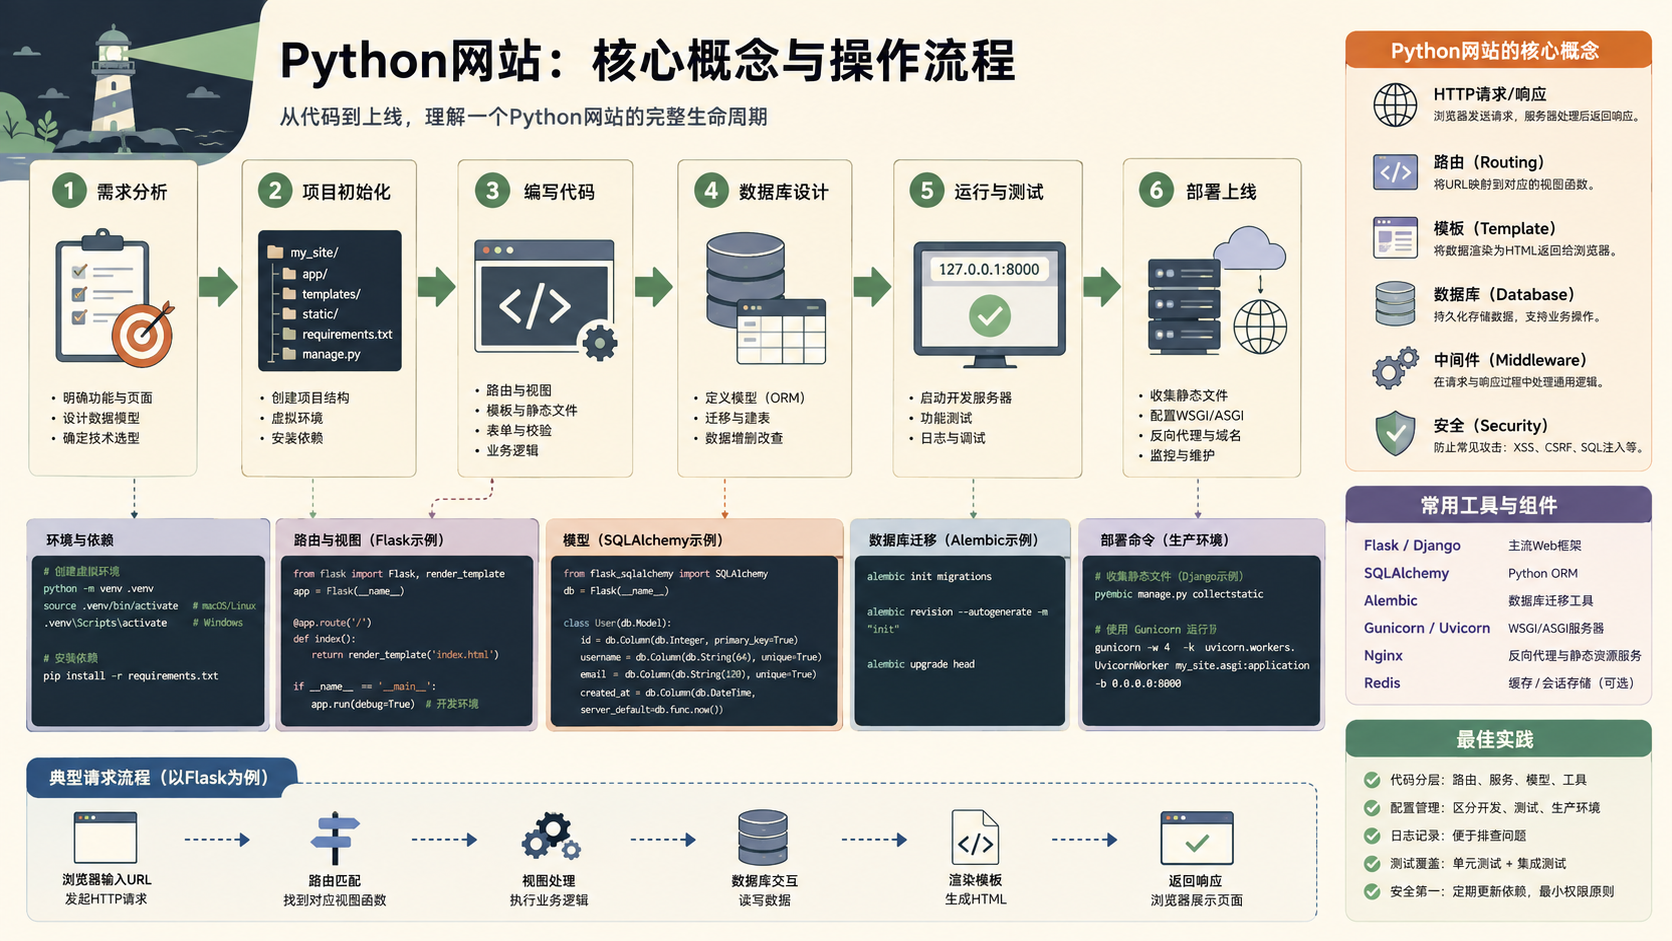
面向后端开发者的 python文档 实操指南。涵盖环境检查、venv创建、pip升级及依赖验证,提供清晰的决策图与命令示例,避免常见配置错误。
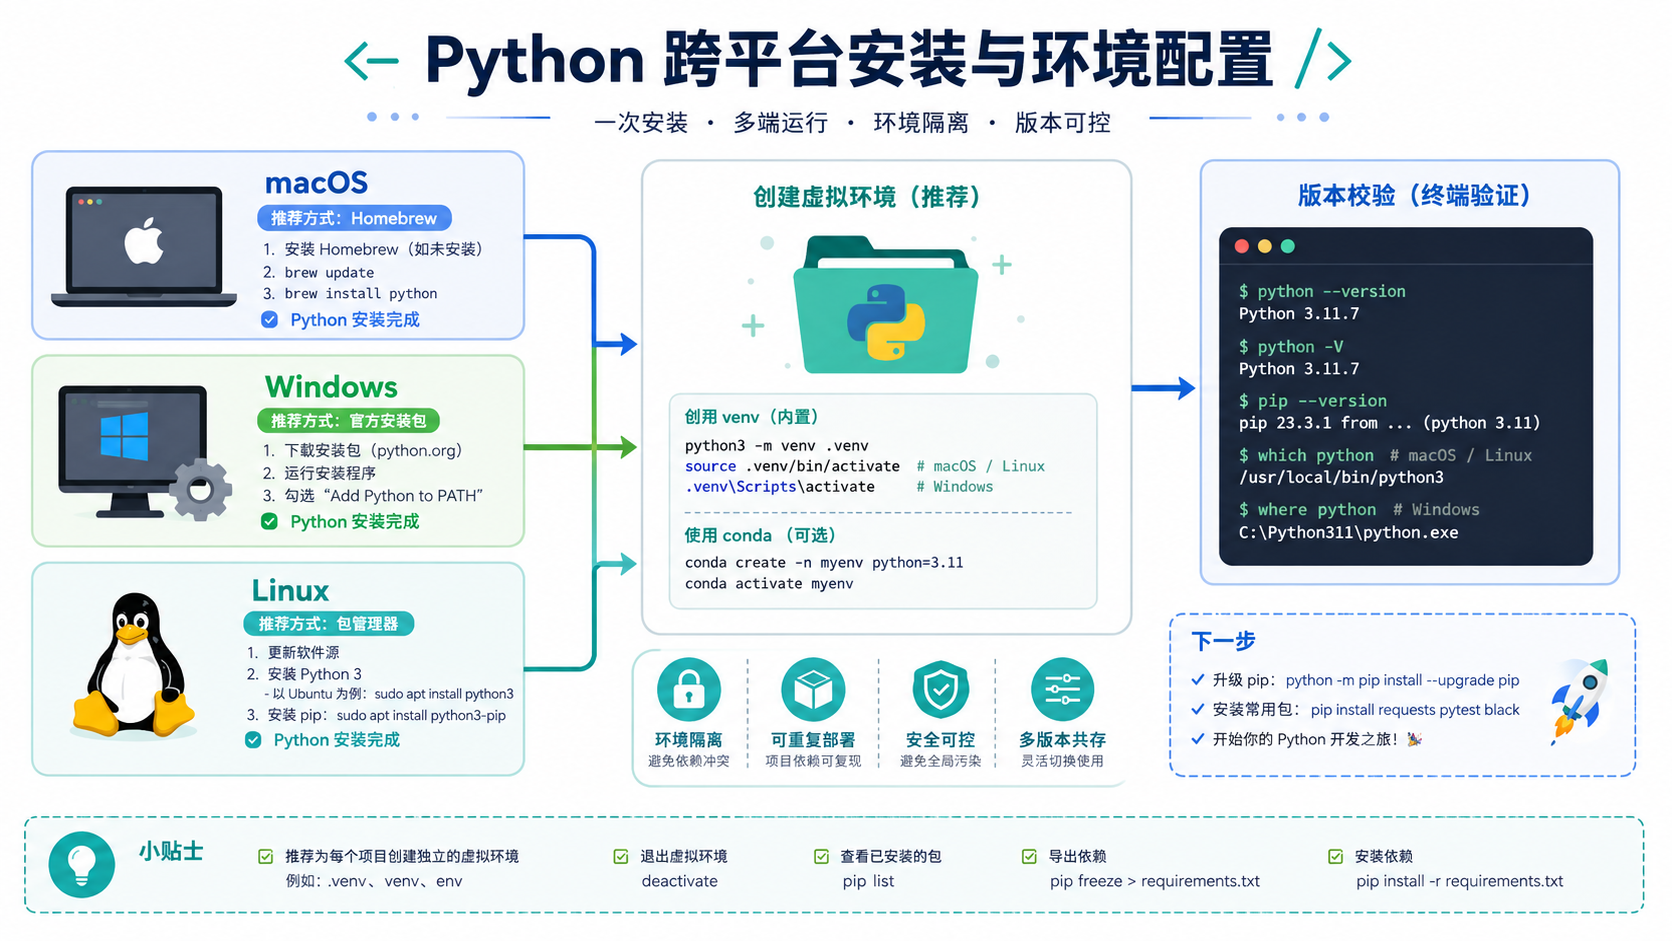
面向后端开发者的 python循环 实操指南。涵盖环境检查、虚拟环境创建、依赖安装及验证步骤,结合官方文档与决策图,确保操作可复现且边界清晰。
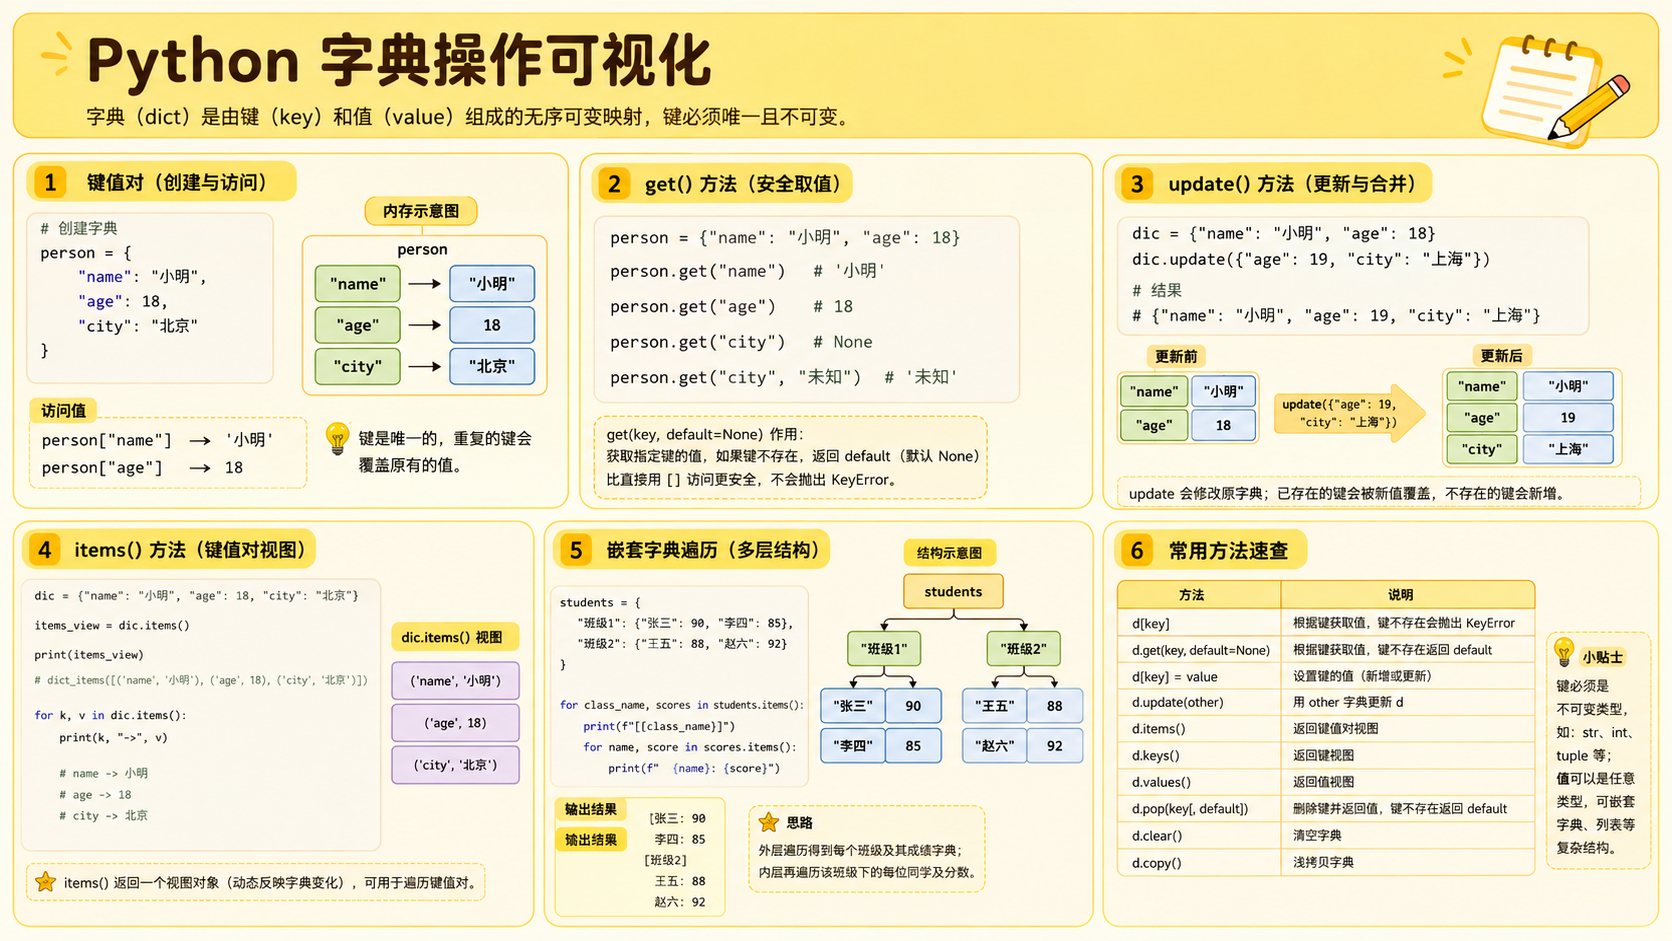
详解 Python 字典的键值访问、遍历与嵌套结构,并提供基于官方文档的 Python 环境搭建、虚拟环境隔离及依赖管理步骤,帮助开发者建立可复现的开发工作流。
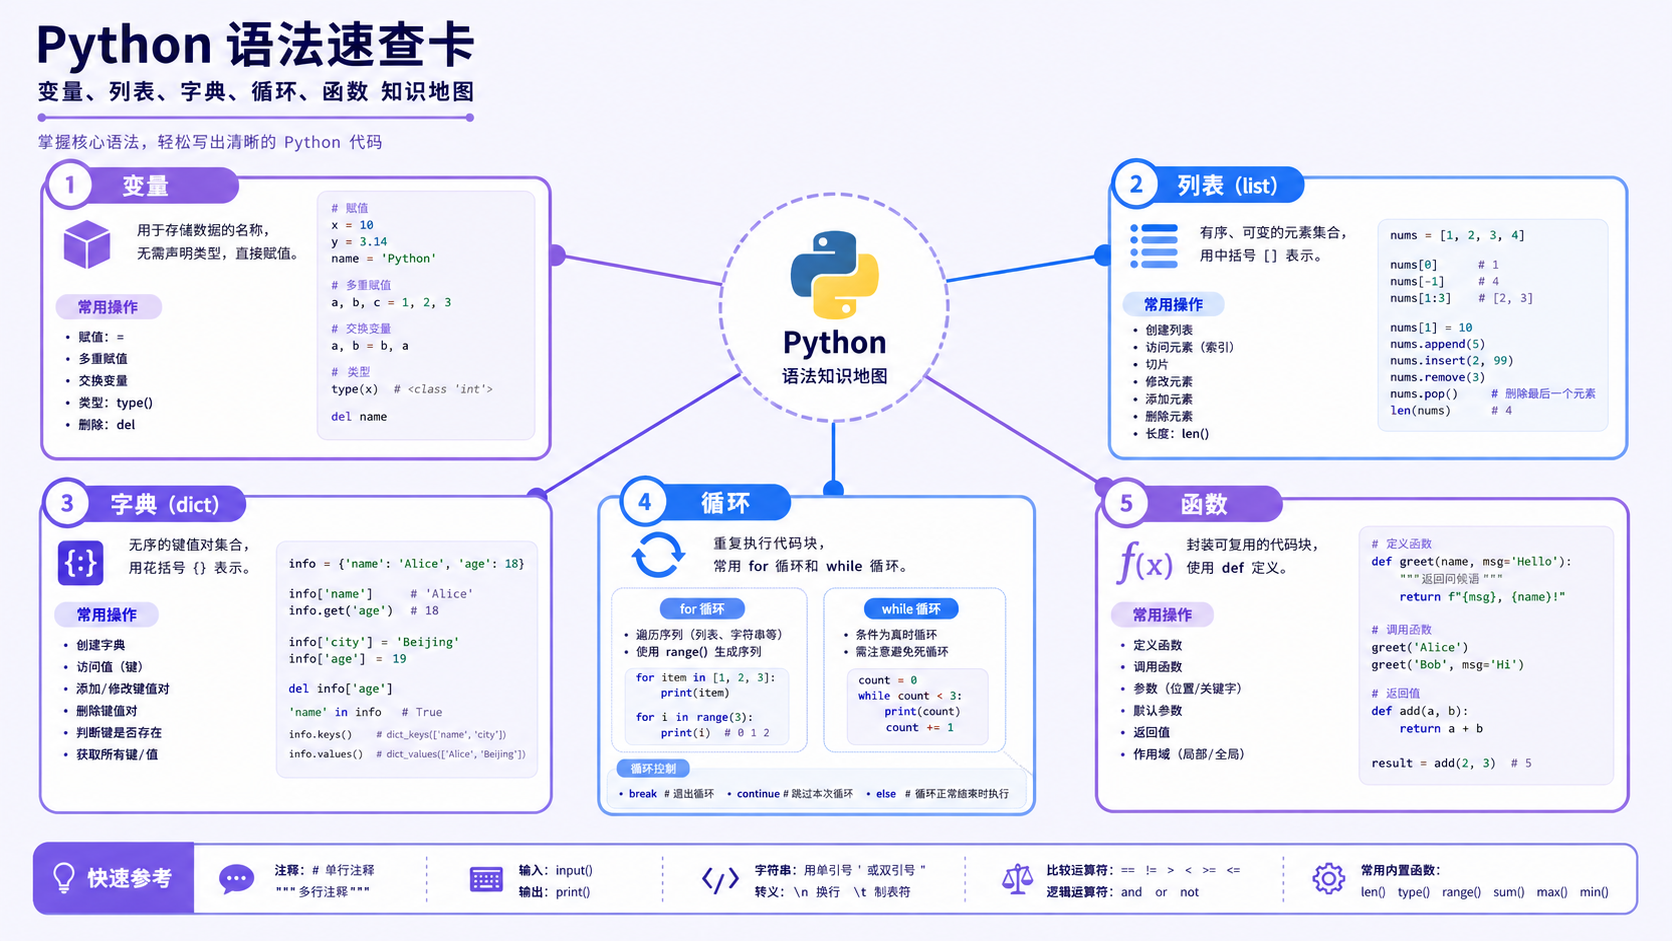
针对后端开发者,详解 Python 编程基础的环境搭建、依赖隔离与验证方法。基于官方文档提供可复现命令,明确工具边界,帮助读者建立最小可测试代码闭环。
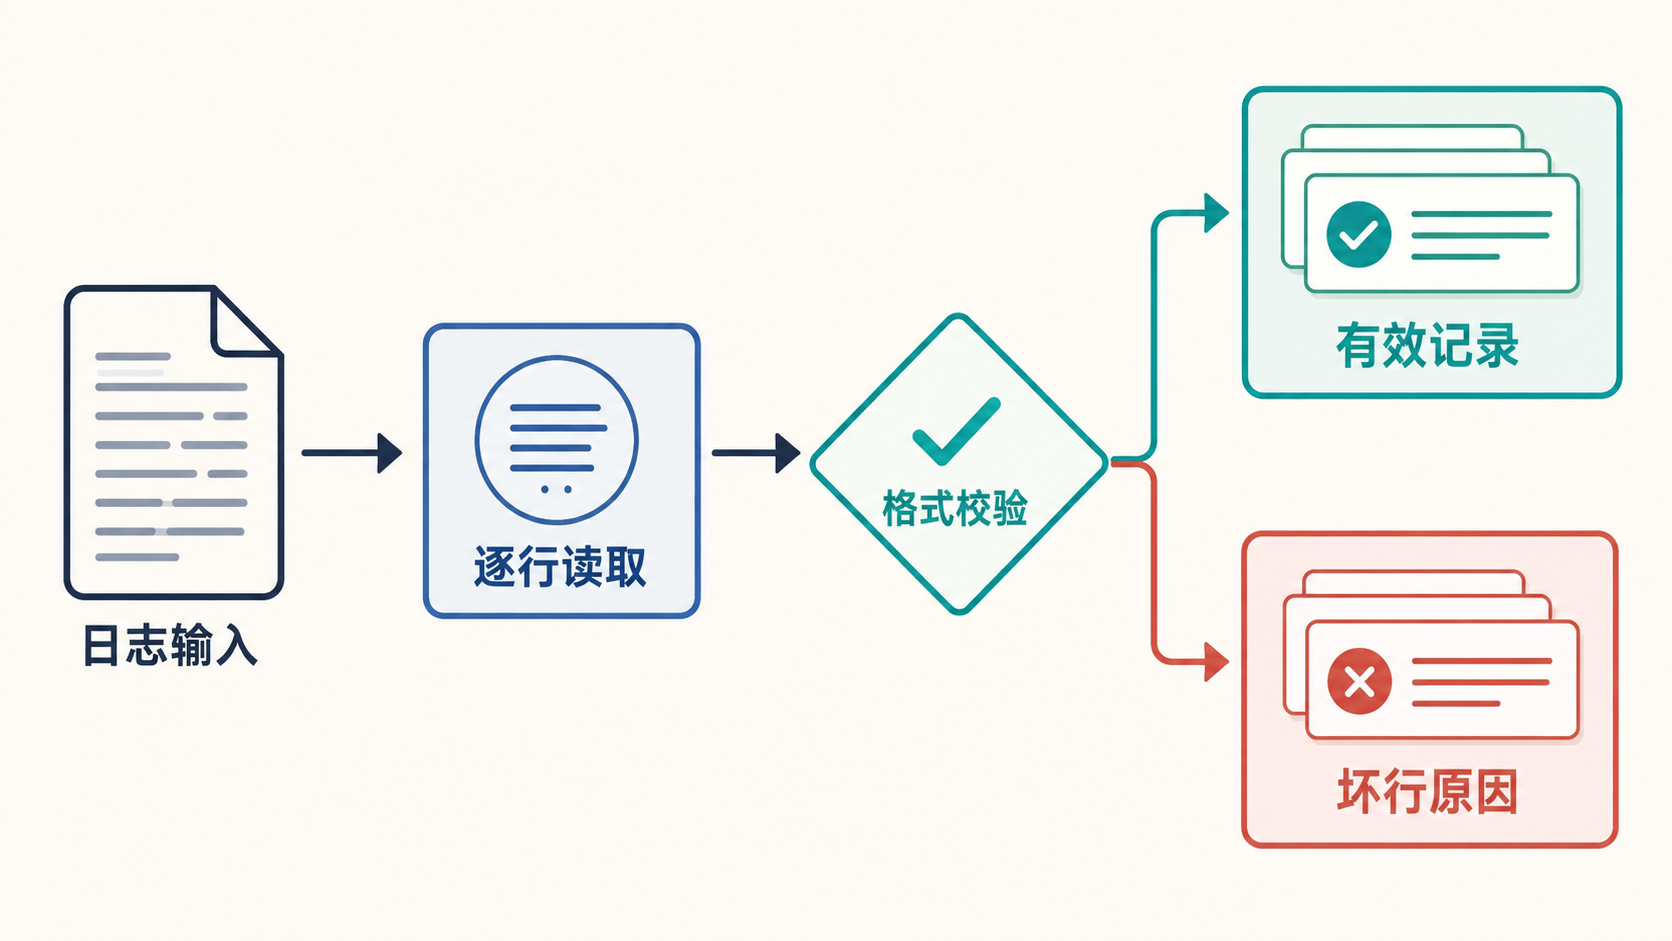
这篇 Python 教程通过一个真实可运行的日志清洗工具,讲解自定义异常、异常链、生成器、Counter、严格模式和退出状态。
选择服务器类型对Python项目部署的影响在于性能、可伸缩性、维护成本和部署复杂性。1.VPS适合中小型项目,成本可控且环境可控,但需自行维护;2.云平台集成丰富服务,适合用户增长后的复杂架构,但学习成本高;3.PaaS部署简便,适合快速原型开发,但控制权受限;4.容器化适合大型项目,提供部署一致性和扩展性,但学习成本高。配置Nginx与Gunicorn实现稳定运行需:1.Gunicorn绑定Unixsocket并设置合理worker数;2.Nginx配置反向代理指向socket、处理静态文件和SSL;3





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



