

如何使用Go语言和Redis开发分布式爬虫
Redis Assistant 是一款为Redis设计的高效可视化管理与监控工具,提供多种操作模式,高效处理服务器数据。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。
如何使用Go语言和Redis开发分布式爬虫引言:随着互联网技术的快速发展,网络爬虫在数据挖掘、搜索引擎优化、信息采集等领域的应用越来越广泛。其中,分布式爬虫能够充分利用集群资源,提高爬取效率和稳定性。本文将介绍如何使用Go语言和Redis开发一个简单的分布式爬虫,旨在帮助读者更好地理解和应用相关技术。一、准备工作在开始本文的实例之前,我们需要完成以下准备工作
如何使用Go语言和Redis开发分布式爬虫
引言:
随着互联网技术的快速发展,网络爬虫在数据挖掘、搜索引擎优化、信息采集等领域的应用越来越广泛。其中,分布式爬虫能够充分利用集群资源,提高爬取效率和稳定性。本文将介绍如何使用Go语言和Redis开发一个简单的分布式爬虫,旨在帮助读者更好地理解和应用相关技术。
一、准备工作
在开始本文的实例之前,我们需要完成以下准备工作:
- 安装Go语言开发环境:请确保您的电脑已经正确安装了Go语言的开发环境,并且配置了相应的环境变量。
- 安装Redis:Redis是一个开源的内存数据库,可以用来存储爬虫程序的任务队列和结果等信息。请根据自己的操作系统类型和版本安装Redis,并启动Redis服务。
二、项目结构和代码示例
我们将使用Go语言编写一个简单的分布式爬虫程序,以下是项目的基本目录结构:
crawler
- main.go
- worker.go
- conn.go
- main.go
创建一个名为 main.go 的文件,并编写以下代码:
package main

import (
    "fmt"
    "net/http"
    "strconv"
)

func main() {
    // 创建一个任务队列,用来存储待爬取的URL
    taskQueue := make(chan string)
    go func() {
        // 将待爬取的URL加入到任务队列中
        for i := 1; i <= 10; i++ {
            url := "http://example.com/page" + strconv.Itoa(i)
            taskQueue <- url
        }
        close(taskQueue)
    }()

    // 创建一定数量的爬虫协程,并从任务队列中获取URL进行爬取
    for i := 0; i < 5; i++ {
        go func() {
            for url := range taskQueue {
                resp, err := http.Get(url)
                if err != nil {
                    fmt.Println("Failed to crawl", url)
                } else {
                    fmt.Println("Crawled", url)
                    // TODO: 解析和处理网页内容
                }
            }
        }()
    }

    // 阻塞主进程
    select {}
}
在 main.go 中,我们创建了一个任务队列 taskQueue,并在一个单独的 goroutine 中向其中加入待爬取的URL。然后,我们创建了若干个爬虫协程(这里为5个),通过从任务队列中获取URL进行爬取。
- worker.go
接下来,我们创建一个名为 worker.go 的文件,并编写以下代码:
package main

import (
    "fmt"
    "github.com/go-redis/redis"
)

func main() {
    // 连接Redis数据库
    client := redis.NewClient(&redis.Options{
        Addr:     "localhost:6379",
        Password: "",
        DB:       0,
    })

    // 创建一个爬虫任务队列
    taskQueue := make(chan string)

    // 监听Redis的任务队列,并将任务URL加入到爬虫任务队列中
    go func() {
        for {
            task, err := client.BLPop(0, "task_queue").Result()
            if err == nil {
                url := task[1]
                taskQueue <- url
            }
        }
    }()

    // 创建一定数量的爬虫协程,并从爬虫任务队列中获取URL进行爬取
    for i := 0; i < 5; i++ {
        go func() {
            for url := range taskQueue {
                fmt.Println("Crawling", url)
                // TODO: 真正的爬虫逻辑
                // 将爬取结果保存到Redis或其他存储介质中
            }
        }()
    }

    // 阻塞主进程
    select {}
}
在 worker.go 中,我们通过连接到 Redis 数据库,并创建了一个爬虫任务队列 taskQueue。然后,我们在一个 goroutine 中监听 Redis 的任务队列,并将任务 URL 加入到爬虫任务队列中。最后,我们创建了若干个爬虫协程(这里为5个),通过从爬虫任务队列中获取URL进行爬取。
- conn.go
创建一个名为 conn.go 的文件,并编写以下代码:
package main

import (
    "github.com/go-redis/redis"
)

// NewRedisClient 创建一个Redis客户端连接
func NewRedisClient() *redis.Client {
    client := redis.NewClient(&redis.Options{
        Addr:     "localhost:6379",
        Password: "",
        DB:       0,
    })
    return client
}

// AddTask 将任务URL加入到Redis的任务队列中
func AddTask(client *redis.Client, url string) error {
    err := client.RPush("task_queue", url).Err()
    if err != nil {
        return err
    }
    return nil
}
在 conn.go 中,我们封装了连接 Redis 数据库的方法 NewRedisClient() 和将任务 URL 加入到 Redis 的任务队列中的方法 AddTask()。
三、运行程序
在完成以上代码编写后,我们可以运行程序。首先打开一个终端窗口,进入项目根目录,并执行以下命令启动爬虫协程:
go run main.go
然后再打开一个新的终端窗口,同样进入项目根目录,并执行以下命令启动工作协程:
go run worker.go
四、总结
通过上述代码示例,我们了解了如何使用Go语言和Redis开发一个简单的分布式爬虫。主要步骤包括:创建任务队列、创建若干个爬虫协程、监听任务队列、从任务队列中获取URL进行爬取等。同时,我们也了解到如何使用Redis作为任务队列的实现工具,并通过 Redis 的 BLPop 命令从任务队列中获取任务。希望本文能对您对分布式爬虫的理解和实践有所帮助。
新手如何从零搭建Go语言开发环境?本文分步详解Go编译器、VS Code编辑器和Git的安装配置,涵盖环境变量设置、插件安装及国内网络加速方案,助你快速入门Go开发。
这篇文章我们继续聊分布式相关的内容。提到分布式系统,就一定绕不开“一致性”,这次我们说说:最终一致性。最终一致性是现在大部分高可用的分布式系统的核心思路。估计有人对最终一致性不太熟,先来个简单介绍:最终一致性指的是系统中的所有分散在不同节点的数据,经过一定时间后,最终能够达到符合业务定义的一致的状态
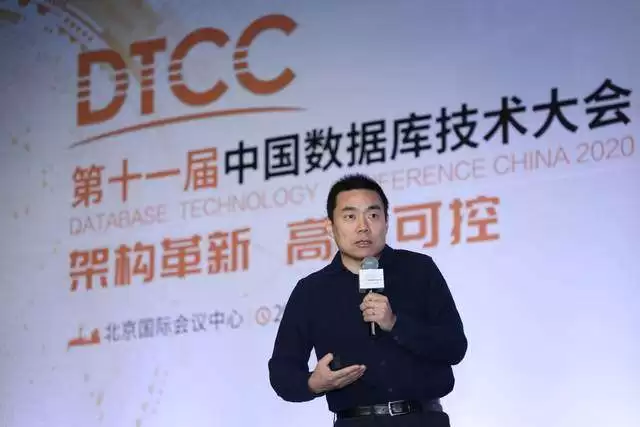
云计算时代,云原生分布式数据库和数据仓库开始崛起,提供弹性扩展、高可用、分布式等特性。数据库将面临怎样的变革?云原生数据库与数据仓库有哪些独特优势?在日前的DTCC 2020大会上,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁、ACM杰出科学家李飞飞就《云原生分布式数据库与数据仓库系统点亮数据上云
FastCFS 是一款基于块存储的通用分布式文件系统,可以作为MySQL、PostgresSQL、Oracle等数据库和云平台的后端存储。 FastDFS已经很受欢迎了,为何还要研发FastCFS呢?FastDFS是轻量级的对象存储,只能通过专有API访问,专为互联网应用设计,适合存放图片、视频、文
随着微服务架构的流行,客户端发起的一次请求可能需要涉及到多个或 N 个服务,致使我们对服务之间的监控和排查变得更加复杂。举个例子:某条业务线的某个接口调用服务端时快时慢,这时就需要排查各个服务的日志进行分析,调动各个服务的开发人员联动排查,这种排查费时又费力。对于 ToB 的业务有时候还拿不到日志,
SpringCloud ConfigSpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集产生背景:在微服务场景下,若继续采用传统方式管理配置文件,配置文件管理器将变得极为复杂。而且在生产环境中,一旦配置文件发生改变,就需要重新配

1 前言 在现在工作中,为保障服务的高可用,应对单点故障、负载量过大等单机部署带来的问题,生产环境常用多机部署。为解决多机房部署导致的数据不一致问题,我们常会选择用分布式锁。目前其他比较常见的实现方案我列举在下面:基于缓存实现分布式锁(本文主要使用redis实现)基于数据库实现分布式锁基于zooke
简介 Hadoop作为被广泛运用的大数据框架,依靠Hadoop分布式文件系统(HDFS)来存储和管理海量数据。但有时会出现HDFS权限问题,影响数据的访问和处理。本教程将带你了解识别和解决HDFS权限问题的流程,助你维护一个强健且安全的Hadoop生态系统。 HDFS 权限概述 HDFS(Hadoo
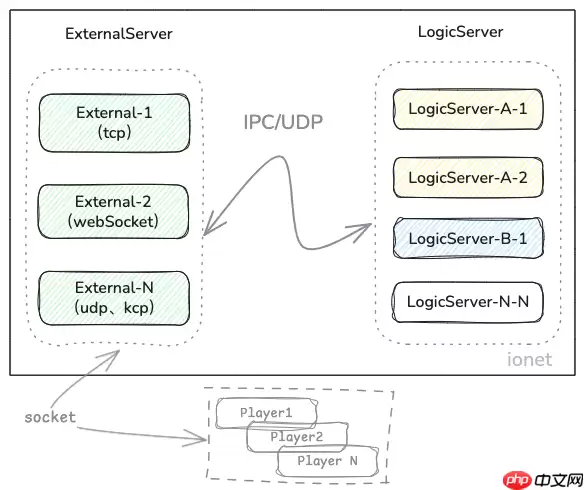
ionet25.3版本发布,基于Aeron构建,实现纳秒级延迟与真零拷贝,无需第三方中间件即可搭建分布式服务器。框架轻量级,15MB启动,支持游戏、物联网、高频交易等场景。采用对外服与逻辑服架构,动态扩缩,类MVC编码,自动生成多前端交互代码。
在Docker环境下为PHP安装Redis扩展:手动编译需下载源码、安装phpize、配置编译并安装,生成redis.so并在php.d目录新建redis.ini加载,重启PHP-FPM;也可直接yum安装php72w-pecl-redis,免手动编译。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



