

图像生成过程中遭「截胡」:稳定扩散的失败案例受四大因素影响
文本到图像的扩散生成模型,如StableDiffusion、DALL-E2和mid-journey等,一直都处于蓬勃的发展状态,有着极强的文本到图片的生成能力,但是「翻车」案例也会偶尔出现。如下图所示,当给定文字提示:「Aphotoofawarthog」,StableDiffusion模型能生成一张相应的、清晰逼真的疣猪照片。然而,当我们对这个文本提示稍作修改,变为:「Aphotoofawarthogandatraitor」,说好的疣猪呢?怎么变成车了?一起再来看一看接下来的几个例子,这些又是什么新物种?
文本到图像的扩散生成模型,如 Stable Diffusion、DALL-E 2 和 mid-journey 等,一直都处于蓬勃的发展状态,有着极强的文本到图片的生成能力,但是「翻车」案例也会偶尔出现。
如下图所示,当给定文字提示:「A photo of a warthog」,Stable Diffusion 模型能生成一张相应的、清晰逼真的疣猪照片。然而,当我们对这个文本提示稍作修改,变为:「A photo of a warthog and a traitor」,说好的疣猪呢?怎么变成车了?
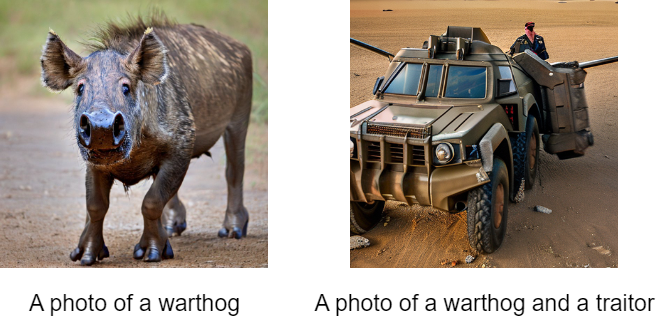
一起再来看一看接下来的几个例子,这些又是什么新物种?
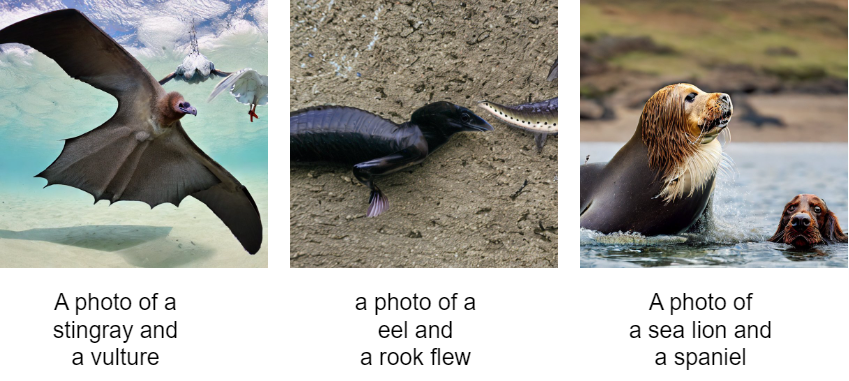
是什么原因导致了这些奇怪的现象?这些生成失败的案例都来自于近期发布的一篇论文《Stable Diffusion is Unstable》:
- 论文地址:https://arxiv.org/abs/2306.02583
在这篇论文中首次提出了一种基于梯度的文本到图像模型的对抗算法。这种算法能够高效且有效地生成大量的攻击性文本提示,能够有效的发掘 Stable diffusion 模型的不稳定之处。这个算法在短文本提示中实现了 91.1% 的攻击成功率,而在长文本提示中,攻击成功率也达到了 81.2%。此外,该算法为研究文本到图像生成模型的失败模式提供了丰富的案例,为图片生成可控性研究奠定了基础。
基于该算法生成出的大量生成失败案例,研究者总结出四点生成失败的原因,分别是:
- 生成速度的差异
- 粗粒度特征的相似性
- 单词的多义性
- 词语在 prompt 中的位置
生成速度的差异
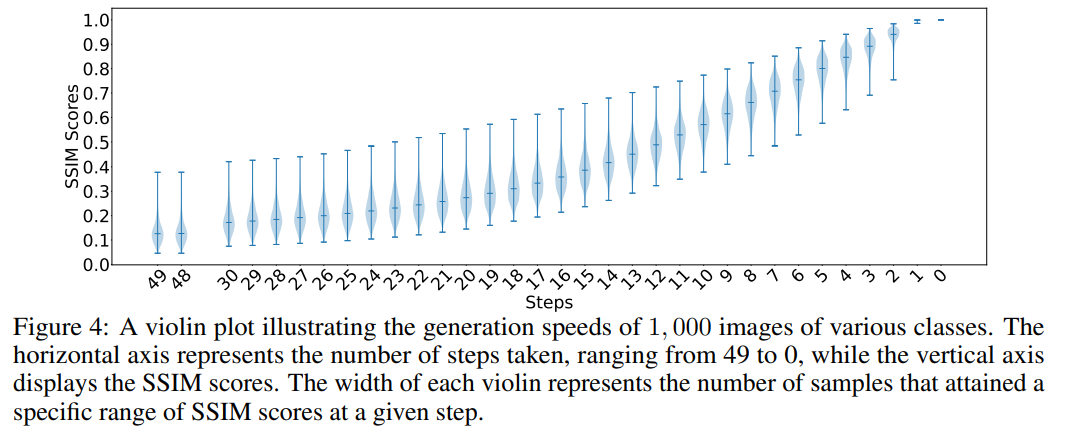
当一个提示(prompt)包含多个生成目标时,常常会遇到某个目标在生成过程中消失的问题。理论上讲,同一个提示内的所有目标都应该共享同一个初始噪声。如图 4 所示,研究者们在固定初始噪声的条件下,生成了 ImageNet 上的一千个类别目标。他们将每个目标生成的最后一张图像作为参考图像,并计算了在每个时间步长上生成的图像与最后一步生成的图像的结构相似性指数(SSIM)得分,以此展示了不同目标生成速度的差异。
粗粒度特征的相似性
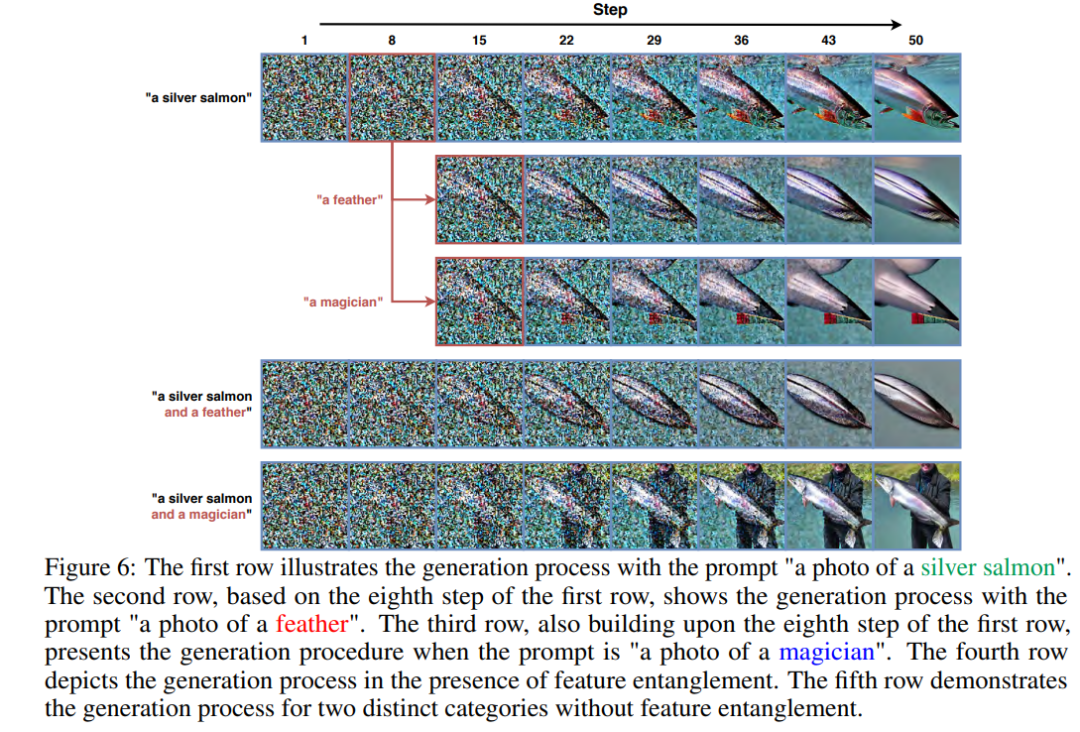
在扩散生成过程中,研究者发现,当两类目标存在全局或局部的粗粒度特征相似性时,会在计算交叉注意力(cross attention)权重时出现问题。这是因为这两个目标名词可能会同时关注同一张图片的同一个区块,从而产生特征纠缠的现象。例如,在图 6 中,羽毛(feather)和银三文鱼(silver salmon)在粗粒度特征上具有一定的相似性,这导致羽毛可以在基于银三文鱼的第八步生成过程中继续完成其生成任务。而对于没有纠缠的两类目标,比如银三文鱼和魔术师(magician),魔术师就无法在基于银三文鱼的中间步骤图像上完成其生成任务。
一词多义
在这一章节中,研究者们深入探索了当一个词语具有多重含义时的生成情况。他们的发现是,如果没有任何外界的扰动,生成的图像通常会按照该词语的某一特定含义来呈现。以 「warthog」(疣猪)为例,在图 A4 中的第一行就是根据这个词语 「疣猪」这种动物的含义进行生成的。
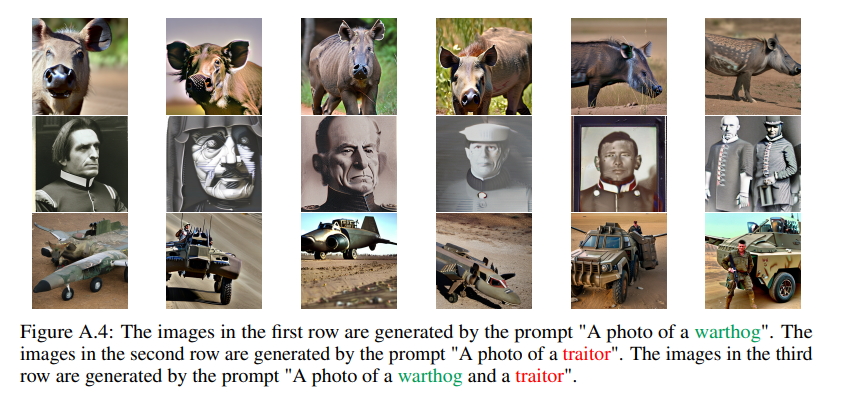
然而,研究者们也发现,当在原始 prompt 中注入其他词语时,就可能会引发语义的偏移。例如,当在描述 「warthog」的提示中引入了词语 「traitor」(叛徒),生成的图像内容可能就会偏离原来的 「疣猪」含义,产生全新的内容。
词语在 prompt 中的位置
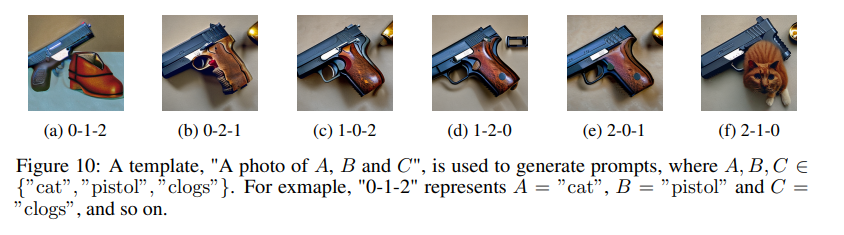
在图 10 中,研究者观察到了一个有趣的现象。虽然从人类的视角来看,那些不同顺序排列的 prompt 大体上含义相同,都是在描述一个既有猫,又有木屐和手枪的图片。然而,对于语言模型,也就是 CLIP 文本编码器来说,词语的顺序在一定程度上影响了其对文本的理解,这种影响反过来又会改变生成图片的内容。这种现象说明,尽管我们的描述在语义上是一致的,但模型却可能因为词语的顺序不同而产生不同的理解和生成结果。这不仅揭示了模型处理语言和理解语义的方式与人类存在差异,同时也提示我们在设计和使用这类模型时,需要更加考虑词语顺序的影响。
模型结构
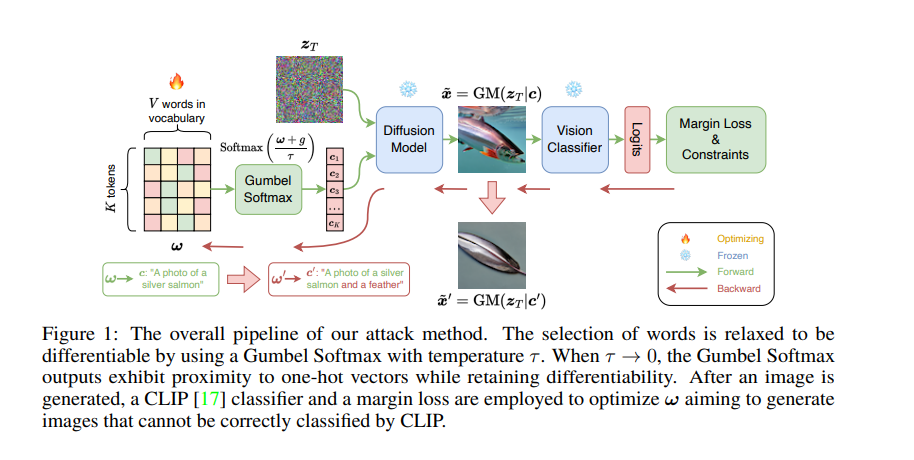
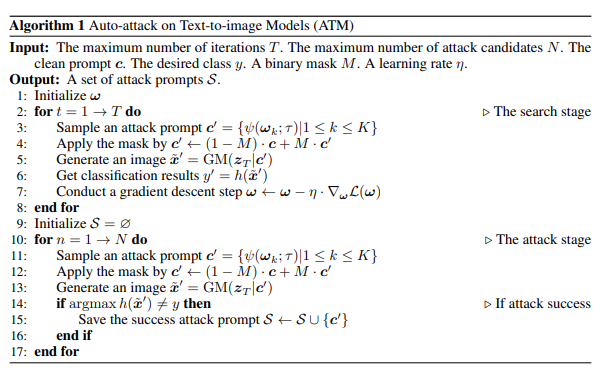
如下图 1 所示,在不改变提示中原本目标名词的前提下,研究者通过学习 Gumbel Softmax 分布,将单词替换或扩展的离散过程连续化,从而确保扰动生成的可微分性,生成图像后,使用 CLIP 分类器和 margin loss 来优化 ω,旨在生成 CLIP 无法正确分类的图像,为了确保攻击性提示与干净提示具有一定的相似性,研究着近一步使用了语义相似性约束和文本流利度约束。
一旦学会了这个分布学会后,该算法能够针对同一个干净的文本提示采样出多个具有攻击效果的文本提示。
更多细节请见原文。


5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
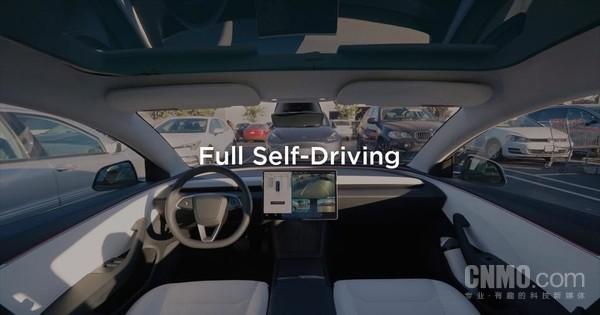
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
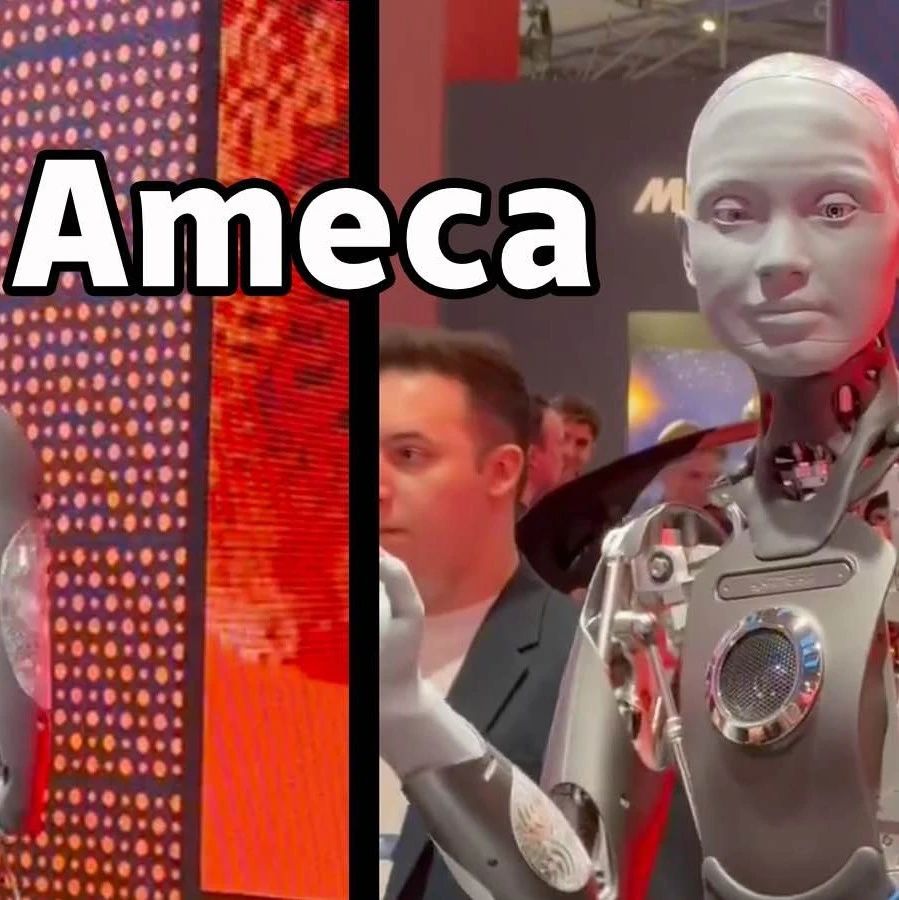
编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了
4月2日,HuggingFace大模型榜单迎来更新,阿里通义千问近期开源的端到端全模态大模型Qwen2.5-Omni力压群雄,荣登榜首!DeepSeek-V3-0324和群核的SpatialLM-Llama-1B紧随其后,杭州公司包揽榜单前三甲。Qwen2.5-Omni展现出卓越的多模态处理能力,能够流畅处理文本、图像、音频和视频等多种数据类型,并实时生成文本及语音输出。在OmniBench等权威多模态融合任务评测中,其性能表现创下新纪录。令人惊喜的是,它仅拥有70亿参数的小巧体积,这使得全模态大模
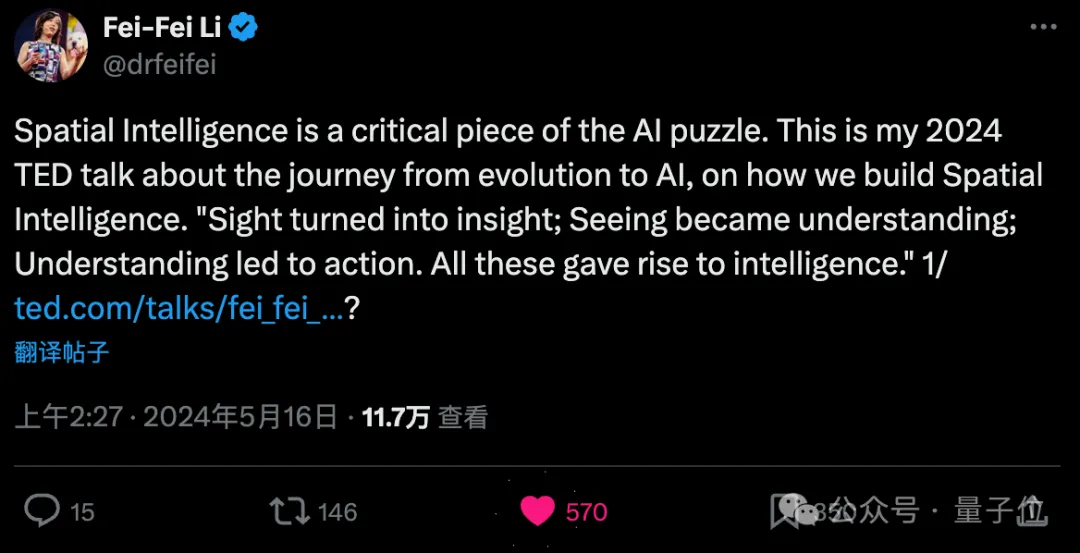
斯坦福李飞飞创业后,首次揭秘新概念“空间智能”。这不仅是她的创业方向,也是指引她的“北极星”,被她认为是“解决人工智能难题的关键拼图”。视觉化为洞察;看见成为理解;理解导致行动。在李飞飞15分钟TED演讲完整公开的基础上,从数亿年前生命进化的起源开始,到人类如何不满足于自然赋予而发展人工智能,直到下一步如何构建空间智能。9年前,李飞飞在同一个舞台上,向世界介绍了刚诞生不久的ImageNet——这一轮深度学习爆发的起点之一。她本人也向网友自我安利:如果把两个视频都看了,你就能对过去10年的计算机视觉、空间智





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



