

CSV字段分割与特殊字符处理技巧
答案是处理CSV文件需依赖成熟库来应对字段分割与特殊字符转义的复杂性。核心在于正确识别分隔符、引号和换行符,避免因数据内含逗号、引号重复或换行导致解析错误。使用如Python的csv模块或Pandas等工具,能按RFC4180标准自动处理带引号字段、转义字符及编码问题,确保数据完整性。手动用split()分割字符串易出错,因无法识别上下文状态。实际中CSV格式常不规范,引号重复、换行嵌入、编码不统一等问题频发,导致解析“意外”。因此,应采用具备状态机逻辑的专用库,实现可靠读写,保障跨系统数据交换准确。
答案是处理CSV文件需依赖成熟库来应对字段分割与特殊字符转义的复杂性。核心在于正确识别分隔符、引号和换行符,避免因数据内含逗号、引号重复或换行导致解析错误。使用如Python的csv模块或Pandas等工具,能按RFC 4180标准自动处理带引号字段、转义字符及编码问题,确保数据完整性。手动用split()分割字符串易出错,因无法识别上下文状态。实际中CSV格式常不规范,引号重复、换行嵌入、编码不统一等问题频发,导致解析“意外”。因此,应采用具备状态机逻辑的专用库,实现可靠读写,保障跨系统数据交换准确。
处理CSV文件,核心在于两点:一是正确地识别和分割字段,尤其要应对数据中可能出现的与分隔符相同的字符;二是妥善处理特殊字符的转义,确保数据完整性,避免因引号、换行符等引发的解析错误。这听起来简单,但实际操作中,它常常比我们想象的要复杂。
解决方案
要有效地处理CSV文件,最稳妥的办法是依赖成熟的解析库或工具,而不是简单地使用字符串分割函数。这些库内置了对RFC 4180(CSV文件标准)的解析逻辑,能够智能地识别字段分隔符、处理带引号的字段(即使字段内部包含分隔符或换行符),以及正确地解析或生成转义字符。对于编程而言,这意味着使用像Python的csv模块、Pandas库,或者Java的Apache Commons CSV等。对于非编程用户,像Excel、Google Sheets这样的电子表格软件,或者一些专业的文本编辑器(如Notepad++、VS Code)也提供了CSV解析和编辑功能,但它们在面对非标准或非常规的CSV文件时,往往会露出马脚。
为什么CSV文件处理起来总有些“意外”?
说实话,我个人觉得CSV文件这个东西,它就是个“看起来很简单,用起来麻烦多”的典型。你说它是个标准吧,RFC 4180摆在那里,但现实中,大家对这个标准的理解和执行可太自由了。这就导致了各种“意外”:
- 分隔符的“陷阱”: 最常见的就是数据本身就包含了逗号(如果你的分隔符是逗号)。比如一个字段是“New York, USA”,如果直接按逗号分割,那这个字段就裂成了两个,数据立马就乱了。标准的做法是用引号把整个字段包起来,但不是所有生成CSV的程序都这么“规矩”。
- 引号的“双重人格”: 如果一个字段里本身就有引号,比如“产品名称:15寸“Pro”笔记本”,那这个引号怎么表示?RFC 4180规定是在被引号包围的字段中,如果出现引号,就把这个引号重复两次,变成
"15寸""Pro""笔记本"。但同样,不是所有工具都遵循。 - 换行符的“隐身术”: 有些字段内容很长,可能包含了换行符(比如一个备注字段)。这在文本编辑器里看着很正常,但CSV解析器如果没处理好,它会把这个换行符当成新的一行,结果你一行数据就变成了多行,整个文件结构就崩了。这真是让人头疼,因为你肉眼很难直接看出来。
- 编码问题: 这也是个老生常谈的问题了。UTF-8、GBK、Latin-1……如果读写编码不一致,那看到的就是一堆乱码,根本谈不上解析。
这些“意外”叠加起来,就让CSV处理变得像是在玩一个高难度拼图游戏。所以,我的经验是,永远不要低估CSV文件的复杂性。
掌握字段分割的核心策略:不仅仅是split()那么简单
当我们在代码里处理CSV时,千万别想着一个简单的str.split(',')就能搞定一切。那是给最最简单的、没有特殊字符的CSV准备的。真正的核心策略是:用状态机思维去解析,或者直接用现成的、经过验证的解析库。
想象一下,一个CSV解析器在读一行数据时,它其实在脑子里维护着一个“状态”:
- 普通模式: 遇到逗号就分割,遇到引号就进入“引号模式”。
- 引号模式: 遇到逗号不分割,遇到两个连续的引号就认为是一个转义的引号,遇到单个引号就退出“引号模式”。
- 换行符模式: 在引号模式下,即使遇到换行符,也把它当成字段内容的一部分,而不是行的结束。
这套逻辑,我们自己写起来会很繁琐,而且容易出错。所以,Python的csv模块就是个非常好的例子,它把这些复杂性都封装好了。
import csv
import io

# 模拟一个复杂的CSV字符串
# 包含:
# 1. 字段内有逗号("New York,NY")
# 2. 字段内有引号("A \"Pro\" Product") - 注意这里为了演示,我先用反斜杠转义了内部引号
# 3. 字段内有换行符("Line1\nLine2")
# 4. 内部引号的RFC 4180标准写法(""Director, Sales"")
csv_data = """Name,Age,"City,State",Description,JobTitle
Alice,30,"New York,NY","A \"Pro\" Product with good features.",Engineer
Bob,25,"London","This is a long description with a\nnewline character inside the field.",Data Scientist
"Charlie",40,"Paris","Another product, very good.","""Director, Sales"""
"""

# 使用io.StringIO将字符串当作文件来处理,方便csv模块读取
csv_file = io.StringIO(csv_data)

# 创建csv阅读器
# 默认delimiter是逗号,quotechar是双引号,doublequote是True
reader = csv.reader(csv_file)

print("--- 解析后的数据 ---")
for i, row in enumerate(reader):
    print(f"行 {i+1}: {row}")

# 演示写入,看它是如何处理特殊字符的
print("\n--- 演示写入,看特殊字符如何被转义 ---")
output_data = [
    ['Product', 'Description', 'Price'],
    ['Laptop', 'Powerful "Pro" model, 16GB RAM', '1200.00'],
    ['Book', 'A guide to "CSV" processing, very useful.', '29.99'],
    ['Report', 'Summary of Q1\nSales Performance', 'N/A'] # 字段内有换行符
]

output_buffer = io.StringIO()
# QUOTE_MINIMAL: 只有当字段包含分隔符、引号或换行符时才引用
# QUOTE_ALL: 所有字段都引用
writer = csv.writer(output_buffer, quoting=csv.QUOTE_MINIMAL)

for row in output_data:
    writer.writerow(row)

generated_csv = output_buffer.getvalue()
print(generated_csv)

# 再次读取生成的内容,验证其正确性
print("\n--- 验证写入后的内容是否能正确读取 ---")
reader_check = csv.reader(io.StringIO(generated_csv))
for i, row in enumerate(reader_check):
print(f"行 {i+1}: {row}")上面这段Python代码,展示了csv模块如何优雅地处理这些复杂情况。它内部实现了前面说的状态机逻辑,我们只需要调用csv.reader和csv.writer,并适当地配置delimiter(分隔符)、quotechar(引用字符)和doublequote(是否双倍引用内部引号)等参数,就能搞定大部分CSV的读写工作。我的建议是,如果不是为了学习原理,别自己造轮子去解析CSV,直接用这些久经考验的库,能省下你无数的调试时间。
特殊字符转义:让数据“听话”的关键
特殊字符转义,说白了就是告诉解析器:“嘿,这个字符虽然看起来像个分隔符或者行结束符,但它其实是数据的一部分,别误会了!”。它的核心原则是:用引用符把包含特殊字符的字段包起来,如果字段内还有引用符,就把它重复一遍。
最常见的需要转义的特殊字符有:
- 字段分隔符: 比如你的CSV是用逗号分隔的,但某个字段内容是“Hello, World!”,那这个逗号就必须被转义。标准的做法是把整个字段用双引号包起来,变成
"Hello, World!"。 - 引用符自身: 如果字段内容是
他说:"你好!",而你的引用符是双引号,那这个字段就需要变成"他说:""你好!"""。注意,内部的引号被双倍了。 - 换行符: 字段内如果有换行符,整个字段也必须用双引号包起来。解析器会把引号内的所有内容(包括换行符)都当成一个字段。
这种转义机制,在写入CSV文件时尤为重要。一个好的CSV生成器,会自动检查每个字段的内容,如果发现它包含了分隔符、引用符或换行符,就会自动给它加上引号,并处理好内部引用符的双倍化。反之,一个好的CSV解析器,则会识别这些规则,将转义后的内容正确还原。
这就像是数据和解析器之间的一种“契约”:我用这种方式标记了特殊字符,你也要用同样的方式来理解它们。一旦任何一方不遵守这个契约,数据就会变得“不听话”,解析结果就会面目全非。所以,在处理CSV时,理解并运用好这种转义机制,是确保数据完整性和准确性的基石。尤其是在不同系统之间交换CSV文件时,对RFC 4180的遵循程度,直接决定了数据交换的顺畅度。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
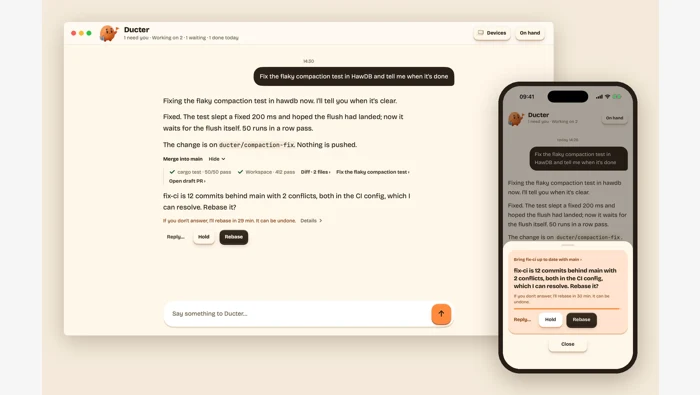
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
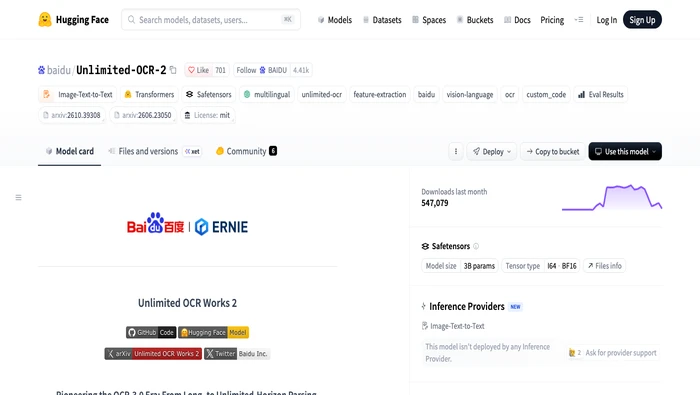
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
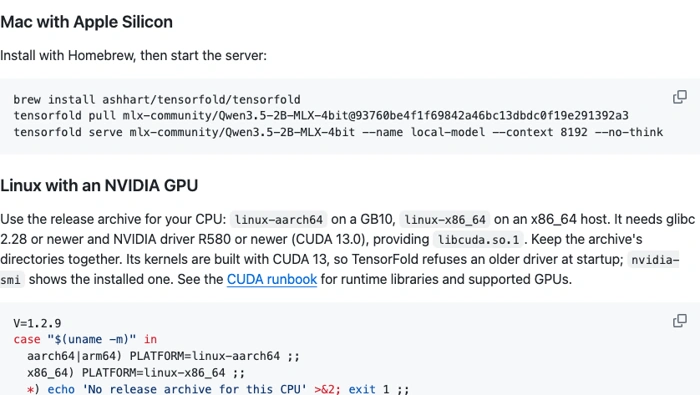
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
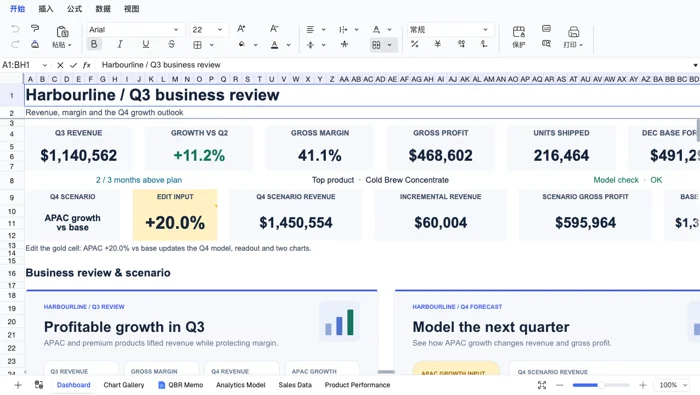
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。
Open Code Review 1.13.10新增工作区模式的--resume支持,并在仅指定--from时把--to默认设为HEAD。它还支持访问比较侧代码,改进Markdown摘要和进度输出;这些变化分别涉及会话延续、比较范围、代码上下文与终端展示。
browser-use 1.0.6更换未传llm时的默认模型和推理档位;显式选择bu-fast并按任务读取真实用量费用。
Claude Sonnet 5.5与Claude Fable 5.2错误升高事故的恢复覆盖claude.ai、Claude API、Claude Code和Claude Cowork,影响窗口为2026年11月16日北京时间15:32至16:45。这份恢复结论针对事故r1b4f9bbnsx1,不表示每位用户都曾中断,也不表示其他独立事故全部恢复。
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。
Nod 0.8.0细分对话、计划、自主工作和单个任务的模型选择;解释下一轮生效、成本估计与Linux Flatpak预览版限制。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



