

Lambda表达式简化STL代码技巧
Lambda表达式在STL中简化了自定义逻辑的内联使用,提升代码可读性和编写效率,通过捕获列表访问外部变量,广泛应用于排序、查找、遍历等场景,需注意避免过度复杂化、悬空引用和不必要的拷贝。
Lambda表达式在STL中简化了自定义逻辑的内联使用,提升代码可读性和编写效率,通过捕获列表访问外部变量,广泛应用于排序、查找、遍历等场景,需注意避免过度复杂化、悬空引用和不必要的拷贝。
Lambda表达式在STL中的应用,核心在于它极大地简化了代码结构,让原本需要额外定义函数或函数对象的场景变得直接且内联,从而提升了代码的可读性和编写效率。说白了,它就是让你的算法逻辑直接在需要的地方“冒出来”,省去了很多繁琐的定义步骤。
解决方案
谈到Lambda表达式在STL中的应用,它就像给C++这门语言注入了一剂强心针,尤其是在处理各种容器和算法时。我个人觉得,它最大的魅力在于提供了一种简洁、上下文感强的匿名函数定义方式。以前,我们要在STL算法(比如std::sort、std::for_each、std::find_if)里塞入自定义逻辑,通常得写个独立的函数,或者定义一个仿函数(function object)类。这确实能解决问题,但代码经常会变得分散,尤其对于那些只用一次、逻辑又很简单的小操作,总感觉有点“杀鸡用牛刀”的意思。
Lambda的出现彻底改变了这一点。你可以直接在调用STL算法的地方,把那段自定义逻辑写进去。它有几个核心部件:捕获列表([])、参数列表(())、可选的mutable关键字、可选的异常规范、可选的返回类型(->)以及函数体({})。最常用的就是捕获列表和函数体。捕获列表允许你访问外部作用域的变量,这简直是神来之笔。比如,你想在一个容器里找出所有大于某个特定值的元素,这个“特定值”就可以通过捕获列表传进去,而不用把它变成全局变量或者函数参数层层传递。
举个例子,假设我们有个std::vector,想按降序排列:
std::vectornumbers = {1, 5, 2, 8, 3}; // 以前可能要写一个独立的比较函数或者仿函数 // std::sort(numbers.begin(), numbers.end(), std::greater ()); // 现在用Lambda,直接写在原地 std::sort(numbers.begin(), numbers.end(), [](int a, int b) { return a > b; // 降序 }); // numbers 现在是 {8, 5, 3, 2, 1}
你看,代码是不是一下子就清晰了很多?逻辑就在眼前,不用跳到别处找定义。这种内联的表达方式,在我看来,极大地提高了代码的“局部可读性”。
Lambda表达式如何提升STL算法的灵活性和可读性?
在我看来,Lambda表达式对STL算法的提升,不仅仅是“简化”这么简单,它更像是一种思维方式的转变,让我们的代码变得更“流式”和“即时”。以前,每次需要定制算法行为,比如自定义排序规则,我总得跳出去写个独立的函数或者仿函数,然后回到原处调用。这虽然是标准做法,但对于那些一次性的、小段的逻辑,这种“上下文切换”的开销是真实存在的,不光是编译器的开销,更是我们大脑的认知开销。
Lambda的出现,让这些定制逻辑直接“嵌入”到算法调用点。这带来了几个显而易见的好处:
逻辑内聚性:算法的行为定制,和算法本身的代码紧密结合在一起。你一眼就能看到这个
std::sort为什么是降序,这个std::find_if在找什么。这种内聚性大大减少了理解代码时所需的“跳转”次数。就像你在看一篇文章,所有相关的注解都直接在段落旁边,而不是在文章末尾的附录里。减少样板代码:不用为了一个简单的比较或判断,特意去定义一个类或者一个全局函数。那些只用一次的小逻辑,就让它“活”在它被需要的地方,用完即弃,不污染命名空间,也不增加额外的定义文件。这对于我这种有点“洁癖”的开发者来说,简直是福音。
强大的捕获能力:这是Lambda的杀手锏之一。通过捕获列表,Lambda可以直接访问其定义所在作用域的变量。这意味着你可以轻松地在算法中使用外部的上下文信息,而无需通过复杂的参数传递。比如,在一个循环里,你想找出所有大于当前循环变量
threshold的元素:int threshold = 5; std::vector
data = {1, 7, 3, 9, 2, 6}; auto it = std::find_if(data.begin(), data.end(), [threshold](int val) { return val > threshold; }); // 如果找到了,it指向第一个大于5的元素 (7) 这里的
[threshold]就是捕获了外部的threshold变量。这种能力让算法的定制化变得异常灵活,你几乎可以把任何你需要的上下文信息“带入”到算法的执行中。这在处理复杂业务逻辑时,简直是提升开发效率的神器。
在STL中使用Lambda表达式有哪些常见的场景和技巧?
在STL中,Lambda表达式的应用场景非常广泛,几乎可以说只要你需要自定义算法行为,它就能派上用场。我个人觉得,以下几个场景是使用Lambda的“黄金地带”,掌握它们能让你的C++代码更上一层楼:
排序与查找(
std::sort,std::stable_sort,std::find_if,std::remove_if,std::count_if): 这是最常见的应用。当你需要非默认的比较规则(比如按对象的某个成员排序),或者需要根据复杂的条件查找/过滤元素时,Lambda是首选。struct Person { std::string name; int age; }; std::vectorpeople = {{"Alice", 30}, {"Bob", 25}, {"Charlie", 30}}; // 按年龄降序排序,年龄相同按名字升序 std::sort(people.begin(), people.end(), [](const Person& p1, const Person& p2) { if (p1.age != p2.age) { return p1.age > p2.age; } return p1.name < p2.name; }); // 查找第一个年龄大于28的人 auto it = std::find_if(people.begin(), people.end(), [](const Person& p) { return p.age > 28; }); 这种直接的逻辑嵌入,避免了为
Person类写operator<的麻烦,也避免了单独定义比较函数。遍历与转换(
std::for_each,std::transform): 当你想对容器中的每个元素执行某个操作,或者将元素转换为另一种形式时,Lambda也非常方便。std::vector
nums = {1, 2, 3, 4, 5}; // 将所有数字翻倍 std::transform(nums.begin(), nums.end(), nums.begin(), [](int n) { return n * 2; }); // nums 现在是 {2, 4, 6, 8, 10} // 打印每个元素,并加上前缀 std::string prefix = "Item: "; std::for_each(nums.begin(), nums.end(), [&prefix](int n) { // 注意这里捕获了prefix std::cout << prefix << n << std::endl; }); 这里
[&prefix]是按引用捕获,效率高且能访问外部变量。捕获列表的艺术:
[]:不捕获任何变量。[=]:按值捕获所有外部作用域的局部变量。这意味着Lambda内部会有一份这些变量的拷贝。[&]:按引用捕获所有外部作用域的局部变量。这意味着Lambda内部直接使用外部变量的引用,可以修改它们(如果变量本身可修改)。[var]:按值捕获指定的变量var。[&var]:按引用捕获指定的变量var。[this]:捕获当前对象的this指针,允许Lambda访问成员变量和成员函数。[x, &y]:混合捕获,x按值,y按引用。[=, &y]:默认按值捕获,但y按引用捕获。[&, y]:默认按引用捕获,但y按值捕获。
选择正确的捕获方式至关重要。我个人倾向于明确指定捕获哪些变量(
[var]或[&var]),而不是使用[=]或[&]这种“全捕获”模式,因为这样能更清晰地表达Lambda的依赖,避免不必要的捕获或潜在的悬空引用问题。mutable关键字: 如果你的Lambda是按值捕获的,并且你想在Lambda内部修改这些捕获的变量,你需要加上mutable关键字。int counter = 0; auto incrementer = [counter]() mutable { // counter是按值捕获的副本 counter++; // 这里修改的是副本 std::cout << "Inside lambda: " << counter << std::endl; }; incrementer(); // 输出: Inside lambda: 1 incrementer(); // 输出: Inside lambda: 2 std::cout << "Outside lambda: " << counter << std::endl; // 输出: Outside lambda: 0这个特性有时候会让人迷惑,因为它修改的是副本,而不是外部的原始变量。要修改外部变量,你得用引用捕获
[&counter]。
使用Lambda表达式可能遇到的挑战或误区有哪些?
尽管Lambda表达式带来了巨大的便利,但在实际使用中,也确实有一些坑或者说需要注意的地方。我个人在踩过一些坑之后,总结了几点:
过度复杂化Lambda: 有时候,为了追求“一行代码”的简洁,我们可能会把过于复杂的逻辑塞进一个Lambda里。当Lambda的函数体变得很长,或者包含多层嵌套逻辑时,它的可读性反而会下降。这时,我通常会反思一下,是不是应该把它抽离成一个独立的、命名的函数或者仿函数。Lambda的优势在于简洁和内联,如果失去了这个优势,它就失去了存在的意义。
捕获列表的陷阱——悬空引用: 这是最常见也最危险的错误之一。当你使用引用捕获
[&]或者[&var]时,一定要确保被捕获的变量在Lambda执行时仍然有效。如果Lambda被存储起来(比如作为std::function对象),或者被传递到异步任务中执行,而它引用的局部变量已经超出了作用域,那么你就会遇到未定义行为,也就是俗称的“野引用”。std::function
解决这个问题的方法通常是按值捕获
[=value]或者[value],让Lambda拥有变量的拷贝。当然,如果变量是堆上的对象,并且你希望Lambda管理其生命周期,那可能需要智能指针。性能考量——不必要的拷贝: 与悬空引用相反,过度使用按值捕获
[=]或[var]也可能导致性能问题,尤其当捕获的是大型对象时。每次Lambda被调用,都可能涉及一次对象的拷贝。虽然现代编译器通常很聪明,会进行优化,但在性能敏感的场景,还是需要留意。这时,如果能确保生命周期安全,按引用捕获[&]或[&var]会是更好的选择。调试的挑战: Lambda是匿名函数,这使得在调试器中查看其调用栈或设置断点时,可能会比命名函数稍微麻烦一些。不过,现代IDE和调试器对Lambda的支持已经相当不错了,通常会给它们生成一个可识别的内部名称。但这仍然不如一个清晰命名的函数来得直观。
Lambda的类型: 每个Lambda表达式都有一个独一无二的、编译器生成的匿名类型。这意味着你不能直接将一个Lambda赋值给另一个Lambda,除非它们不捕获任何变量(此时它们可以隐式转换为函数指针),或者你使用
std::function来“擦除”它们的具体类型。auto lambda1 = [](){ std::cout << "Hello" << std::endl; }; // auto lambda2 = lambda1; // 可以,因为不捕获,类型相同 // std::function理解这一点对于将Lambda作为参数传递或存储在容器中非常重要。通常,
std::function是处理Lambda多态性的首选工具。
总的来说,Lambda表达式是C++11以来最棒的特性之一,它让STL算法的使用变得更加流畅和富有表现力。但就像任何强大的工具一样,理解其工作原理和潜在的陷阱,才能真正发挥它的威力。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
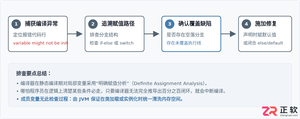
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
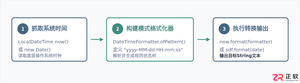
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
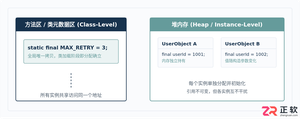
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
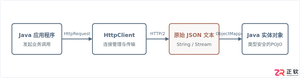
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
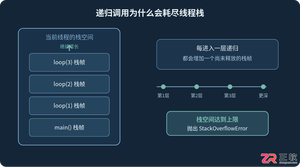
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
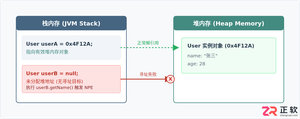
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



