

Python爬虫数据存储全攻略
Python中存储爬虫结果的方法包括文件、数据库和云存储。1.文件存储:适合小数据量,使用CSV、JSON或纯文本文件。2.数据库存储:适用于大数据量和复杂查询,支持SQLite、MySQL、PostgreSQL等。3.云存储:如AmazonS3或GoogleCloudStorage,适合大规模和分布式系统。
Python中存储爬虫结果的方法包括文件、数据库和云存储。1. 文件存储:适合小数据量,使用CSV、JSON或纯文本文件。2. 数据库存储:适用于大数据量和复杂查询,支持SQLite、MySQL、PostgreSQL等。3. 云存储:如Amazon S3或Google Cloud Storage,适合大规模和分布式系统。

嘿,Pythoner们,今天我们来聊聊一个非常实用的主题——在Python中如何存储爬虫结果。首先要回答的问题是:Python中如何存储爬虫结果?答案是多样的,我们可以使用文件、数据库、甚至是云存储来保存这些数据。接下来,让我们深入探讨一下这些方法的具体实现和各自的优劣。
在Python中,存储爬虫结果的选择多种多样,这取决于你的需求和项目规模。如果你只是想快速保存一些数据,文件存储可能是最简单的方法。CSV、JSON、甚至是纯文本文件都可以用来存储爬虫结果。CSV文件适合表格数据,JSON文件则更适合存储复杂的嵌套数据结构,而纯文本文件则适用于日志或简单的数据记录。
不过,文件存储也有其局限性。当数据量变大时,管理和查询这些文件会变得非常麻烦。这时候,数据库就派上用场了。Python支持多种数据库,如SQLite、MySQL、PostgreSQL等。使用数据库可以更高效地存储和查询数据,特别是当你需要对数据进行复杂的操作时。
让我们来看一个简单的例子,使用CSV文件来存储爬虫结果:
import csv

# 假设这是你的爬虫结果
results = [
    {'title': 'Python Tutorial', 'url': 'https://www.python.org/doc/'},
    {'title': 'Python for Beginners', 'url': 'https://www.python.org/about/gettingstarted/'}
]

# 打开一个CSV文件,写入数据
with open('crawler_results.csv', 'w', newline='') as csvfile:
    fieldnames = ['title', 'url']
    writer = csv.DictWriter(csvfile, fieldnames=fieldnames)

    writer.writeheader()
    for result in results:
        writer.writerow(result)
这个代码片段展示了如何将爬虫结果保存到CSV文件中。简单而有效,但如果你需要更复杂的查询和数据管理,数据库可能是更好的选择。
现在,让我们来看看使用SQLite数据库来存储爬虫结果的例子:
import sqlite3

# 假设这是你的爬虫结果
results = [
    {'title': 'Python Tutorial', 'url': 'https://www.python.org/doc/'},
    {'title': 'Python for Beginners', 'url': 'https://www.python.org/about/gettingstarted/'}
]

# 连接到SQLite数据库
conn = sqlite3.connect('crawler_results.db')
cursor = conn.cursor()

# 创建表
cursor.execute('''
    CREATE TABLE IF NOT EXISTS results (
        id INTEGER PRIMARY KEY AUTOINCREMENT,
        title TEXT,
        url TEXT
    )
''')

# 插入数据
for result in results:
    cursor.execute('INSERT INTO results (title, url) VALUES (?, ?)',
                   (result['title'], result['url']))

# 提交事务并关闭连接
conn.commit()
conn.close()
使用SQLite的好处在于它是一个轻量级的嵌入式数据库,非常适合小型项目或个人使用。不过,如果你的项目需要更高的并发性和更复杂的查询,考虑使用MySQL或PostgreSQL可能会更好。
当然,除了本地存储,我们还可以考虑使用云存储服务,如Amazon S3或Google Cloud Storage。这些服务提供了高可用性和可扩展性,特别适合大规模数据存储和分布式系统。
在选择存储方法时,需要考虑以下几个因素:
- 数据量:如果数据量小,文件存储可能足够;如果数据量大,数据库或云存储更合适。
- 查询需求:如果你需要频繁查询数据,数据库是更好的选择。
- 数据结构:如果数据结构复杂,JSON或数据库可能更适合。
- 扩展性:如果你的项目需要扩展,云存储是一个不错的选择。
在实际项目中,我曾经遇到过一个问题:爬虫结果的数据量非常大,导致CSV文件变得难以管理。我们最终选择了使用PostgreSQL数据库来存储数据,这样不仅提高了查询效率,还能更好地管理数据。
最后,分享一个小技巧:在存储爬虫结果时,记得添加时间戳,这样可以方便地追踪数据的更新时间。这在数据分析和维护时非常有用。
希望这篇文章能帮你更好地理解在Python中如何存储爬虫结果。如果你有其他问题或经验,欢迎在评论区分享!
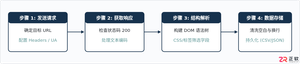
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
requests库是Python爬虫常用工具,安装命令为pipinstallrequests。通过requests.get()发送GET请求,可传入params参数添加URL参数;使用requests.post()发送POST请求,data传递表单数据,json参数发送JSON数据。可设置headers模拟浏览器访问,避免反爬。响应对象提供status_code、headers、text、content、json()等属性解析结果。结合BeautifulSoup或正则表达式提取数据,可构建完整爬虫流程,需
日志记录能提升爬虫的可维护性和调试效率,通过logging模块实现多级别信息分类、异常捕获及文件保存,结合模块化配置实现透明化运行。
答案:使用requests库可安全抓取HTTPS网站,需正确处理SSL证书验证。默认情况下requests会自动验证服务器证书,确保连接安全;若遇自签名或私有CA证书,可指定本地证书路径或谨慎关闭验证(仅限测试);结合headers、cookies和代理提升兼容性与隐蔽性;对高级需求可用urllib3或自定义SSL上下文控制TLS行为;保持库更新以支持最新安全标准。
答案:Python爬虫数据可保存为CSV、JSON、Excel或存入MySQL、MongoDB。小数据用CSV/JSON,分析选Excel,长期结构化存储用MySQL,非结构化数据选MongoDB,注意编码与异常处理。
使用异步请求、统一解析接口、反爬策略和容错机制可高效抓取多网站数据。1.采用aiohttp+asyncio并发请求,显著提升抓取效率;2.为各站点编写独立解析函数并注册到统一映射表,实现结构化输出;3.设置请求头、频率控制、代理IP和重试机制应对反爬;4.成功数据存入数据库,失败记录日志以便重试,确保程序稳定运行。
先掌握Python基础语法,再学习requests库发送请求,用BeautifulSoup解析网页,逐步应对反爬机制并实践小项目。

在Python中处理爬取数据主要使用BeautifulSoup解析HTML、json模块处理JSON和xml.etree.ElementTree解析XML。1)使用BeautifulSoup从HTML中提取标题和段落。2)用json.loads()解析JSON数据。3)用xml.etree.ElementTree从XML中提取信息。数据处理还包括清洗、转换和存储,通常使用pandas库进行操作。
合规使用Python爬虫需遵循robots协议并依法获取数据。首先通过urllib.robotparser读取robots.txt判断可抓取范围,示例代码显示利用RobotFileParser类检查目标URL权限,并在请求前集成该逻辑。其次控制请求频率,使用time.sleep()加入1-3秒随机延迟或Scrapy的AUTOTHROTTLE扩展减轻服务器压力。同时遵守《网络安全法》《数据安全法》等法规,不采集隐私信息,非授权不得用于商业或传播受版权保护内容。设置规范User-Agent头表明身份,如包含爬
掌握Python爬虫需四步:先用requests发送HTTP请求获取HTML源码,注意添加User-Agent;再用BeautifulSoup或lxml解析HTML提取数据;若页面为JavaScript动态加载,则使用Selenium模拟浏览器;最后将数据保存为CSV或JSON,并通过设置请求间隔、代理IP等应对反爬策略。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



