

Python大规模球体无重叠移动模拟优化技巧
本文探讨了在Python中高效模拟大量无重叠球体在特定空间内随机移动的方法。针对初始实现中存在的性能瓶颈,文章详细介绍了如何通过优化近邻搜索(使用cKDTree的批处理查询和多核并行)、以及利用Numba进行JIT编译来显著提升模拟速度,实现更流畅、快速的物理模拟。

1. 问题背景与初始实现分析
在物理模拟、图形学或科学计算等领域,经常需要模拟大量粒子或物体(如球体)的随机运动,同时要确保它们之间不发生重叠,并遵守特定的空间边界条件。当球体数量达到百万级别时,这种模拟的计算成本会急剧增加,尤其是在处理碰撞检测(即重叠检查)时。
一个常见的初始实现思路是:
- 为每个球体生成一个随机的移动向量。
- 计算球体的新位置。
- 检查新位置是否在空间边界内。
- 检查新位置是否与其他球体发生重叠。
- 如果所有条件都满足,则接受移动;否则,拒绝移动并保持原位。
在Python中,如果直接按照上述逻辑逐个球体进行操作,并使用scipy.spatial.cKDTree进行近邻查询,但每次移动一个球体就重建或重复查询KDTree,会导致严重的性能问题。尤其当球体数量巨大时,这种逐点处理和频繁的KDTree操作会使得模拟速度变得异常缓慢。
初始实现的主要性能瓶颈:
- KDTree的重复构建与查询: 在每次迭代中,针对每个球体都调用tree.query_ball_point(),如果KDTree在循环内部被频繁构建,或者查询操作没有充分利用其批处理能力,都会成为瓶颈。
- 距离计算效率: 检查重叠需要计算球体中心间的距离,如果这部分代码没有优化,例如在纯Python循环中进行,会非常慢。
- Python循环的开销: 核心的移动和检查逻辑如果大量依赖于Python层的显式循环,其执行效率远低于底层C或Fortran实现。
2. 核心优化策略
为了显著提升大规模球体随机运动模拟的性能,可以从以下几个方面进行优化:
2.1 优化近邻搜索:cKDTree的批处理查询
scipy.spatial.cKDTree是一个高度优化的数据结构,用于高效地执行近邻搜索。其query_ball_point()方法不仅可以查询单个点,还可以接受一个点数组进行批处理查询。利用这一点可以大幅减少KDTree的查询开销。
优化点:
- 在每次大迭代(N_motions)开始时构建一次KDTree。
- 使用tree.query_ball_point()一次性查询所有球体的潜在邻居,而不是在内部循环中逐个查询。
2.2 利用多核并行计算
cKDTree的query_ball_point()方法支持多核并行计算,通过设置workers=-1参数,可以使其尽可能利用所有可用的CPU核心,进一步加速近邻查询过程。
优化点:
- 在调用query_ball_point()时,设置workers=-1。
2.3 使用Numba进行JIT编译
Numba是一个开源的JIT(Just-In-Time)编译器,可以将Python和NumPy代码编译成快速的机器码。对于计算密集型的函数,尤其是涉及循环和数值运算的部分,使用Numba的@nb.njit()装饰器可以带来显著的性能提升。
优化点:
- 将边界检查函数(in_cylinder)用@nb.njit()装饰。
- 将随机向量生成函数(generate_random_vector)用@nb.njit()装饰。
- 将欧几里得距离计算函数(euclidean_distance)用@nb.njit()装饰。
- 将邻居重叠检查函数(any_neighbor_in_range)用@nb.njit()装饰。
Numba优化细节:
- in_cylinder函数: 为了进一步提升效率,在检查径向距离时,可以比较半径的平方而不是先计算平方根再比较,因为平方根操作相对耗时。即radial_distances <= Rmax ** 2。
- euclidean_distance函数: 即使是简单的循环,在@nb.njit()的加持下也能编译成高效的机器码。
3. 优化后的代码实现
下面是结合上述优化策略后的Python代码实现。
import numpy as np
from scipy.spatial import cKDTree
import numba as nb
import math

# 假设Rmax, Zmin, Zmax是全局变量或通过参数传入
# 为了演示,这里定义一些示例值
Rmax = 100.0
Zmin = -50.0
Zmax = 50.0

@nb.njit()
def in_cylinder(point, Rmax_sq, Zmin, Zmax):
    """
    检查一个点是否在圆柱体内。
    使用Rmax_sq (Rmax的平方) 避免不必要的平方根计算。
    point: 单个点的坐标数组 [x, y, z]
    """
    # 径向距离的平方
    radial_distance_sq = point[0]**2 + point[1]**2
    return (radial_distance_sq <= Rmax_sq) & \
           (Zmin <= point[2]) & (point[2] <= Zmax)

@nb.njit()
def generate_random_vector(max_magnitude):
    """
    生成一个随机方向和随机大小的3D向量。
    """
    # 生成一个随机方向向量
    direction = np.random.randn(3)
    direction_norm = np.linalg.norm(direction)
    # 避免除以零
    if direction_norm == 0:
        direction = np.array([1.0, 0.0, 0.0]) # 默认方向
    else:
        direction /= direction_norm

    # 生成一个随机大小
    magnitude = np.random.uniform(0, max_magnitude)
    return direction * magnitude

@nb.njit()
def euclidean_distance(vec_a, vec_b):
    """
    计算两个3D向量之间的欧几里得距离。
    """
    acc = 0.0
    for i in range(vec_a.shape[0]):
        acc += (vec_a[i] - vec_b[i]) ** 2
    return math.sqrt(acc)

@nb.njit()
def any_neighbor_in_range(new_center, all_centers, neighbors_indices, threshold, ignore_idx):
    """
    检查新球体中心是否与任何潜在邻居重叠。
    all_centers: 所有球体的中心点数组
    neighbors_indices: 潜在邻居的索引列表
    threshold: 距离阈值 (2 * r_spheres)
    ignore_idx: 当前移动球体的索引,避免与自身比较
    """
    for neighbor_idx in neighbors_indices:
        if neighbor_idx == ignore_idx:
            # 忽略自身
            continue
        distance = euclidean_distance(new_center, all_centers[neighbor_idx])
        if distance < threshold:
            return True # 发现重叠
    return False # 没有重叠

def move_spheres_optimized(centers, r_spheres, motion_coef, N_motions):
    """
    优化后的球体随机移动函数。
    centers: 初始球体中心点数组 (N, 3)
    r_spheres: 球体半径
    motion_coef: 运动系数,用于计算最大移动距离
    N_motions: 模拟的总步数
    """
    n_spheres = len(centers)
    updated_centers = np.copy(centers)
    motion_magnitude = motion_coef * r_spheres
    overlap_threshold = 2 * r_spheres # 两个球体不重叠的最小距离
    Rmax_sq = Rmax ** 2 # 预计算Rmax的平方

    for motion_step in range(N_motions):
        # 每步重新构建KDTree,因为球体位置可能发生变化
        # 使用updated_centers构建KDTree
        tree = cKDTree(updated_centers)

        # 批处理查询所有球体的潜在邻居,利用多核并行
        # 查询半径为 2*r_spheres + 2*motion_magnitude,这是最大可能重叠的范围
        potential_neighbors_batch = tree.query_ball_point(
            updated_centers,
            overlap_threshold + 2 * motion_magnitude, # 考虑最大移动距离后的潜在邻居范围
            workers=-1 # 利用所有可用CPU核心
        )

        updated_count = 0
        for i in range(n_spheres):
            # 生成随机移动向量
            vector = generate_random_vector(motion_magnitude)

            # 预测新中心位置
            new_center = updated_centers[i] + vector

            # 检查空间边界
            if in_cylinder(new_center, Rmax_sq, Zmin, Zmax):
                # 获取当前球体的潜在邻居索引
                neighbors_indices = np.array(potential_neighbors_batch[i], dtype=np.int64)

                # 检查是否与任何邻居重叠
                overlap = any_neighbor_in_range(
                    new_center,
                    updated_centers,
                    neighbors_indices,
                    overlap_threshold,
                    i
                )

                # 如果没有重叠,则更新球体位置
                if not overlap:
                    updated_centers[i] = new_center
                    updated_count += 1
            # else:
                # print('out of cylinder') # 调试信息,在生产代码中通常移除

        print(f"Motion Step {motion_step + 1}/{N_motions}: Updated {updated_count} spheres ({updated_count/n_spheres:.2%})")
    return updated_centers

# 示例用法 (需要先定义初始球体数据)
if __name__ == "__main__":
    # 示例数据
    num_spheres = 10000 # 减少数量以便快速测试
    sphere_radius = 1.0
    initial_centers = np.random.rand(num_spheres, 3) * 200 - 100 # 随机分布在 [-100, 100] 范围内

    # 确保初始球体不重叠 (此处简化,实际应用中需要更复杂的初始化过程)
    # 假设initial_centers已经是非重叠的

    motion_coefficient = 0.1 # 每次移动最大半径的10%
    num_motions = 5

    print(f"Starting simulation for {num_spheres} spheres...")
    final_centers = move_spheres_optimized(initial_centers, sphere_radius, motion_coefficient, num_motions)
    print("Simulation finished.")
    # print("Final sphere centers:\n", final_centers)
代码优化点说明:
- Rmax_sq预计算: 在in_cylinder函数中,将Rmax平方后传入,避免了在每次检查时都进行平方根运算。
- cKDTree批处理查询: tree.query_ball_point(updated_centers, ..., workers=-1)语句一次性查询所有球体的潜在邻居,并利用多核并行计算,这是性能提升的关键之一。查询半径考虑了球体直径和最大移动距离,以确保能覆盖所有可能发生重叠的邻居。
- Numba加速函数: in_cylinder, generate_random_vector, euclidean_distance, any_neighbor_in_range 都被@nb.njit()装饰,它们在首次调用时会被编译成高效的机器码,大大加速了内部循环和数值计算。
- generate_random_vector安全性: 增加了对direction_norm为零的检查,防止除以零错误。
- potential_neighbors_batch的类型转换: neighbors_indices = np.array(potential_neighbors_batch[i], dtype=np.int64) 确保传入Numba函数的是NumPy数组,且数据类型明确,有助于Numba优化。
4. 总结与进一步思考
通过上述优化,包括利用cKDTree的批处理查询和多核并行能力,以及对计算密集型函数进行Numba JIT编译,我们可以将大规模无重叠球体随机移动模拟的性能提升数倍。这种方法在处理百万级球体时,能够从数小时的运行时间缩短到可接受的范围内。
关键收获:
- 向量化操作: 尽可能使用NumPy的向量化操作和库函数的批处理能力,避免显式的Python循环。
- 并行计算: 利用多核处理器进行并行计算,如cKDTree的workers参数。
- JIT编译: 对于无法完全向量化或涉及复杂逻辑的计算密集型Python函数,Numba是极佳的加速工具。
尽管这些优化带来了显著的性能提升,但对于某些极端场景(例如需要100倍甚至更高的性能提升),可能需要考虑更底层的算法或技术:
- 空间分区数据结构: 除了KDTree,还可以考虑八叉树(Octree)或网格(Grid)等更适合特定场景的空间分区结构。
- 事件驱动模拟: 对于连续时间步的模拟,事件驱动方法可以避免在每个时间步都检查所有潜在碰撞,而是只处理即将发生的事件。
- GPU加速: 使用CUDA或OpenCL等技术,将计算任务卸载到GPU上,可以进一步实现大规模并行计算。
- C/C++扩展: 将最核心、最耗时的部分用C/C++编写,并通过Python绑定(如Cython或pybind11)集成到Python项目中。
总之,性能优化是一个迭代的过程,需要根据具体的应用场景和瓶颈分析,选择最合适的工具和方法。上述优化策略为在Python中高效处理大规模物理模拟提供了一个坚实的基础。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

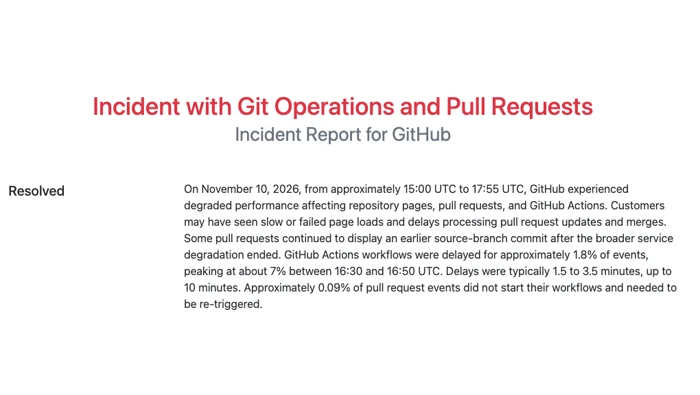
GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
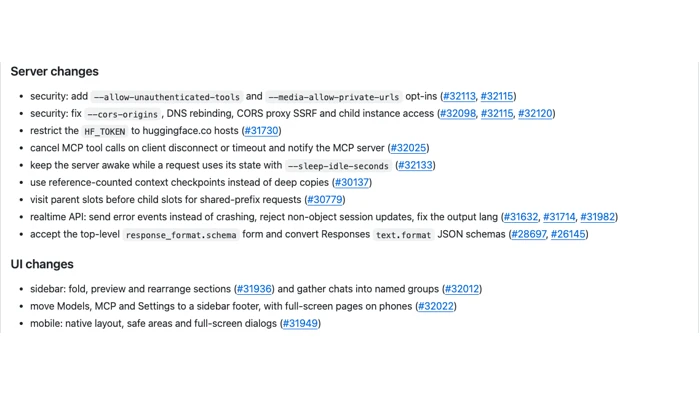
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
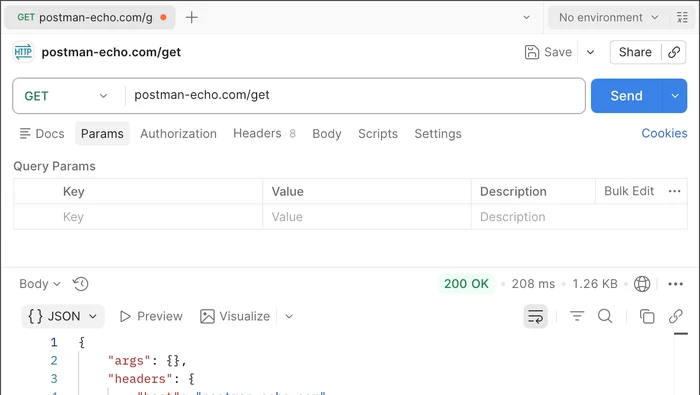
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
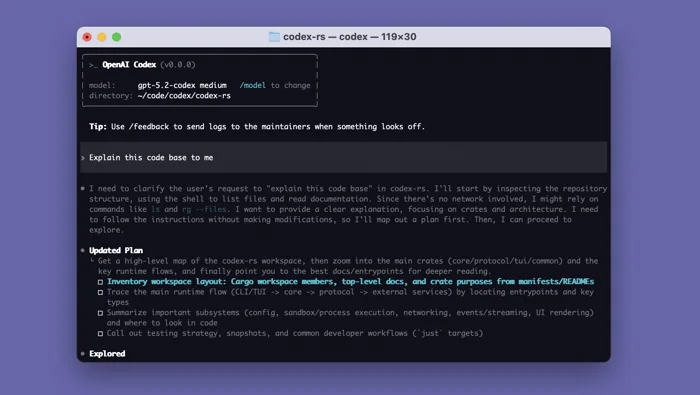
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



