

李开复公司修改张量名引发争议,官方回应来了
本站报道需要被改写的是:本站编辑部有研究者发现,李开复「零一万物」公司的Yi-34B模型基本上采用了LLaMA的架构,只是重命名了两个张量。对此,「零一万物」给出了官方回应。前段时间,开源大模型领域迎来了一个新的模型——上下文窗口大小突破200k,能一次处理40万汉字的「Yi」。这个大模型公司「零一万物」是由创新工场董事长兼CEO李开复创立的,它包括了Yi-6B和Yi-34B两个版本根据HuggingFace英文开源社区平台和C-Eval中文评测榜单,Yi-34B推出时取得了多项SOTA国际最佳性能指标认
本站报道
需要被改写的是:本站编辑部
有研究者发现,李开复「零一万物」公司的 Yi-34B 模型基本上采用了 LLaMA 的架构,只是重命名了两个张量。对此,「零一万物」给出了官方回应。
前段时间,开源大模型领域迎来了一个新的模型 —— 上下文窗口大小突破 200k,能一次处理 40 万汉字的「Yi」。
这个大模型公司「零一万物」是由创新工场董事长兼 CEO 李开复创立的,它包括了 Yi-6B 和 Yi-34B 两个版本
根据 Hugging Face 英文开源社区平台和 C-Eval 中文评测榜单,Yi-34B 推出时取得了多项 SOTA 国际最佳性能指标认可,成为全球开源大模型「双料冠军」,击败了 LLaMA2 和 Falcon 等开源竞品。
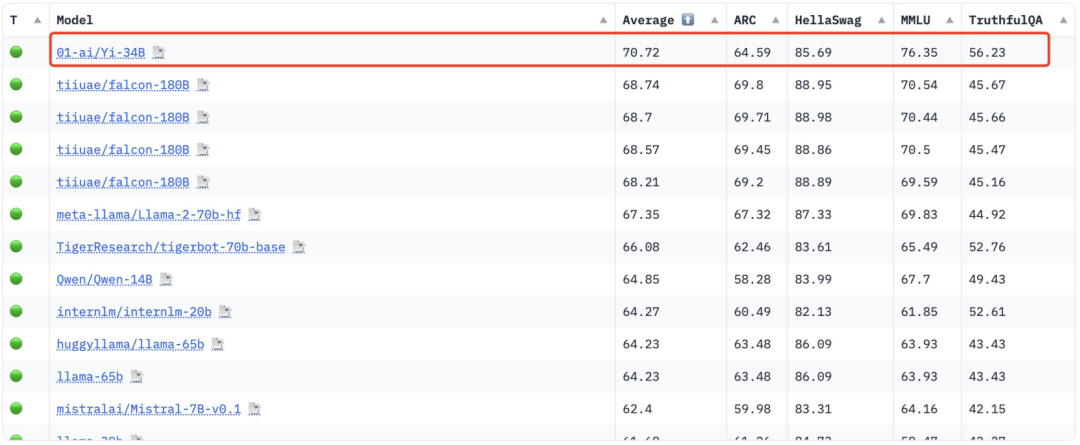
Yi-34B 也成为当时唯一成功登顶 Hugging Face 全球开源模型排行榜的国产模型,称「全球最强开源模型」。
该模型在发布后引起了国内外很多研究者、开发者的关注。
然而,近期有研究人员发现,Yi-34B 模型基本上采用了 LLaMA 的架构,只是对两个张量进行了重命名
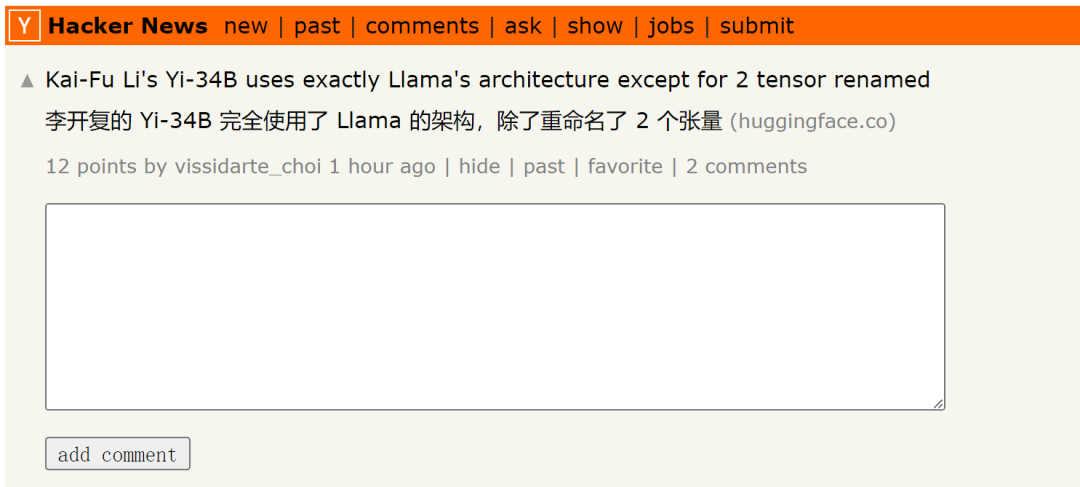
需要重新书写的是:原贴链接:https://news.ycombinator.com/item?id=38258015
这篇文章还提到:
Yi-34B 的代码实际上是对 LLaMA 代码的一次重构,但看似并未作出任何实质性改变。这个模型明显是基于原始 Apache 2.0 版的 LLaMA 文件进行的编辑,但却未提及 LLaMA:
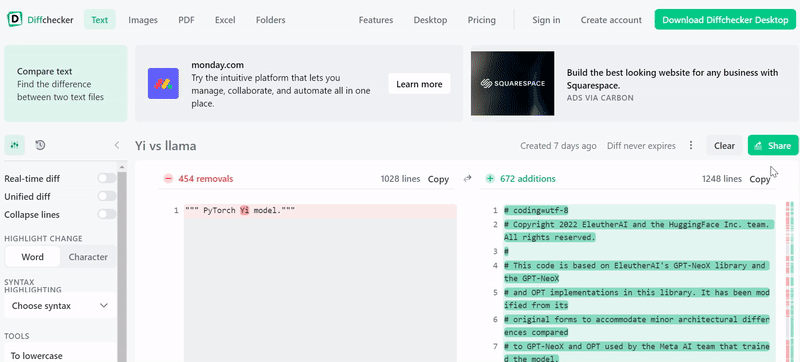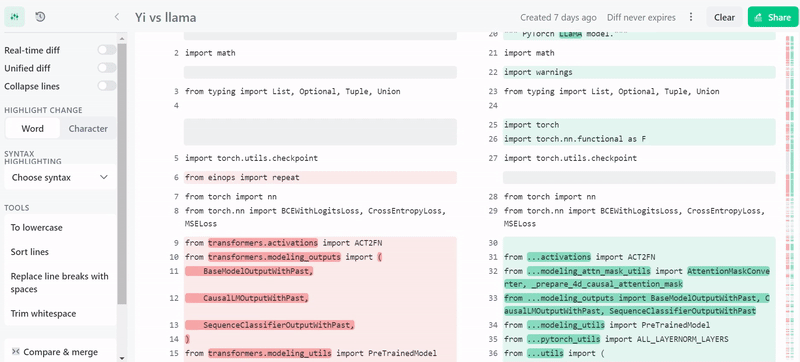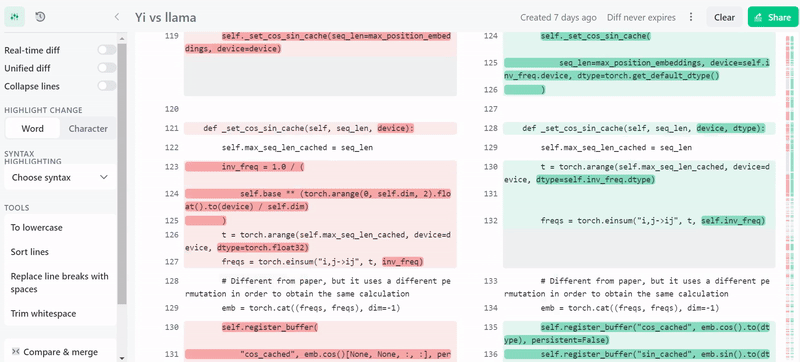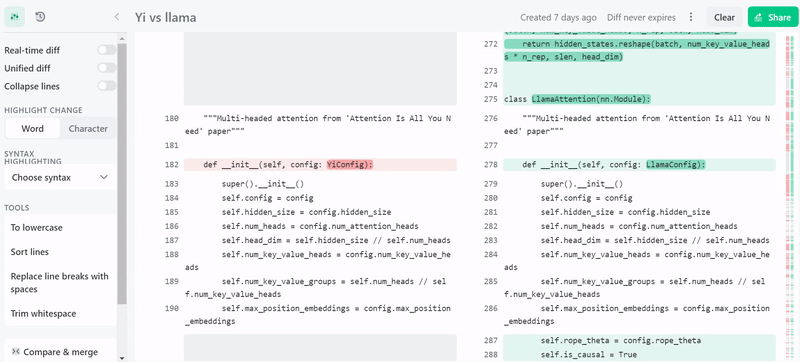
需要重写的是:Yi vs LLaMA 代码对比。代码链接:https://www.diffchecker.com/bJTqkvmQ/
此外,这些代码更改并没有通过 Pull Request 的方式提交到 transformers 项目中,而是以外部代码的形式附加上去,这可能存在安全风险或不被框架所支持。HuggingFace 排行榜甚至不会对这个上下文窗口最高可达 200K 的模型进行基准测试,因为它没有自定义代码策略。
他们声称这是 32K 模型,但它被配置为 4K 模型,没有 RoPE 伸缩配置,也没有解释如何伸缩(注:零一万物之前表示模型本身在 4K 的序列上进行训练,但是在推理阶段可以扩展到 32K)。目前,关于其微调数据的信息为零。他们也没有提供复现他们的基准测试的说明,包括可疑的 MMLU 高分。
任何一个在 AI 领域工作过一段时间的人都不会对此视而不见。这是虚假宣传?违反许可证规定?实际基准作弊?谁在乎呢?换下一篇论文,或者在这种情况下,拿走所有风险投资的钱。Yi 至少高于标准,因为它是基础模型,而且性能确实不错。
前几天,在Huggingface社区的万物之中,一位开发者也提到了同样的问题:
据我们了解,除了两个张量被重命名之外,Yi 完全使用了 LLaMA 的架构。(input_layernorm, post_attention_layernorm)
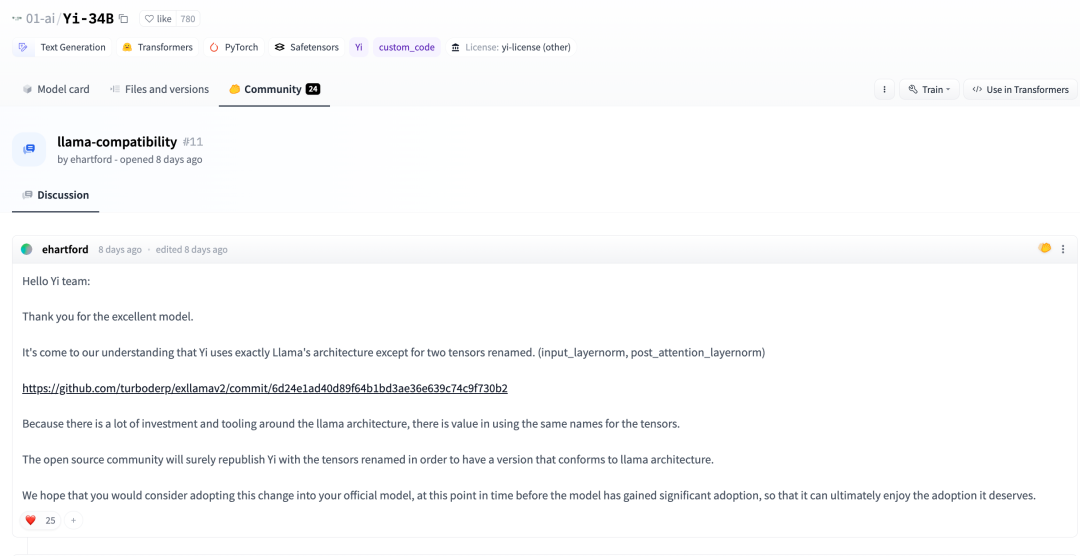
在讨论中,一些网友表示:如果他们确实使用了Meta LLaMA的架构、代码库和所有相关资源,就需要遵守LLaMA规定的许可协议
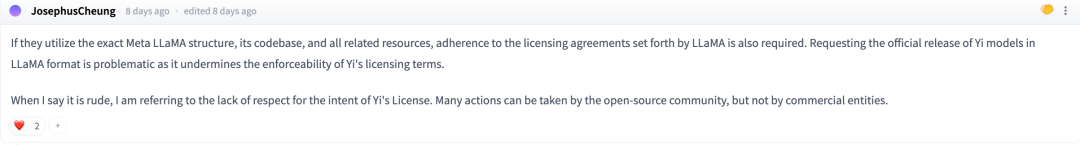
为了遵守 LLaMA 的开源协议,一位开发者将自己的名字改回并重新发布到 huggingface 上:
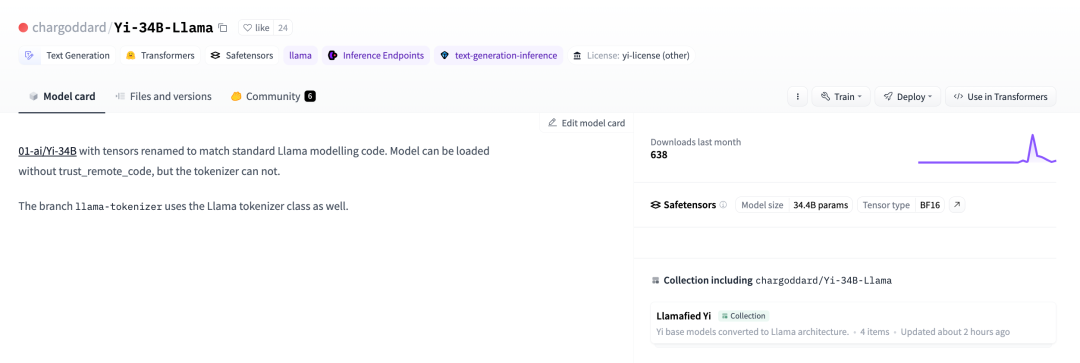 01-ai/Yi-34B,张量已重命名以匹配标准 LLaMA 模型代码。相关链接:https://huggingface.co/chargoddard/Yi-34B-LLaMA
通过阅读这段内容,我们可以推断出前几天阿里巴巴的前员工贾扬清在他的朋友圈里提到的企业是哪一家
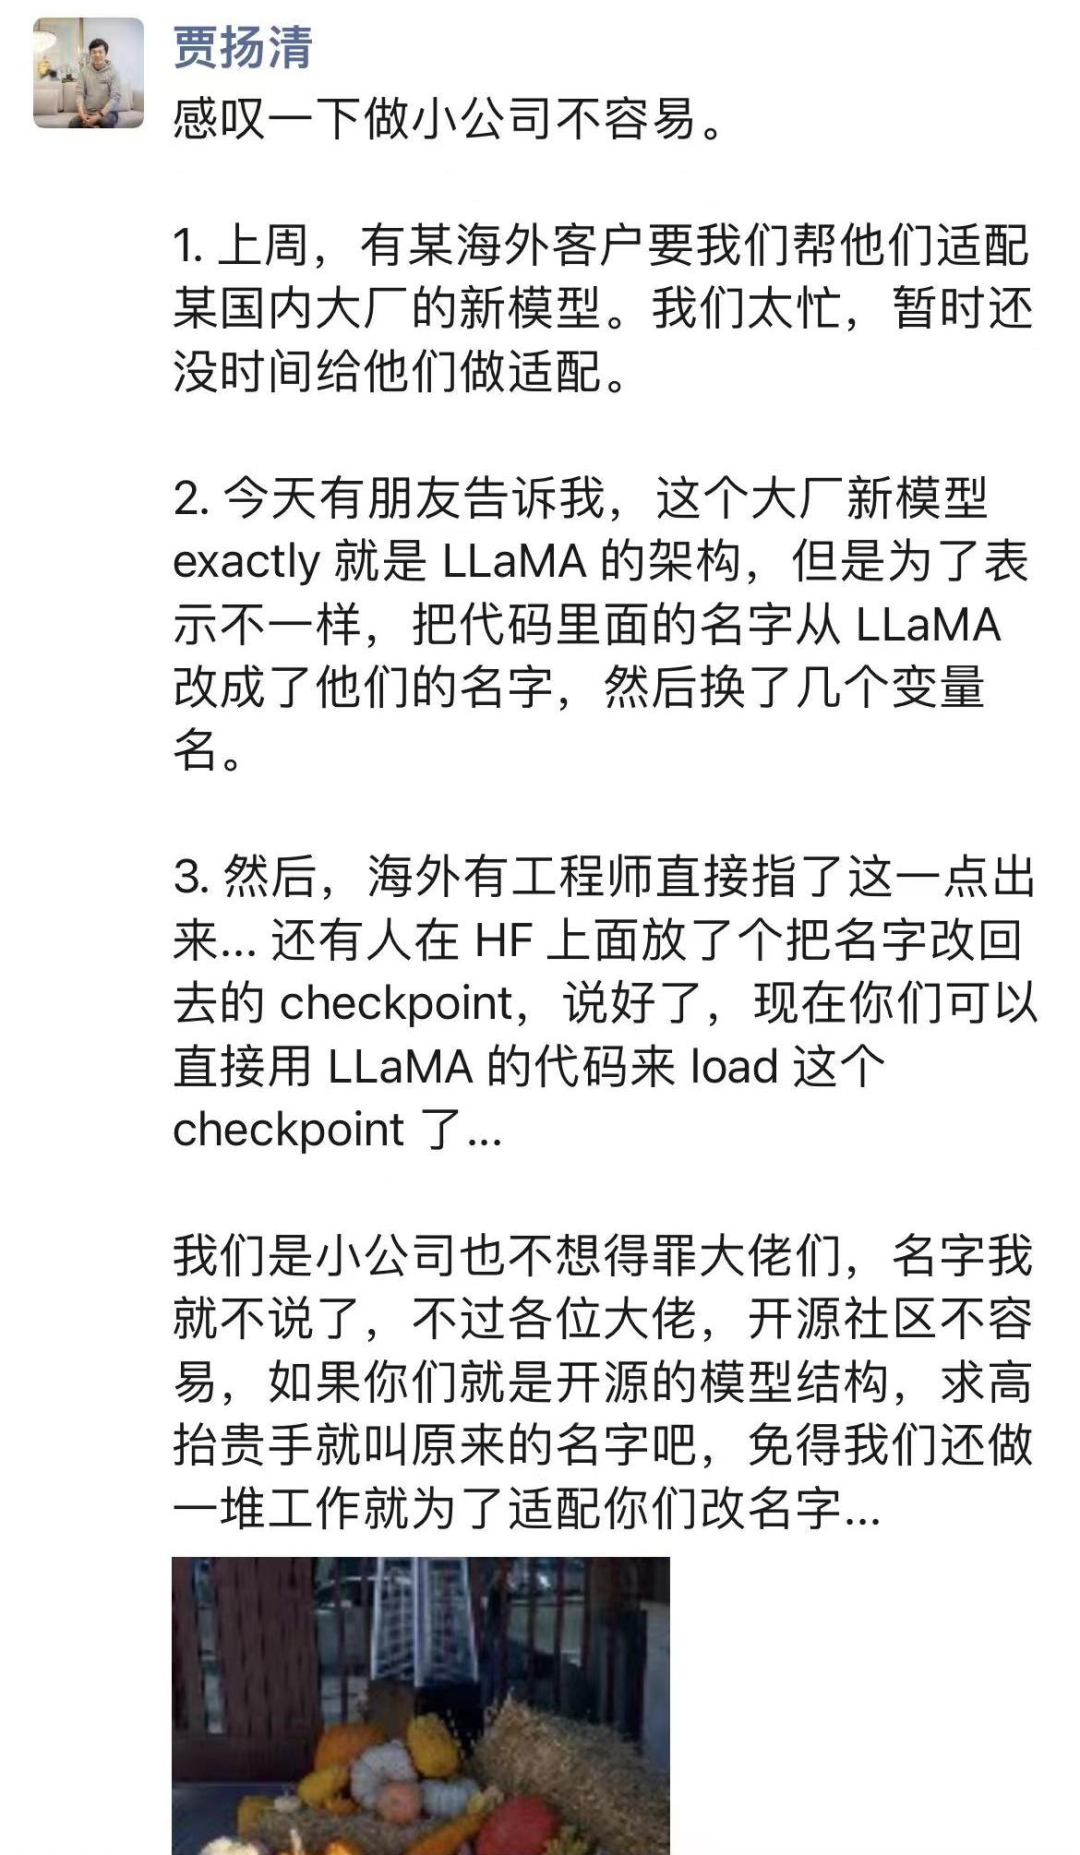
针对此事,本站也向零一万物进行了求证。零一万物回应称:
GPT 是一个业内公认的成熟架构,LLaMA 在 GPT 上做了总结。零一万物研发大模型的结构设计基于 GPT 成熟结构,借鉴了行业顶尖水平的公开成果,同时基于零一万物团队对模型和训练的理解做了大量工作,这是我们首次发布获得优秀结果的地基之一。与此同时,零一万物也在持续探索模型结构层面本质上的突破。
模型结构仅是模型训练其中一部分。Yi 开源模型在其他方面的精力,比如数据工程、训练方法、baby sitting(训练过程监测)的技巧、hyperparameter 设置、评估方法以及对评估指标的本质理解深度、对模型泛化能力的原理的研究深度、行业顶尖的 AI Infra 能力等,投入了大量研发和打底工作,这些工作往往比起基本结构能起到更大的作用跟价值,这些也是零一万物在大模型预训练阶段的核心技术护城河。
在大量训练实验过程中,由于实验执行需求对代码做了更名,我们尊重开源社区的反馈,将代码进行更新,也更好的融入 Transformer 生态。
我们非常感谢社区的反馈,我们在开源社区刚刚起步,希望和大家携手共创社区繁荣,Yi Open-source 会尽最大努力持续进步。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
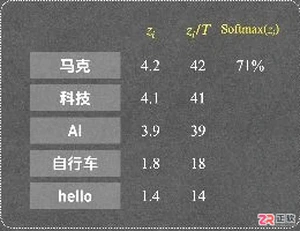
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
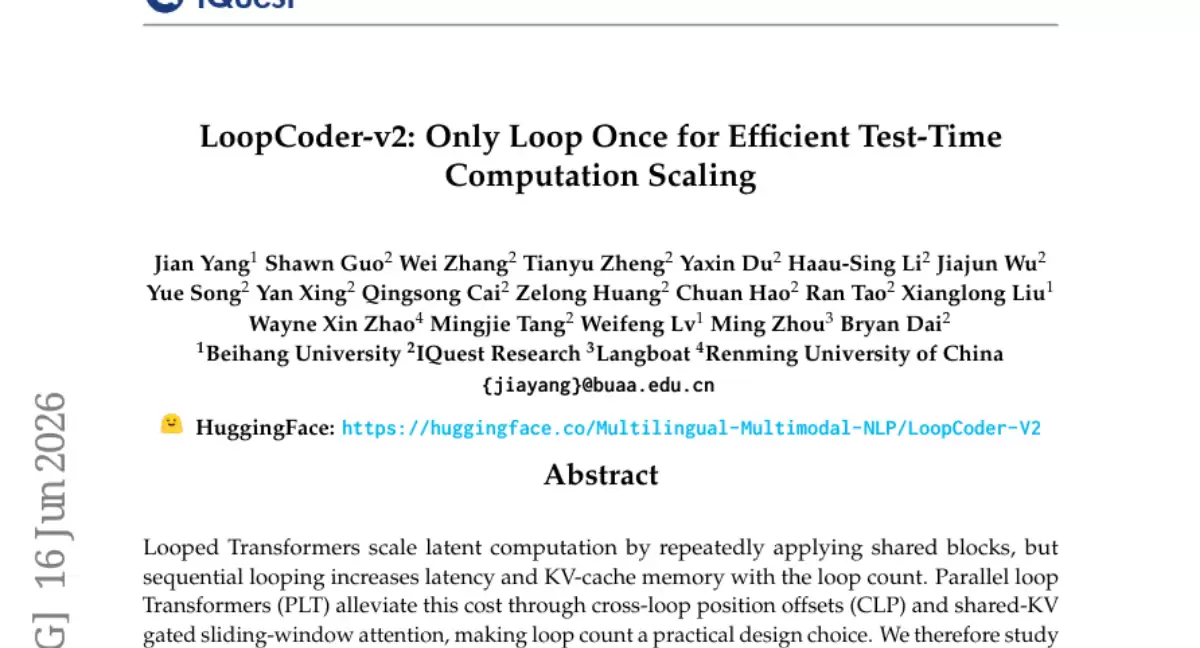
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
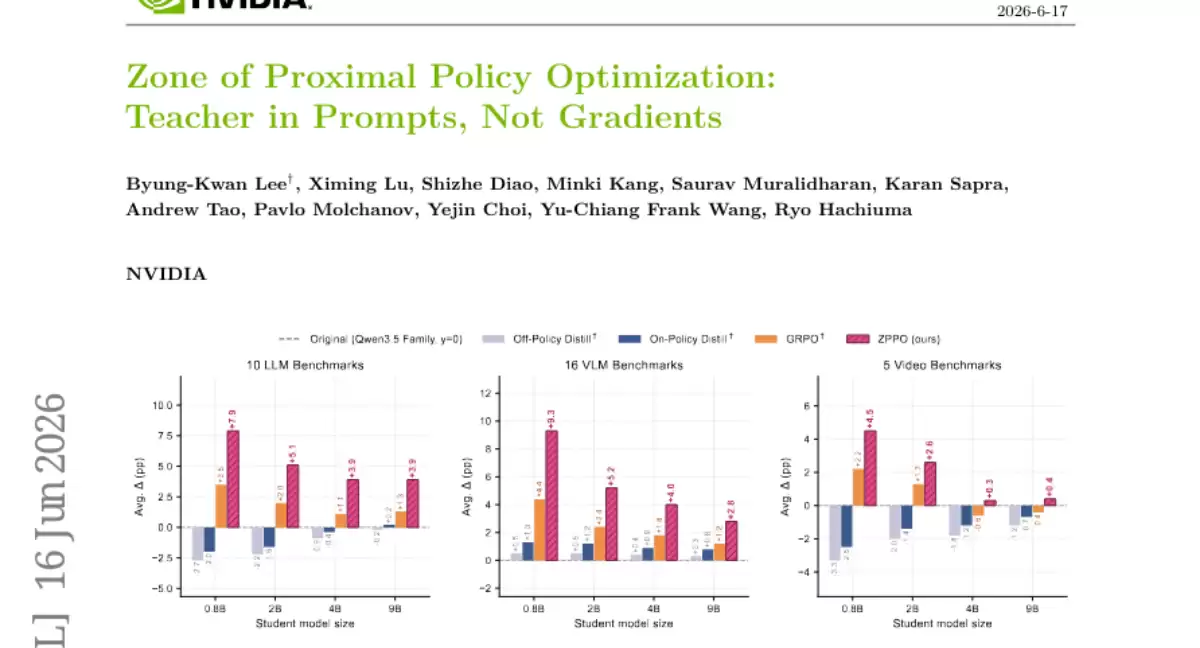
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
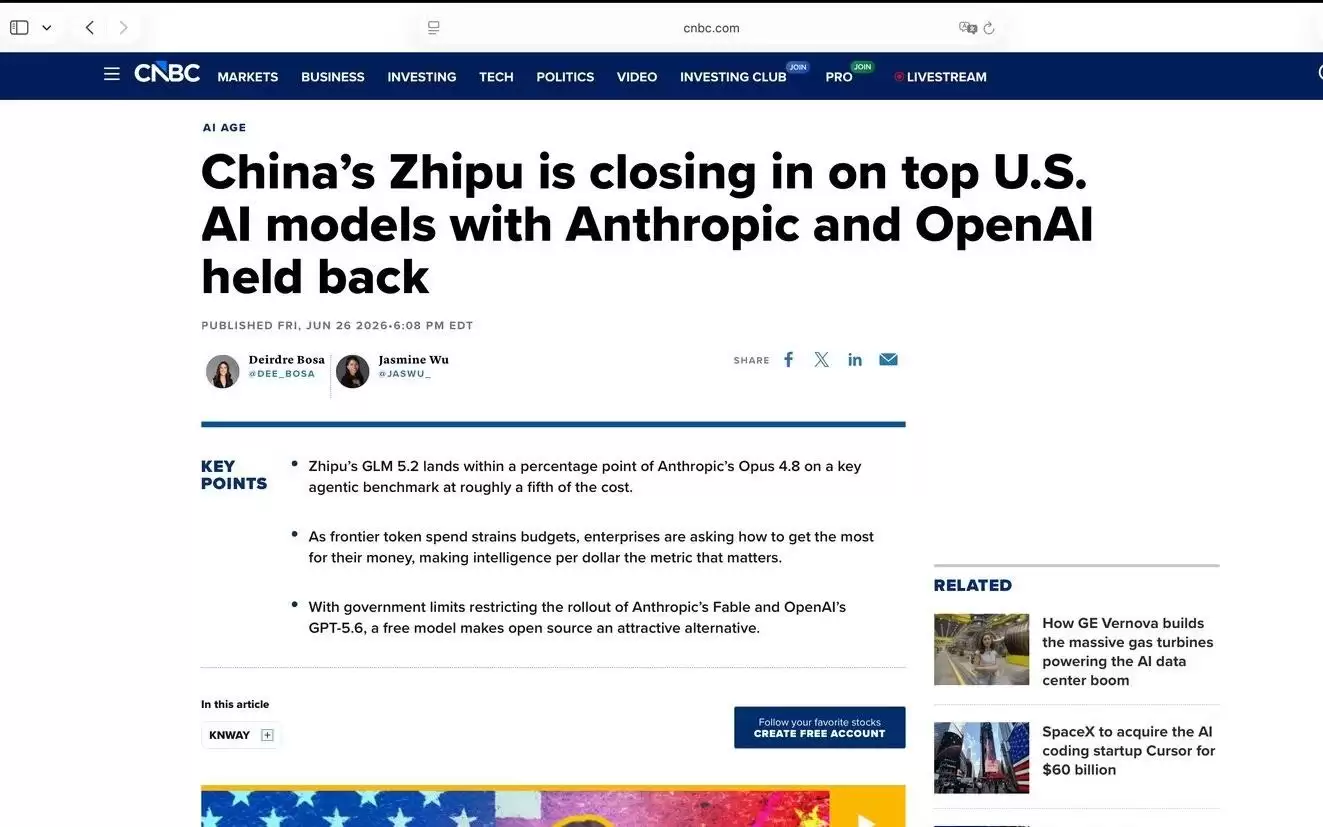
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
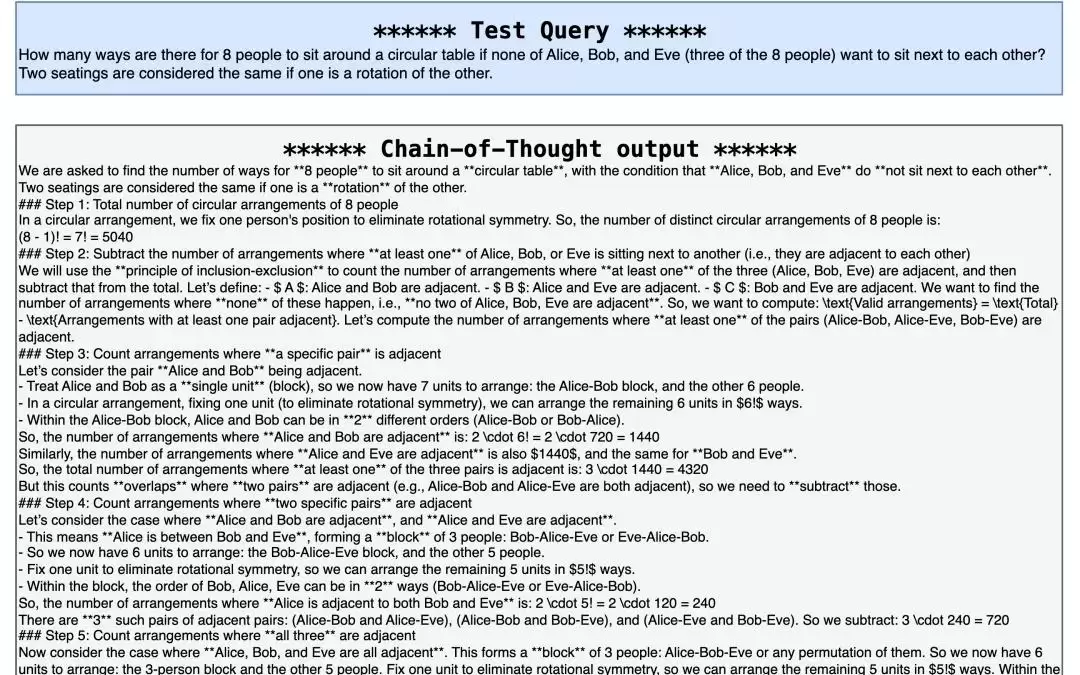
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
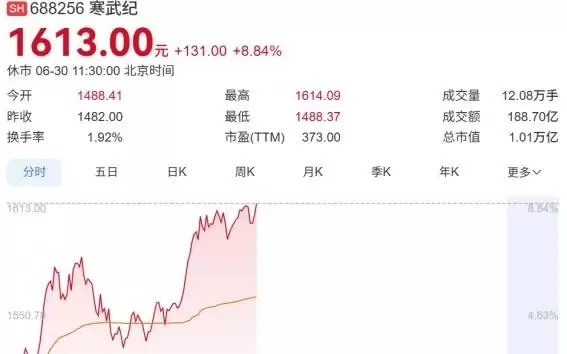
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



