

不会写代码?DeepSeek轻松实现爬虫功能
我们以抓取博客内容为例,为大家展示如何操作。#抓取标题与链接#使用Python获取我的博客中所有文章的标题及其对应链接。(需翻页处理,各页面URL规律如下:第二页为https://blog.bbskali.cn/page/2/,第三页为https://blog.bbskali.cn/page/3/,第四页为https://blog.bbskali.cn/page/4/,依此类推。)博客主地址:https://blog.bbskali.cn将最终结果导出为csv文件。文章标题的HTML结构示例如下:
我们以抓取博客内容为例,为大家展示如何操作。
#抓取标题与链接#
使用Python获取我的博客中所有文章的标题及其对应链接。(需翻页处理,各页面URL规律如下:第二页为https://blog.bbskali.cn/page/2/,第三页为 https://blog.bbskali.cn/page/3/,第四页为 https://blog.bbskali.cn/page/4/,依此类推。)博客主地址:https://blog.bbskali.cn 将最终结果导出为csv文件。文章标题的HTML结构示例如下:
Homeassistant界面美化
HAPPY TEACHER'S DAY
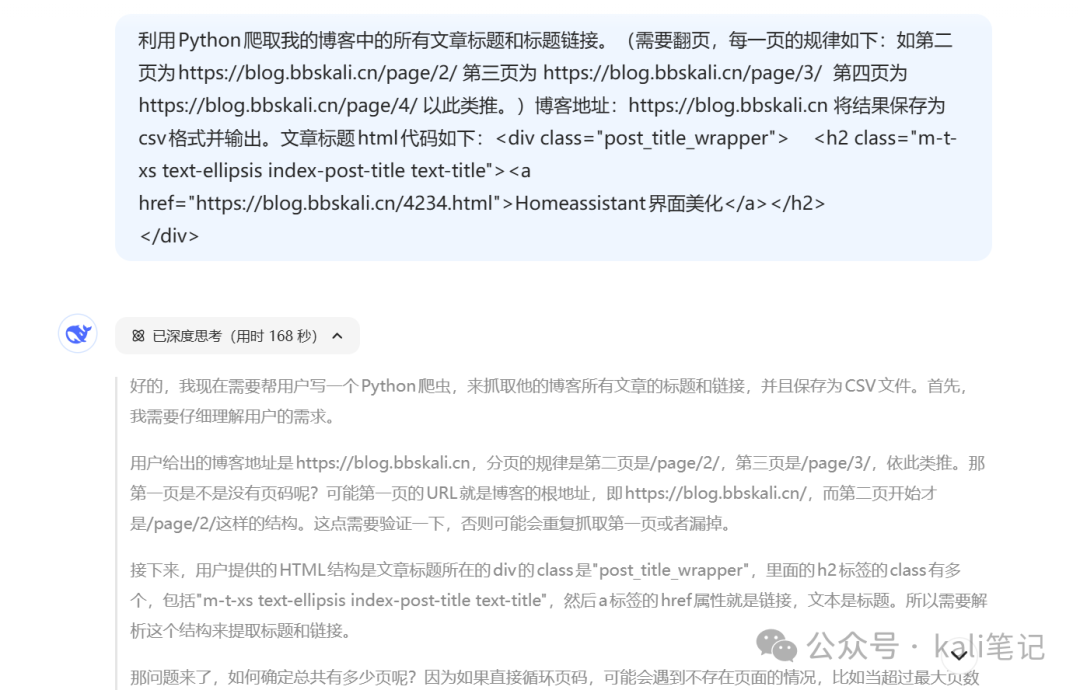 可以看到,讲解非常详细。
运行生成的代码,效果如下:
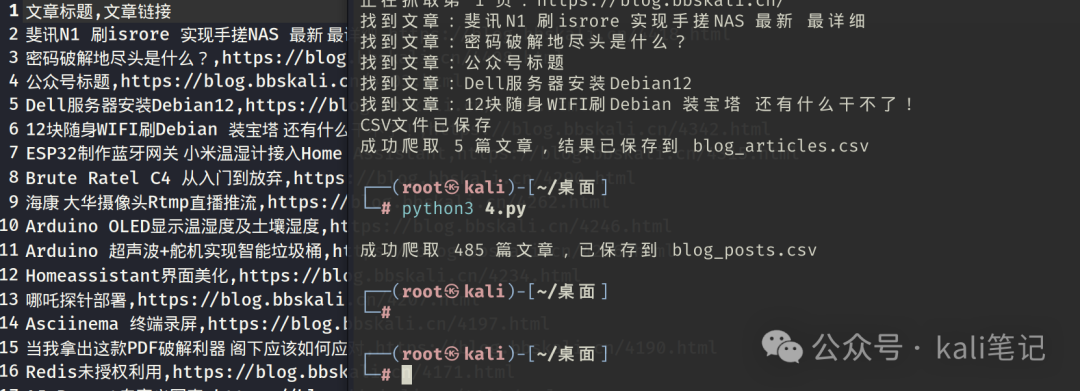 接下来,我们尝试更复杂一点的任务:提取每篇文章的阅读次数、评论数量以及发布时间。
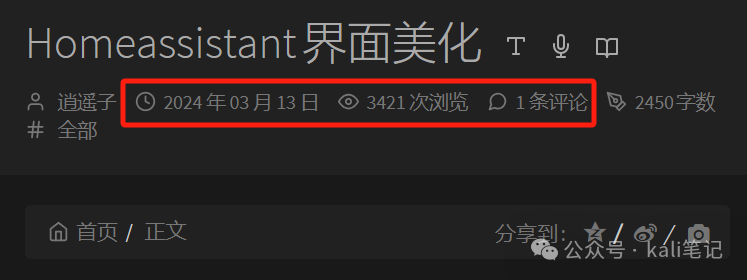 新建对话内容如下:
#抓取文章阅读量、评论数、发布日期#
很好,之前的代码已经成功获取了博客的所有标题和链接。现在我需要你进入每一篇文章的具体页面,提取其阅读量、评论数和发布时间。相关HTML代码结构如下:
HAPPY TEACHER'S DAY
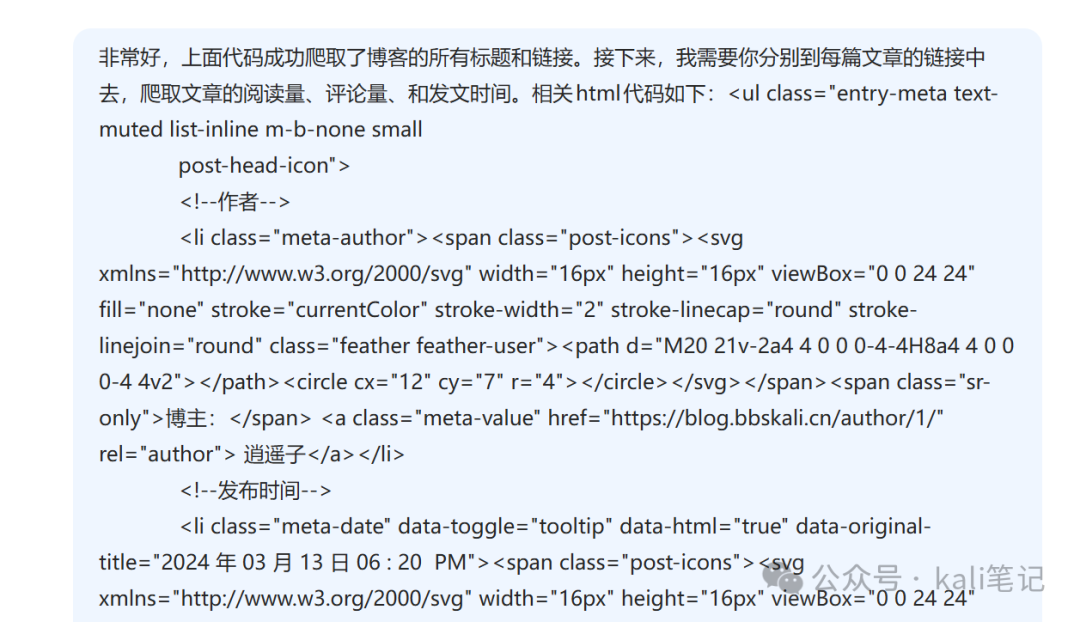
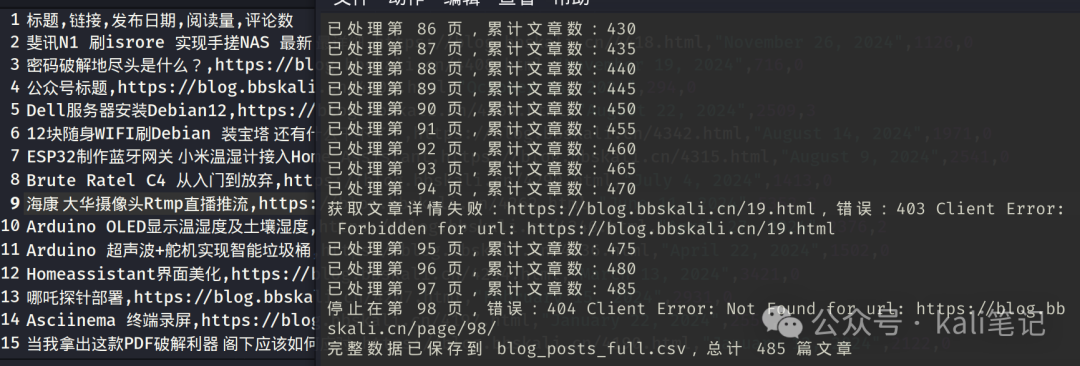 实际运行效果
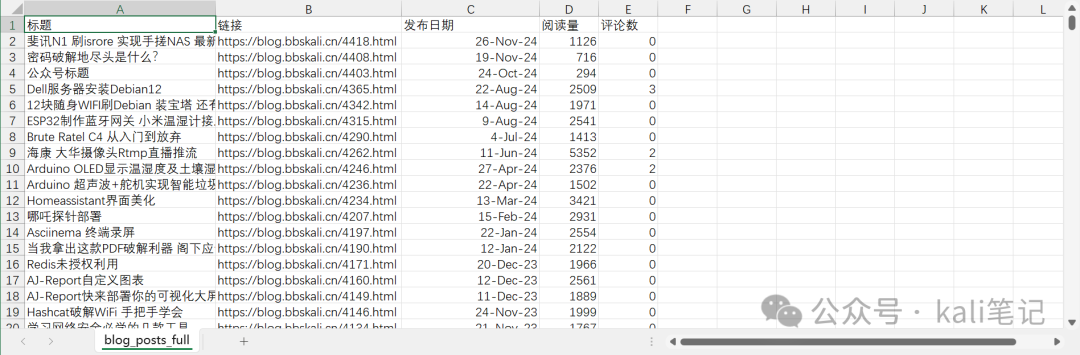 完整代码如下
import requests from bs4 import BeautifulSoup import csv import re import timedef get_post_details(url, headers): try: response = requests.get(url, headers=headers) response.raise_for_status() except Exception as e: print(f"获取文章详情失败:{url},错误:{str(e)}") return None, None, None
soup = BeautifulSoup(response.text, 'html.parser')
提取发布时间
dateli = soup.find('li', class='meta-date') post_date = date_li.find('time').text.strip() if date_li else ''
提取阅读量
viewsli = soup.find('li', class='meta-views') views = 0 if views_li: views_text = viewsli.find('span', class='meta-value').text match = re.search(r'(\d+)', views_text.replace(' ', ' ')) views = match.group(1) if match else 0
提取评论数
commentsli = soup.find('li', class='meta-comments') comments = 0 if comments_li: comments_tag = commentsli.find('a', class='meta-value') or commentsli.find('span', class='meta-value') if comments_tag: match = re.search(r'(\d+)', comments_tag.text) comments = match.group(1) if match else 0
return post_date, views, comments
def get_all_posts(): base_url = "https://blog.bbskali.cn" headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.3' }
all_data = [] page_num = 1
while True:
构造分页链接
url = f"{base_url}/page/{page_num}/" if page_num > 1 else base_url try: response = requests.get(url, headers=headers) response.raise_for_status() except Exception as e: print(f"停止在第 {page_num} 页,错误:{str(e)}") break soup = BeautifulSoup(response.text, 'html.parser') posts = soup.find_all('div', class_='post_title_wrapper') if not posts: break for post in posts: h2_tag = post.find('h2', class_='index-post-title') if not h2_tag: continue a_tag = h2_tag.find('a') if a_tag and a_tag.has_attr('href'): title = a_tag.text.strip() link = a_tag['href'] # 获取文章详细信息 post_date, views, comments = get_post_details(link, headers) # 汇总数据 all_data.append([ title, link, post_date, views, comments ]) # 添加请求间隔,避免对服务器造成压力 time.sleep(0.5) print(f"已处理第 {page_num} 页,累计文章数:{len(all_data)}") page_num += 1写入CSV文件
with open('blog_posts_full.csv', 'w', newline='', encoding='utf-8-sig') as f: writer = csv.writer(f) writer.writerow(['标题', '链接', '发布日期', '阅读量', '评论数']) writer.writerows(all_data)
return len(all_data)
if name == "main": count = get_all_posts() print(f"完整数据已保存到 blog_posts_full.csv,总计 {count} 篇文章")
示例输出
""" 已处理第 1 页,累计文章数:10 已处理第 2 页,累计文章数:20 ... 完整数据已保存到 blog_posts_full.csv,总计 56 篇文章 """
总结:
借助DeepSeek,我们可以轻松生成所需的爬虫代码。当然,前提是我们必须清晰准确地描述需求!
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
DeepSeek返回空内容时,先检查content是否只有空格,再查看finish_reason、reasoning_content、tool_calls和流式事件。JSON模式提示不完整、输出预算不足、内容过滤、工具调用未处理或SSE解析错误都可能造成“看起来为空”。
DeepSeek开启流式输出只需在API请求中设置stream=true并逐块读取SSE事件。Chat Completions以data: [DONE]结束,Responses API则以response.completed、response.incomplete或response.failed结束,两种协议不能混用同一套结束判断。
DeepSeek开启JSON模式需要在请求中设置response_format为json_object,并在系统或用户提示词中明确要求输出JSON及字段示例,同时设置足够的max_tokens。返回后仍应解析和校验字段,空白内容或截断时执行重试。
DeepSeek-V4提示词可按“目标+背景+输入+约束+输出格式+验收标准+示例”编写。先明确要完成的任务,再提供必要材料和边界,最后规定可检查的输出结构,比堆砌角色词或空泛要求“更专业”更稳定。
DeepSeek上传文件提示超限时,先确认是在App、网页还是API中上传,再检查单文件大小、格式、图片尺寸、文件数量和账号存储配额。App或网页可压缩、拆分后重传;API图片文件单个最大64 MiB,并只支持JPEG、PNG、GIF和WebP。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。
DeepSeek账号密码忘记后,可在官方登录页切换到密码登录并点击“忘记密码”,使用绑定手机号或邮箱完成身份验证,再设置新密码。通过Apple、Google或微信注册的账号应优先使用原第三方方式登录。
手机收不到DeepSeek验证码时,先核对国家区号和手机号,等待发送倒计时结束,再检查短信拦截、网络和运营商状态;仍收不到可改用密码、Apple或其他已绑定方式登录,并通过官方反馈渠道处理账号问题。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



