

Python爬虫数据处理全攻略
在Python中处理爬取数据主要使用BeautifulSoup解析HTML、json模块处理JSON和xml.etree.ElementTree解析XML。1)使用BeautifulSoup从HTML中提取标题和段落。2)用json.loads()解析JSON数据。3)用xml.etree.ElementTree从XML中提取信息。数据处理还包括清洗、转换和存储,通常使用pandas库进行操作。
在Python中处理爬取数据主要使用BeautifulSoup解析HTML、json模块处理JSON和xml.etree.ElementTree解析XML。1) 使用BeautifulSoup从HTML中提取标题和段落。2) 用json.loads()解析JSON数据。3) 用xml.etree.ElementTree从XML中提取信息。数据处理还包括清洗、转换和存储,通常使用pandas库进行操作。

在Python中处理爬取数据是一个既有趣又充满挑战的过程。我经常发现自己沉浸在数据的海洋中,试图从中挖掘出有用的信息。让我们深入探讨如何高效地处理这些数据。
处理爬取数据的核心在于理解数据的结构和性质。通常,爬取的数据可能以HTML、JSON或者XML的形式存在,因此我们需要合适的工具来解析这些数据。让我们从最常见的HTML数据开始讲起。
对于HTML数据,我喜欢使用BeautifulSoup库。它就像一个魔法棒,能够轻而易举地从混乱的HTML代码中提取出有用的信息。这里是一个简单的例子:
from bs4 import BeautifulSoup

html_content = """


        Welcome to my website
        This is a paragraph.


"""

soup = BeautifulSoup(html_content, 'html.parser')
title = soup.h1.text
paragraph = soup.p.text

print(f"Title: {title}")
print(f"Paragraph: {paragraph}")
这个例子展示了如何从HTML中提取标题和段落内容。BeautifulSoup的强大之处在于它能够处理不规则的HTML结构,这在实际爬虫项目中非常常见。
当处理JSON数据时,Python内置的json模块就派上用场了。JSON数据通常结构清晰,易于处理。假设我们有一个包含用户信息的JSON字符串,我们可以这样处理:
import json

json_data = '{"name": "John Doe", "age": 30, "city": "New York"}'
data = json.loads(json_data)

print(f"Name: {data['name']}")
print(f"Age: {data['age']}")
print(f"City: {data['city']}")
JSON数据的处理相对简单,但有时我们需要处理嵌套结构,这时就需要递归地访问数据。
XML数据的处理可以使用xml.etree.ElementTree模块。XML的结构类似于HTML,但通常更严格。以下是一个简单的XML解析示例:
import xml.etree.ElementTree as ET xml_data = """""" root = ET.fromstring(xml_data) name = root.find('person/name').text age = root.find('person/age').text print(f"Name: {name}") print(f"Age: {age}") John Doe 30
处理XML数据时,注意标签的层次结构非常重要,稍有不慎就会导致解析失败。
在实际项目中,数据处理往往不止于解析。我们需要对数据进行清洗、转换和存储。数据清洗是处理爬取数据的一个关键步骤,因为爬取的数据通常包含噪音和不完整的信息。我通常会使用pandas库来进行数据清洗和处理,因为它提供了强大的数据操作功能。假设我们已经爬取了一组网页数据,存储在一个CSV文件中,我们可以这样处理:
import pandas as pd

# 读取CSV文件
df = pd.read_csv('data.csv')

# 清洗数据
df['text'] = df['text'].str.strip()  # 去除文本两端的空白字符
df['price'] = pd.to_numeric(df['price'], errors='coerce')  # 将价格转换为数值类型

# 过滤掉无效数据
df = df.dropna(subset=['price'])  # 删除价格为空的行

# 保存处理后的数据
df.to_csv('cleaned_data.csv', index=False)
这个例子展示了如何使用pandas进行数据清洗和转换。数据清洗的过程可能会涉及到去除重复项、处理缺失值、标准化数据格式等,这些都是数据处理中的常见任务。
在处理爬取数据时,性能优化也是一个值得关注的方面。特别是当我们处理大量数据时,效率就变得至关重要。我发现使用多线程或异步编程可以显著提高数据处理的速度。让我们看一个使用asyncio库进行异步数据处理的例子:
import asyncio
import aiohttp

async def fetch_data(url):
    async with aiohttp.ClientSession() as session:
        async with session.get(url) as response:
            return await response.text()

async def main():
    urls = ['url1', 'url2', 'url3']  # 假设我们有多个URL需要爬取
    tasks = [fetch_data(url) for url in urls]
    results = await asyncio.gather(*tasks)
    for result in results:
        print(result[:100])  # 打印每个URL的前100个字符

asyncio.run(main())
这个例子展示了如何使用异步编程来并行处理多个URL的数据爬取。通过这种方式,我们可以显著减少等待时间,提高整体效率。
当然,处理爬取数据时也会遇到一些常见的挑战和陷阱。例如,处理动态加载的内容时,我们可能需要使用Selenium这样的工具来模拟浏览器行为;又如,处理反爬虫机制时,我们需要设置合适的请求头和延迟时间,以避免被封禁。
总的来说,处理爬取数据是一个多层次、多技术的过程,需要我们不断学习和实践。通过使用合适的工具和方法,我们可以从数据中提取出有价值的信息,实现各种有趣的应用。希望这些分享能对你在处理爬取数据时有所帮助,祝你在数据的海洋中畅游愉快!
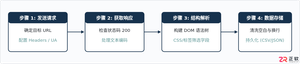
一份结构清晰、注重实操的Python爬取网页详细教程,涵盖环境搭建、HTTP请求发送、HTML解析、数据持久化存储与异常处理等完整步骤与代码实例。
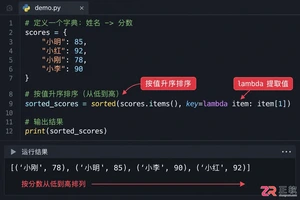
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
requests库是Python爬虫常用工具,安装命令为pipinstallrequests。通过requests.get()发送GET请求,可传入params参数添加URL参数;使用requests.post()发送POST请求,data传递表单数据,json参数发送JSON数据。可设置headers模拟浏览器访问,避免反爬。响应对象提供status_code、headers、text、content、json()等属性解析结果。结合BeautifulSoup或正则表达式提取数据,可构建完整爬虫流程,需
日志记录能提升爬虫的可维护性和调试效率,通过logging模块实现多级别信息分类、异常捕获及文件保存,结合模块化配置实现透明化运行。
答案:使用requests库可安全抓取HTTPS网站,需正确处理SSL证书验证。默认情况下requests会自动验证服务器证书,确保连接安全;若遇自签名或私有CA证书,可指定本地证书路径或谨慎关闭验证(仅限测试);结合headers、cookies和代理提升兼容性与隐蔽性;对高级需求可用urllib3或自定义SSL上下文控制TLS行为;保持库更新以支持最新安全标准。
答案:Python爬虫数据可保存为CSV、JSON、Excel或存入MySQL、MongoDB。小数据用CSV/JSON,分析选Excel,长期结构化存储用MySQL,非结构化数据选MongoDB,注意编码与异常处理。
首先使用条件格式高亮异常值,再通过公式检测离群点,接着用排序定位极值,然后利用数据透视表分析分布模式,最后启用筛选器查找空白或非法字符,系统化识别并处理Excel中的异常数据。
使用异步请求、统一解析接口、反爬策略和容错机制可高效抓取多网站数据。1.采用aiohttp+asyncio并发请求,显著提升抓取效率;2.为各站点编写独立解析函数并注册到统一映射表,实现结构化输出;3.设置请求头、频率控制、代理IP和重试机制应对反爬;4.成功数据存入数据库,失败记录日志以便重试,确保程序稳定运行。
掌握PowerQuery可高效处理数据:先通过“数据”选项卡启用并导入Excel工作表数据,进入查询编辑器进行类型转换、拆分列、删除空行等清洗操作;再通过追加或合并查询整合多表数据;最后将结果加载回Excel新工作表或数据模型,完成分析准备。
先掌握Python基础语法,再学习requests库发送请求,用BeautifulSoup解析网页,逐步应对反爬机制并实践小项目。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



