

CNN二分类模型异常排查与修复指南
本文旨在诊断并解决深度学习模型在二分类任务中出现的异常训练现象,即初始高损失后迅速收敛至零,同时伴随1.0的验证准确率。文章将深入探讨数据泄露和模型输出层与损失函数配置不当两大常见原因,并提供正确的模型构建与调试策略,以确保模型训练的有效性和结果的可靠性。

本文旨在诊断并解决深度学习模型在二分类任务中出现的异常训练现象,即初始高损失后迅速收敛至零,同时伴随1.0的验证准确率。文章将深入探讨数据泄露和模型输出层与损失函数配置不当两大常见原因,并提供正确的模型构建与调试策略,以确保模型训练的有效性和结果的可靠性。
异常现象分析
在深度学习模型训练过程中,如果观察到以下现象,通常表明存在严重配置错误或数据问题:
- 首个 epoch 损失极高,验证准确率立即达到 1.0。 例如,训练损失高达数亿,而验证损失为 0,验证准确率直接达到 100%。
- 后续 epoch 训练损失和验证损失均为 0,准确率均为 1.0。 这表明模型在训练数据上表现完美,且在验证数据上也表现完美,但这种“完美”通常是虚假的。
这些结果并非模型性能优异的体现,而是模型训练过程出现根本性错误的强烈信号。它暗示模型可能在某种程度上“作弊”或遇到了退化问题。
常见原因及解决方案
针对上述异常现象,主要有两个常见原因:数据泄露(Data Leakage)和模型输出层与损失函数配置不当。
1. 数据泄露
问题描述: 数据泄露是指在模型训练阶段,不小心将测试集或验证集中的信息“泄露”给了训练集。当模型在训练过程中接触到它本应从未见过的数据时,它会简单地“记住”这些数据及其对应的标签,从而在验证集上表现出看似完美的性能。
为什么会导致异常:
- 高初始损失: 如果训练集和测试集存在重叠,模型在学习初期可能会因为数据分布的混淆而产生极高的损失。
- 验证准确率 1.0: 模型已经“见过”验证集中的数据,因此可以轻易地对其进行正确分类,导致验证准确率立即达到 100%。
- 后续损失为 0: 模型在训练过程中完全记住了训练数据(包括泄露的验证数据),因此在后续 epoch 中能够完美预测,损失降至 0。
排查与解决:
- 严格划分数据集: 确保训练集、验证集和测试集之间没有任何重叠。在进行任何数据预处理或增强之前,应首先完成数据集的划分。
- 检查数据源: 仔细核对数据集的生成和加载逻辑,确保没有文件路径错误、复制粘贴错误或索引错误导致数据交叉。
- 随机化与重复性: 使用固定的随机种子进行数据集划分,以确保实验的可重复性,并避免因随机性导致的偶然泄露。
2. 二分类模型输出层与损失函数配置不当
问题描述: 对于二分类任务,模型输出层的激活函数和对应的损失函数有特定的推荐组合。如果配置不当,尤其是在标签编码方式不匹配时,会导致训练不稳定或结果异常。
原始模型配置分析: 在提供的模型代码中:
# ...
Dense(2, activation='softmax'), # 输出层
# ...
model.compile(
    'adam',
    loss='categorical_crossentropy', # 损失函数
    metrics=['accuracy'],
)
# ...
model.fit(
    train,
    to_categorical(train_labels), # 标签编码
    epochs=10,
    validation_data=(test, to_categorical(test_labels)),
)- Dense(2, activation='softmax'):这个输出层通常用于多分类问题,其中模型输出一个包含每个类别概率的向量(例如 [0.1, 0.9] 表示类别 1 的概率为 90%)。
- loss='categorical_crossentropy':这是与 softmax 激活函数配套使用的损失函数,要求标签为 One-Hot 编码格式(例如,类别 0 编码为 [1, 0],类别 1 编码为 [0, 1])。
- to_categorical(train_labels):此函数将整数标签转换为 One-Hot 编码,这与 Dense(2, activation='softmax') 和 categorical_crossentropy 的要求是匹配的。
尽管配置匹配,但在二分类场景下,这种组合仍可能引入不必要的复杂性或在特定边缘情况下表现不佳。更重要的是,如果标签原本是 [0] 或 [1] 这样的单一值,而没有正确转换为 One-Hot 编码,或者模型期望单一输出,就会出现问题。
推荐的二分类配置: 对于严格的二分类问题(输出 0 或 1),推荐使用以下配置:
- 输出层: Dense(1, activation='sigmoid')。sigmoid 激活函数将输出压缩到 0 到 1 之间,可以直接解释为属于正类的概率。
- 损失函数: loss='binary_crossentropy'。这是专门为二分类问题设计的损失函数,与 sigmoid 激活函数配合使用。
- 标签编码: 标签应为单一的整数值(0 或 1),而不是 One-Hot 编码。
修正后的模型示例:
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Conv2D, MaxPooling2D, Dropout, Flatten, Dense
# from tensorflow.keras.utils import to_categorical # 修正后不再需要

# 假设 input_shape, num_filters, filter_size, pool_size 已定义
num_filters = 8
filter_size = 3
pool_size = 2
input_shape = (724, 150, 1) # 示例输入形状

model = Sequential([
    Conv2D(num_filters, filter_size, activation='relu', input_shape=input_shape),
    Conv2D(num_filters, filter_size, activation='relu'),
    MaxPooling2D(pool_size=pool_size),
    Dropout(0.5),
    Flatten(),
    Dense(64, activation='relu'),
    # 修正:二分类任务使用 Dense(1, 'sigmoid')
    Dense(1, activation='sigmoid'),
])

# 编译模型
model.compile(
    optimizer='adam',
    # 修正:二分类任务使用 binary_crossentropy
    loss='binary_crossentropy',
    metrics=['accuracy'],
)

# 假设 train, train_labels, test, test_labels 已加载
# 修正:train_labels 和 test_labels 应为 (num_samples,) 形状的整数数组 (0 或 1)
# 不再需要 to_categorical
# model.fit(
#     train,
#     train_labels, # 直接使用原始的 0 或 1 标签
#     epochs=10,
#     validation_data=(test, test_labels), # 直接使用原始的 0 或 1 标签
# )
注意事项:
- 如果模型输出层仍保持 Dense(2, activation='softmax'),但希望使用 binary_crossentropy,这是不兼容的。softmax 旨在输出概率分布,binary_crossentropy 期望单一概率值。
- 如果坚持使用 Dense(2, activation='softmax'),那么标签必须是 One-Hot 编码,且损失函数必须是 categorical_crossentropy。但对于简单的二分类,这通常是过度复杂的,且可能在内部计算上效率较低。
调试与最佳实践
- 从简单开始: 尝试用一个极小的子集数据(例如,10张训练图片,2张验证图片)来训练模型。如果模型能在这个小数据集上过拟合(即训练损失迅速下降,训练准确率接近100%),说明模型架构本身是可学习的。
- 检查数据预处理: 确保图像数据被正确归一化(例如,像素值缩放到 0-1 范围),并且标签与模型输出层的期望格式完全匹配。
- 逐步增加复杂性: 确认模型能在小数据集上工作后,逐步增加训练数据量和模型复杂度。
- 监控多项指标: 除了准确率和损失,还可以监控精确率(Precision)、召回率(Recall)和 F1 分数,特别是在类别不平衡的数据集中,这些指标能提供更全面的模型性能视图。
- 可视化数据: 随机抽样一些图像和它们的标签,手动检查它们是否正确加载和标记。
- 检查数据类型: 确保输入数据和标签的数据类型(例如,float32 for images, int32 for labels)与模型框架的要求一致。
总结
当深度学习模型在训练初期表现出极高的损失和立即达到 1.0 的验证准确率时,这通常是数据泄露或模型配置错误的信号。首先应严格检查数据集划分,确保训练、验证、测试集无重叠。其次,对于二分类任务,推荐使用 Dense(1, activation='sigmoid') 作为输出层,并配合 binary_crossentropy 作为损失函数,同时确保标签为单一的 0 或 1 整数。遵循这些调试步骤和最佳实践,可以有效诊断并解决模型训练中的常见异常,确保模型的可靠性和有效性。
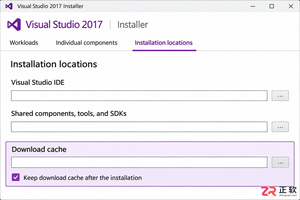
解决Visual Studio 2017安装报错“磁盘空间不足”的实用指南。涵盖检查多盘空间占用、安全清理临时文件、精简工作负载选择以及调整缓存和共享组件安装路径等步骤,帮助开发者在不破坏环境的前提下顺利完成安装。
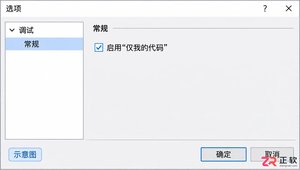
在 Visual Studio 2019 调试过程中,若希望跳过系统库代码而专注于用户代码,可通过“工具”->“选项”->“调试”->“常规”启用“仅我的代码”。本文详解该设置的开启方法、对调用堆栈的影响以及何时需要临时关闭该选项以排查底层问题。
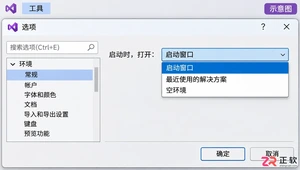
Visual Studio 2022 默认会在启动时自动恢复上次关闭时的解决方案,这在频繁切换项目或临时查看代码时可能造成干扰。本文将指导你如何通过“工具 > 选项”菜单,将启动行为更改为显示启动窗口或空环境,帮助你掌握启动主动权,同时澄清该设置与“启动项目”及最近文件记录的区别。

解析六个GitHub AI开源项目的具体用途,包括软件静态分析、智能体回答检查、多语言配音、求职材料生成、本地代码检索及动态歌词展示,帮助开发者根据实际需求筛选工具并正确验证结果。

遇到OpenCode Skills无法加载或配置无效?本文手把手教你完成Skills的安装、环境变量设置及本地调试,避开常见坑点,让AI助手更懂你的代码习惯。

解决 Visual Studio 2022 编辑时不显示代码分析警告的问题。指南涵盖 .NET 项目实时分析设置、Roslyn 分析器范围调整及错误列表来源筛选,确保开发者能高效利用实时代码诊断功能。

详解 Visual Studio 2022 调试技巧:包括断点设置、监视窗口开启方法、变量添加步骤以及通过 F10 单步执行观察变量值变化的全过程。

针对 Visual Studio 2017 缺乏全局默认编码选项的情况,详解如何利用 .editorconfig 设定项目级 UTF-8 无 BOM 规则,以及手动转换现有文件并校验字节的方法。

解决 Visual Studio 2022 F5 调试报错问题,通过设置启动项目、检查解决方案属性及正确区分类库与应用项目,快速恢复调试功能。

解决Visual Studio 2022离线环境中NuGet包还原失败的难题,涵盖依赖链分析、本地源配置、包集收集及隔离验证步骤,帮助开发者构建稳定的离线开发环境。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



