

最少分组数实现数组转换
本文探讨了如何通过最少切割次数将一个具有唯一值的输入数组转换为另一个目标数组。核心思想是利用目标数组的元素索引映射,然后遍历输入数组,识别其中连续且顺序正确的元素序列。通过这种方法,我们可以精确计算出需要切割的最小分组数量,从而实现数组的重新排列。

本文探讨了如何通过最少切割次数将一个具有唯一值的输入数组转换为另一个目标数组。核心思想是利用目标数组的元素索引映射,然后遍历输入数组,识别其中连续且顺序正确的元素序列。通过这种方法,我们可以精确计算出需要切割的最小分组数量,从而实现数组的重新排列。
问题定义
给定两个长度相同、元素均为唯一整数的数组,例如 arr1 = [1, 4, 3, 2] 和 arr2 = [1, 2, 4, 3]。我们的目标是将 arr1 切割成最少数量的连续子数组(即“块”),然后通过重新排列这些块来形成 arr2。
例如,对于 arr1 = [1, 4, 3, 2] 和 arr2 = [1, 2, 4, 3]: 我们可以将 arr1 切割为 (1), (4,3), (2) 三个块。 然后重新排列这些块为 (1), (2), (4,3),即可得到 arr2。 因此,所需的最小分组数为 3。
约束条件:
- 数组中的所有值都是唯一的。
- 两个数组的大小相同,最大可达1000。
- 数组中的值均为整数。
错误尝试分析
一种直观但错误的尝试是简单地计算两个数组在相同位置上不匹配元素的数量:
public int process(int[] inp, int[] desired) {
   int ans = 0;
   for (int i = 0; i < inp.length; i++) {
      if (inp[i] != desired[i]) ans++;
   }
   return ans;
}
这种方法的问题在于,它只统计了元素位置上的差异,而没有考虑元素的相对顺序以及通过切割和重排可以形成的连续块。例如,[1,4,3,2] 和 [1,2,4,3],在索引1处 4 != 2,索引2处 3 != 4,索引3处 2 != 3,会得到 3。但对于 [1,2,3] 和 [3,2,1],会得到 3,而实际答案是 3 ((3), (2), (1))。对于 [1,3,2] 和 [1,2,3],会得到 2,实际答案是 2 ((1), (3,2) -> (1), (2), (3) 错误,应该是 (1), (3), (2) 得到 3。正确的切割是 (1), (3,2) -> (1), (2), (3) 无法得到。正确切割是 (1), (3), (2),答案是 3。)。显然,这种基于逐个位置比较的方法无法捕捉到通过重排连续块来最小化切割数的本质。
核心算法与实现
解决此问题的关键在于理解“连续块”的定义。如果 arr1 中的两个相邻元素在 arr2 中也是相邻且顺序正确的,那么它们就可以被视为同一个块的一部分。我们需要做的就是找出 arr1 中有多少次这种“连续性”被打破。
算法步骤:
- 建立目标数组索引映射: 由于数组元素唯一,我们可以创建一个映射(Map),将 arr2 中的每个元素与其在 arr2 中的索引关联起来。这个映射将帮助我们快速查找 arr1 中元素在 arr2 中的期望位置。
- 遍历输入数组并识别连续块:
- 初始化一个计数器 count 为 1,表示至少有一个块。
- 获取 arr1 的第一个元素在 arr2 中的索引,并将其存储为 prevIndex。
- 从 arr1 的第二个元素开始遍历:
- 对于当前元素,查找它在 arr2 中的索引,并将其存储为 nextIndex。
- 如果 nextIndex 等于 prevIndex + 1,这意味着当前元素在 arr2 中紧接着前一个元素,它们属于同一个连续块。此时,更新 prevIndex = nextIndex。
- 如果 nextIndex 不等于 prevIndex + 1,这意味着当前元素打破了与前一个元素的连续性,形成了一个新的块。此时,将 count 增加 1,并更新 prevIndex = nextIndex。
- 返回 count: 最终的 count 值即为所需的最小分组数。
Java 实现示例:
import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;
import java.util.stream.IntStream;

public class ArrayGroupConverter {

    /**
     * 计算将 arr1 转换为 arr2 所需的最小分组数。
     *
     * @param arr1 输入数组
     * @param arr2 目标数组
     * @return 最小分组数
     */
    public static int process(int[] arr1, int[] arr2) {
        // 1. 建立目标数组 arr2 的元素到索引的映射
        Map indexByValue = mapIndices(arr2);

        // 至少有一个分组
        int count = 1;

        // 获取 arr1 第一个元素在 arr2 中的索引
        int prevIndex = indexByValue.get(arr1[0]);

        // 从 arr1 的第二个元素开始遍历
        for (int i = 1; i < arr1.length; i++) {
            // 获取当前 arr1 元素在 arr2 中的索引
            int nextIndex = indexByValue.get(arr1[i]);

            // 如果当前元素在 arr2 中的索引紧接着前一个元素,则它们属于同一块
            if (nextIndex == prevIndex + 1) {
                prevIndex++; // 移动 prevIndex 到当前元素的索引
            } else {
                // 否则,连续性被打破,需要一个新的块
                prevIndex = nextIndex; // 更新 prevIndex 为新块的起始索引
                count++;               // 增加分组计数
            }
        }

        return count;
    }

    /**
     * 将数组元素映射到其索引。
     *
     * @param arr 需要映射的数组
     * @return 元素到索引的映射
     */
    public static Map mapIndices(int[] arr) {
        return IntStream.range(0, arr.length)
            .boxed()
            .collect(Collectors.toMap(
                i -> arr[i],       // 键是数组元素的值
                Function.identity() // 值是元素的索引
            ));
    }

    public static void main(String[] args) {
        // 示例测试
        int[] arr1 = {1, 4, 3, 2};
        int[] arr2 = {1, 2, 4, 3};
        System.out.println("Input arr1: " + java.util.Arrays.toString(arr1));
        System.out.println("Desired arr2: " + java.util.Arrays.toString(arr2));
        System.out.println("Minimum number of groups: " + process(arr1, arr2)); // 预期输出: 3

        int[] arr3 = {1, 2, 3};
        int[] arr4 = {1, 2, 3};
        System.out.println("\nInput arr1: " + java.util.Arrays.toString(arr3));
        System.out.println("Desired arr2: " + java.util.Arrays.toString(arr4));
        System.out.println("Minimum number of groups: " + process(arr3, arr4)); // 预期输出: 1

        int[] arr5 = {3, 2, 1};
        int[] arr6 = {1, 2, 3};
        System.out.println("\nInput arr1: " + java.util.Arrays.toString(arr5));
        System.out.println("Desired arr2: " + java.util.Arrays.toString(arr6));
        System.out.println("Minimum number of groups: " + process(arr5, arr6)); // 预期输出: 3
    }
}
示例运行与输出:
对于 arr1 = [1, 4, 3, 2] 和 arr2 = [1, 2, 4, 3]:
- mapIndices(arr2) 会生成 {1:0, 2:1, 4:2, 3:3}。
- count = 1。
- prevIndex = indexByValue.get(arr1[0]) = indexByValue.get(1) = 0。
- i = 1 (arr1[1] = 4):
- nextIndex = indexByValue.get(4) = 2。
- nextIndex (2) 不等于 prevIndex (0) + 1。
- prevIndex = 2,count = 2。 (此时识别出 (1) 为一个块,(4 为新块的开始)
- i = 2 (arr1[2] = 3):
- nextIndex = indexByValue.get(3) = 3。
- nextIndex (3) 等于 prevIndex (2) + 1。
- prevIndex = 3。 (此时 (4,3) 构成一个块)
- i = 3 (arr1[3] = 2):
- nextIndex = indexByValue.get(2) = 1。
- nextIndex (1) 不等于 prevIndex (3) + 1。
- prevIndex = 1,count = 3。 (此时 (4,3) 为一个块,(2) 为新块的开始)
最终返回 count = 3。
Input arr1: [1, 4, 3, 2]
Desired arr2: [1, 2, 4, 3]
Minimum number of groups: 3

Input arr1: [1, 2, 3]
Desired arr2: [1, 2, 3]
Minimum number of groups: 1

Input arr1: [3, 2, 1]
Desired arr2: [1, 2, 3]
Minimum number of groups: 3
注意事项与总结
- 唯一性是关键: 数组元素必须是唯一的,这样才能确保 mapIndices 正确地将每个元素映射到唯一的索引。如果存在重复元素,此方法将失效。
- 时间复杂度:
- 构建映射:O(N),其中 N 是数组长度。
- 遍历输入数组:O(N)。
- 总时间复杂度为 O(N),效率较高。
- 空间复杂度:
- 存储映射:O(N),用于存储 N 个元素的索引。
- 算法本质: 该算法实际上是在寻找 arr1 中有多少个“断点”,这些断点使得 arr1 中的相邻元素在 arr2 中不再是顺序连续的。每个断点都意味着需要开始一个新的切割块。起始的第一个块也算一个,所以初始化 count 为 1。
通过上述方法,我们能够高效且准确地计算出将一个数组通过切割和重排转换为另一个目标数组所需的最小分组数,这在处理序列重排或优化操作时具有实际应用价值。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
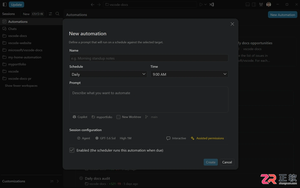
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
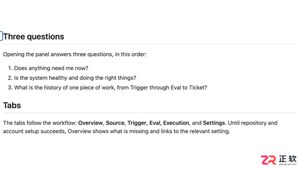
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
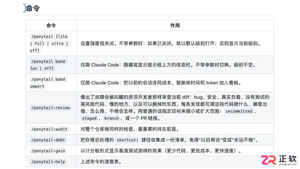
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
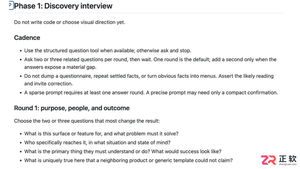
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
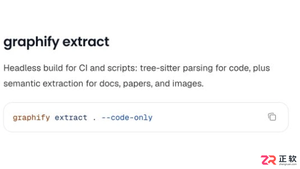
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
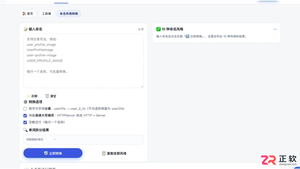
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
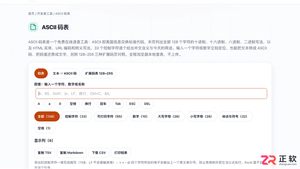
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



