

谷歌:LLM找不到推理错误,但能纠正它
今年,大型语言模型(LLM)成为人工智能领域备受关注的焦点。LLM在各种自然语言处理(NLP)任务上取得了显著的进展,尤其在推理方面的突破令人惊叹。然而,在复杂的推理任务上,LLM的表现仍然有待提高LLM能否判断出自己的推理存在错误?最近,剑桥大学和GoogleResearch联合开展的一项研究发现:LLM无法自行发现推理错误,但却能够使用该研究提出的回溯方法来修正错误论文地址:https://arxiv.org/pdf/2311.08516.pdf数据集地址:https://github.com/WHG
今年,大型语言模型(LLM)成为人工智能领域备受关注的焦点。LLM 在各种自然语言处理(NLP)任务上取得了显著的进展,尤其在推理方面的突破令人惊叹。然而,在复杂的推理任务上,LLM 的表现仍然有待提高
LLM 能否判断出自己的推理存在错误?最近,剑桥大学和 Google Research 联合开展的一项研究发现:LLM 无法自行发现推理错误,但却能够使用该研究提出的回溯方法来修正错误
- 论文地址:https://arxiv.org/pdf/2311.08516.pdf
- 数据集地址:https://github.com/WHGTyen/BIG-Bench-Mistake
这篇论文引发了一些争议,有人对此提出异议。例如,在Hacker News上,有人评论说论文的标题夸大其词,有点标题党的味道。还有人批评论文中提出的纠错逻辑错误的方法是基于模式匹配,而不是采用逻辑方法,这种方法容易失败
Huang 等人在论文《Large language models cannot self-correct reasoning yet》中指出:自我校正或许是能有效地提升模型输出的风格和质量,但鲜有证据表明 LLM 有能力在没有外部反馈的情况下识别和纠正自身的推理和逻辑错误。比如 Reflexion 和 RCI 都使用了基本真值的纠正结果作为停止自我校正循环的信号。
剑桥大学和Google Research的研究团队提出了一种全新的思路:将自我校正过程分为错误发现和输出校正两个阶段
- 错误发现是一种基础推理技能,已经在哲学、心理学和数学领域得到了广泛的研究和应用,并催生了批判性思维、逻辑和数学谬误等概念。我们可以合理地认为发现错误的能力也应该是 对 LLM 的一项重要要求。但是,本文结果表明:当前最佳的 LLM 目前还无法可靠地发现错误。
- 输出校正涉及部分或完全修改之前生成的输出。自我校正是指由生成输出的同一模型来完成校正。尽管 LLM 没有发现错误的能力,但本文表明:如果能提供有关错误的信息(如通过一个小型的监督式奖励模型),LLM 可以使用回溯方法校正输出。
本文的主要贡献包括:
- 使用思维链 prompt 设计方法,任何任务都可以变成错误发现任务。研究者为此收集并发布了一个 CoT 类型的轨迹信息数据集 BIG-Bench Mistake,该数据集由 PaLM 生成,并标注了第一个逻辑错误的位置。研究者表示,BIG-Bench Mistake 在它的同类数据集中,是首个不局限于数学问题的数据集。
- 为了测试当前最佳 LLM 的推理能力,研究者基于新数据集对它们进行了基准评测。结果发现,当前 SOTA LLM 也难以发现错误,即便是客观的明确的错误。他们猜测:LLM 无法发现错误是 LLM 无法自我校正推理错误的主要原因,但这方面还有待进一步研究。
- 本文提出使用回溯方法来校正输出,利用错误的位置信息来提升在原始任务上的性能。研究表明这种方法可以校正原本错误的输出,同时对原本正确的输出影响极小。
- 本文将回溯方法解释成了「言语强化学习」的一种形式,从而可实现对 CoT 输出的迭代式提升,而无需任何权重更新。研究者提出,可以通过一个经过训练的分类器作为奖励模型来使用回溯,他们也通过实验证明了在不同奖励模型准确度下回溯的有效性。
BIG-Bench Mistake数据集
BIG-Bench 包含了 2186 个使用 CoT 风格的轨迹信息集合。每个轨迹都是由 PaLM 2-L-Unicorn 生成的,并且标注了第一个逻辑错误的位置。表格 1 展示了一个轨迹示例,其中错误出现在第 4 步
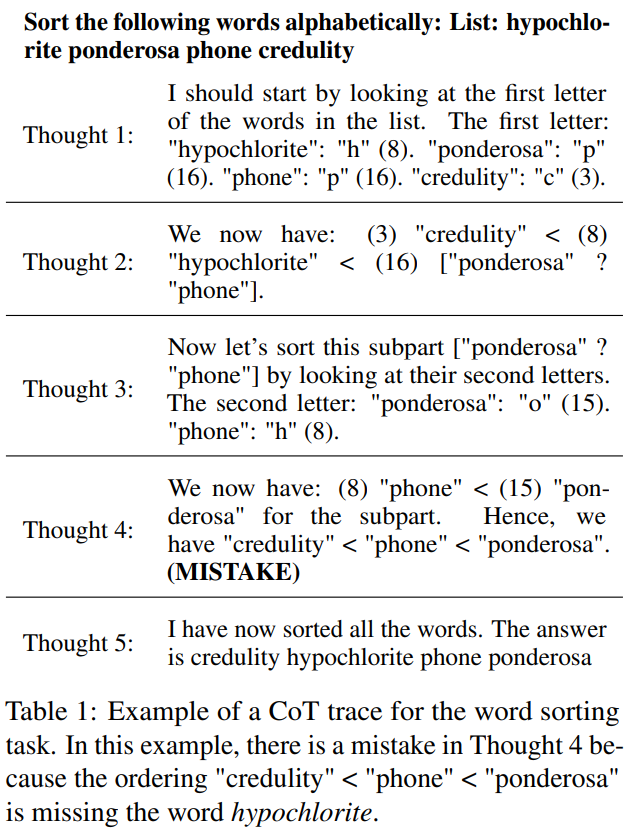
这些轨迹来自 BIG-Bench 数据集中的 5 个任务:词排序、跟踪经过混洗的对象、逻辑推演、多步算术和 Dyck 语言。
为了解答每个任务的问题,他们使用了CoT prompt 设计法来调用 PaLM 2。为了将 CoT 轨迹分成明确的步骤,他们采用了《React: Synergizing reasoning and acting in language models》中提出的方法,分开生成每一步,并使用换行符作为停止标记
生成所有轨迹时,在该数据集中,当temperature = 0时,答案的正确性由精确匹配决定
基准测试结果
在新的错误发现数据集上,报告了GPT-4-Turbo、GPT-4和GPT-3.5-Turbo的准确度如表4所示
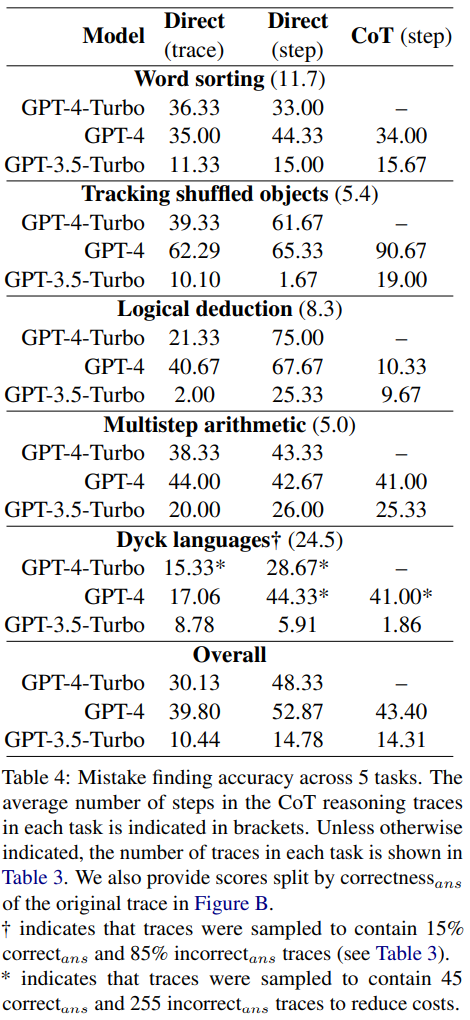
每个问题都有两种可能的答案:要么正确,要么错误。如果是错误的话,数值 N 将指示第一个错误出现的步骤
所有模型都被输入了同样的 3 个 prompt。他们使用了三种不同的 prompt 设计方法:
- 直接的轨迹层面的 prompt 设计
- 直接的步骤层面的 prompt 设计
- CoT 步骤层面的 prompt 设计
需要重新写作的内容是:相关讨论
研究结果表明,这三个模型都难以应对这个新的错误发现数据集。GPT 的表现最好,但其在直接的步骤层面的 prompt 设计上也只能达到 52.87 的总体准确度。
这说明当前最佳的 LLM 难以发现错误,即使是在最简单和明确的案例中。相较之下,人类在没有特定专业知识时也能发现错误,并且具有很高的一致性。
研究者猜测:LLM 无法发现错误是 LLM 无法自我校正推理错误的主要原因。
prompt 设计方法的比较
研究人员发现,从直接轨迹层面的方法到步骤层面的方法再到 CoT 方法,轨迹的准确度显著降低,没有出现错误。图 1 显示了这种权衡
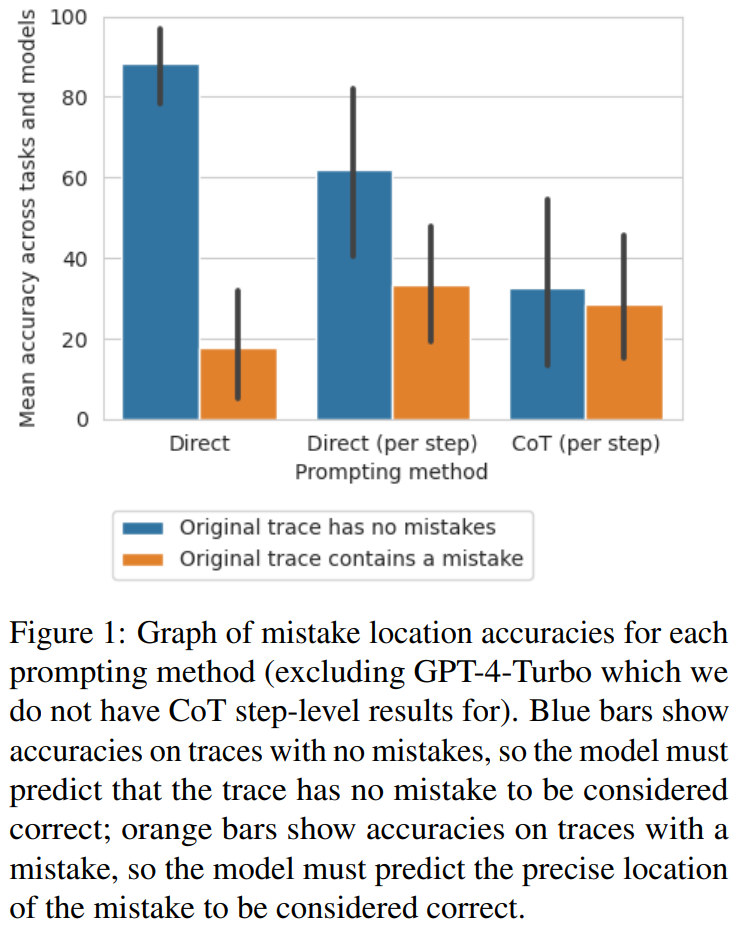
研究者认为,造成这种情况的原因可能是模型输出的数量。这三种方法都需要生成越来越复杂的输出:直接生成轨迹的提示设计方法需要单个标记,直接生成步骤的提示设计方法需要每步一个标记,而CoT步骤层面的提示设计方法则需要每步多个句子。如果每次生成调用的错误率存在一定的概率,则每条轨迹的调用次数越多,模型至少识别出一个错误的可能性就越大
将错误位置作为正确性代理的少样本 prompt 设计
研究者探究了这些 prompt 设计方法能否可靠地决定一个轨迹的正确性,而不是错误位置。
他们算出了平均F1分数,计算依据是模型能否正确预测轨迹中是否存在错误。如果存在错误,则认为模型预测的轨迹是“错误答案”。否则,认为模型预测的轨迹是“正确答案”
使用 correct_ans 和 incorrect_ans 作为正例标签,并根据每个标签的出现次数进行加权,研究者计算了平均 F1 分数,结果见表 5。
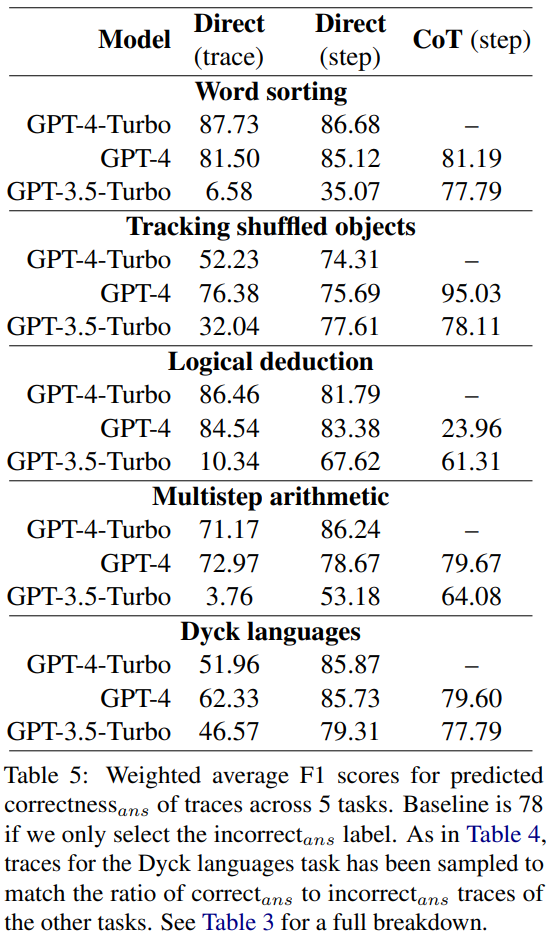
这个加权 F1 分数表明,对于确定最终答案的正确性而言,通过 prompt 寻找错误是一个很糟糕的策略。
回溯
黄等人指出,LLM在没有外部反馈的情况下无法自我校正逻辑错误。然而,在许多真实世界的应用中,通常是没有可用的外部反馈的
研究者在这项研究中采用了一种替代方案:用一个在少量数据上训练的轻量级分类器替代外部反馈。与传统强化学习中的奖励模型类似,这个分类器可以检测 CoT 轨迹中的任何逻辑错误,然后再将其反馈给生成器模型以提升输出。如果想要最大化提升,可以进行多次迭代。
研究者提出了一种简单的方法,通过回溯逻辑错误的位置来提升模型的输出
- 模型首先生成一个初始的 CoT 轨迹。在实验中,设置 temperature = 0。
- 然后使用奖励模型确定轨迹中错误的位置。
- 如果没有错误,就转向下一个轨迹。如果有错误,则再次向模型输入 prompt 以执行相同的步骤,但这一次 temperature = 1,生成 8 个输出。这里会使用同样的 prompt 以及包含错误步骤之前所有步骤的部分轨迹。
- 在这 8 个输出中,过滤掉与之前的错误一样的选项。再从剩下的输出中选择对数概率最高的一个。
- 最后,用新的重新生成的步骤替换之前步骤,再重新设置 temperature = 0,继续生成该轨迹的剩余步骤。
相比于之前的自我校正方法,这种回溯方法有诸多优势:
- 新的回溯方法不需要对答案有预先的知识。相反,它依赖于有关逻辑错误的信息(比如来自训练奖励模型的信息),这可以使用奖励模型一步步地确定。逻辑错误可能出现在 correct_ans 轨迹中,也可能不出现在 incorrect_ans 轨迹中。
- 回溯方法不依赖于任何特定的 prompt 文本或措辞,从而可减少相关的偏好。
- 相比于需要重新生成整个轨迹的方法,回溯方法可以通过复用已知逻辑正确的步骤来降低计算成本。
- 回溯方法可直接提升中间步骤的质量,这可能对需要正确步骤的场景来说很有用(比如生成数学问题的解),同时还能提升可解释性。
研究人员使用 BIG-Bench Mistake 数据集进行实验,旨在探讨回溯方法是否有助于 LLM 校正逻辑错误。实验结果请参见表格6
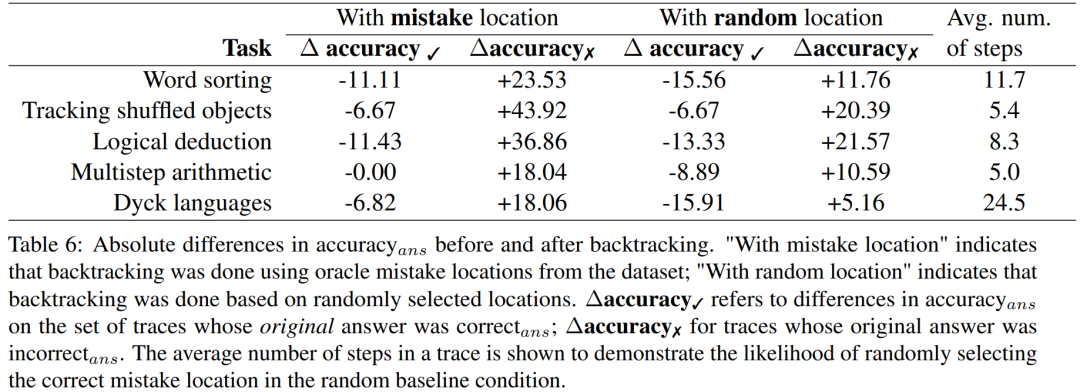
∆accuracy✓ 是指在原始答案是 correct_ans 时,在轨迹集合上的 accuracy_ans 之差。
对于错误答案轨迹的结果,需要重新计算准确度
这些分数结果表明:校正 incorrect_ans 轨迹的收益大于改变原本正确的答案所造成的损失。此外,尽管随机基准也获得了提升,但它们的提升显著小于使用真正错误位置时的提升。注意,在随机基准中,涉及步骤更少的任务更可能获得性能提升,因为这样更可能找到真正错误的位置。
为了探索在没有好的标签时,需要哪种准确度等级的奖励模型,他们实验了通过模拟的奖励模型使用回溯;这种模拟的奖励模型的设计目标是产生不同准确度等级的标签。他们使用 accuracy_RM 表示模拟奖励模型在指定错误位置的准确度。
当给定奖励模型的 accuracy_RM 为 X% 时,便在 X% 的时间使用来自 BIG-Bench Mistake 的错误位置。对于剩余的 (100 − X)%,就随机采样一个错误位置。为了模拟典型分类器的行为,会按照与数据集分布相匹配的方式来采样错误位置。研究者也想办法确保了采样的错误位置与正确位置不匹配。结果见图 2。
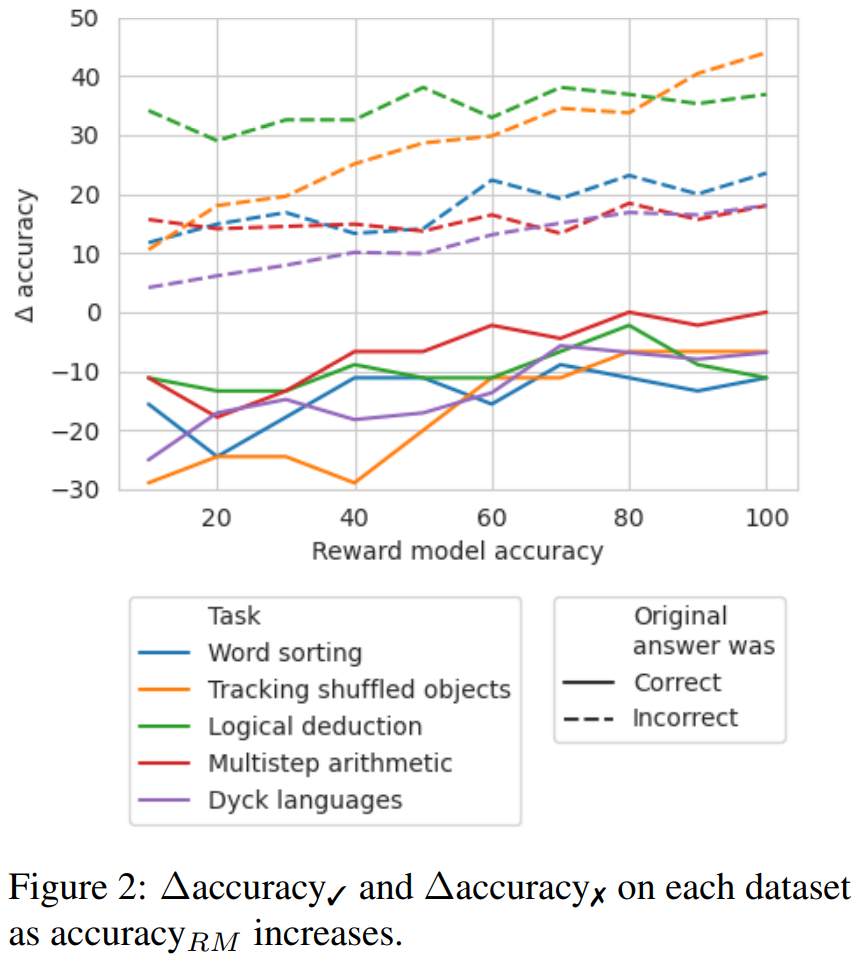
可以观察到,当损失率达到65%时,∆准确率开始趋于稳定。实际上,对于大多数任务而言,在准确率_RM约为60-70%时,∆准确率✓已经超过了∆准确率✗。这表明,尽管更高的准确率可以获得更好的结果,但即使没有黄金标准的错误位置标签,回溯仍然有效
5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
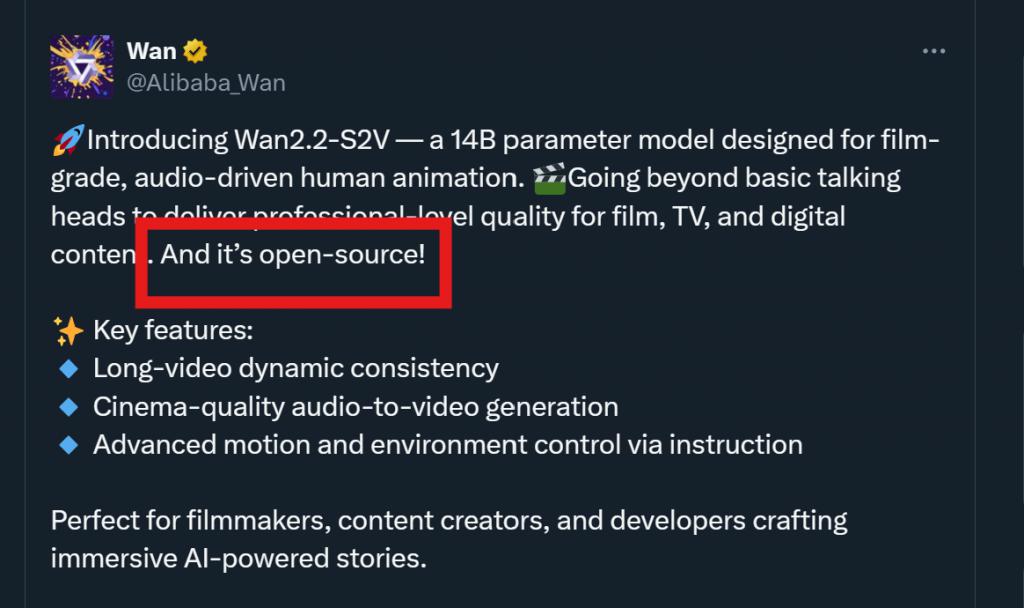
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音
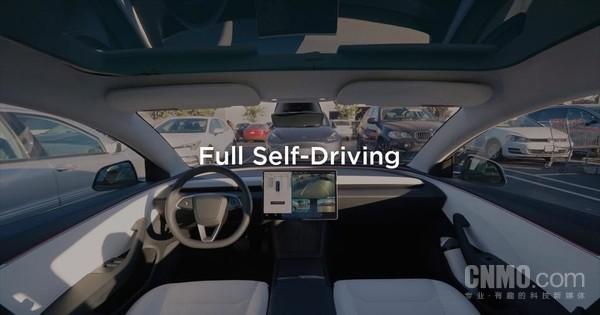
近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
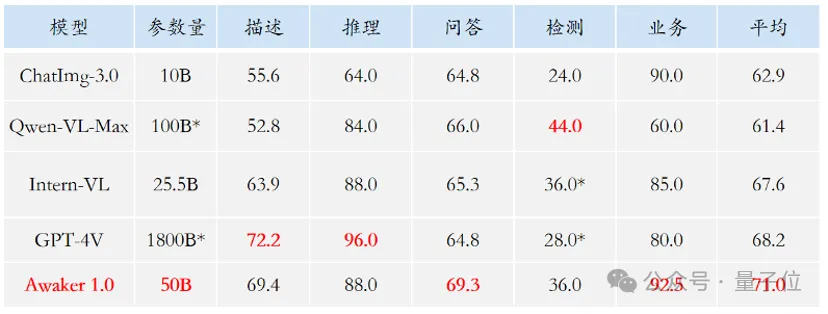
哭死啊,全球狂炼大模型,一互联网的数据不够用,根本不够用。训练模型搞得跟《饥饿游戏》似的,全球AI研究者,都在苦恼怎么才能喂饱这群数据大胃王。尤其在多模态任务中,这一问题尤为突出。一筹莫展之际,来自人大系的初创团队,用自家的新模型,率先在国内把“模型生成数据自己喂自己”变成了现实。而且还是理解侧和生成侧双管齐下,两侧都能生成高质量、多模态的新数据,对模型本身进行数据反哺。模型是啥?中关村论坛上刚刚露面的多模态大模型Awaker1.0。团队是谁?智子引擎。由人大高瓴人工智能学院博士生高一钊创立,高瓴人工智能
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



