

Python高效合并多层CSV文件方法
本教程将指导您如何利用Python的pathlib库递归查找多层子文件夹中的所有CSV文件,并结合pandas库将这些文件高效地合并成一个统一的CSV文件。文章详细介绍了文件发现、数据读取、高效合并以及结果保存的完整流程,并提供了优化的代码示例和实用注意事项,旨在帮助用户处理复杂目录结构下的数据整合需求。

本教程将指导您如何利用Python的`pathlib`库递归查找多层子文件夹中的所有CSV文件,并结合`pandas`库将这些文件高效地合并成一个统一的CSV文件。文章详细介绍了文件发现、数据读取、高效合并以及结果保存的完整流程,并提供了优化的代码示例和实用注意事项,旨在帮助用户处理复杂目录结构下的数据整合需求。
在日常数据处理工作中,我们经常会遇到数据分散在多个子文件夹甚至多层嵌套子文件夹中的情况。例如,一个项目可能按日期或类别创建了大量的子目录,每个子目录中都包含一个或多个需要合并的CSV文件。手动查找和合并这些文件不仅耗时,而且容易出错。本教程将展示如何利用Python的pathlib模块进行高效的文件系统遍历,并结合pandas库进行数据读取和合并,从而自动化这一过程,生成一个统一的CSV文件。
核心库介绍:Pathlib与Pandas
要实现这一目标,我们将主要依赖两个强大的Python库:
- pathlib: Python 3.4+ 引入的标准库,提供了面向对象的文件系统路径操作。它比传统的os.path模块更现代、更直观。其中,Path.rglob()方法是递归查找文件的关键。
- pandas: 一个广泛用于数据分析和操作的库。它提供了DataFrame数据结构,以及方便的read_csv()函数用于读取CSV文件,和concat()函数用于合并多个DataFrame。
实现步骤详解
以下是将多层子文件夹中的CSV文件合并到单个文件的具体步骤。
1. 导入所需库
首先,我们需要导入pathlib和pandas库。
from pathlib import Path
import pandas as pd
2. 定义基础目录和输出文件
您需要指定包含所有子文件夹的父目录路径,以及合并后输出文件的名称。
# 定义包含所有子文件夹的父目录
# 假设您的父目录名为 'Sessions',且与脚本在同一级别或已在系统路径中
base_directory = 'Sessions'

# 定义合并后输出的CSV文件名
output_csv_name = 'weather_All.csv'
3. 递归查找所有CSV文件
使用pathlib.Path.rglob('*.csv')方法可以递归地在指定目录及其所有子目录中查找所有扩展名为.csv的文件。
base_path = Path(base_directory)
csv_files = list(base_path.rglob('*.csv'))

if not csv_files:
    print(f"在目录 '{base_directory}' 中未找到任何CSV文件。")
    # 可以选择在此处退出或抛出异常
rglob()返回一个生成器,为了方便后续处理,我们将其转换为列表。
4. 读取并收集DataFrame
为了提高效率,最佳实践是先将所有CSV文件读取到独立的pandas.DataFrame对象中,并将这些DataFrame收集到一个列表中。避免在循环中反复调用pd.concat(),因为这会导致频繁创建新的DataFrame对象,效率较低。
all_dataframes = []

for file_path in csv_files:
    try:
        df = pd.read_csv(file_path)
        all_dataframes.append(df)
        print(f"已读取文件: {file_path}")
    except Exception as e:
        print(f"读取文件失败: {file_path}, 错误信息: {e}")

if not all_dataframes:
    print("没有成功读取任何CSV文件,无法进行合并。")
    # 可以选择在此处退出或抛出异常
这里加入了try-except块,以处理在读取某个CSV文件时可能出现的错误(例如,文件损坏、编码问题等),从而避免程序中断。
5. 合并所有DataFrame
当所有DataFrame都收集到列表后,可以使用pd.concat()函数一次性将它们合并成一个大的DataFrame。ignore_index=True参数用于重置合并后DataFrame的索引,避免出现重复索引。
combined_df = pd.concat(all_dataframes, ignore_index=True)
print(f"\n成功合并了 {len(all_dataframes)} 个CSV文件。")
print("合并后数据的前5行:")
print(combined_df.head())
6. 保存合并后的数据
最后,将合并后的DataFrame保存为一个新的CSV文件。index=False参数表示不将DataFrame的索引写入CSV文件,encoding='utf-8-sig'则可以确保文件在不同系统上打开时中文等特殊字符不会出现乱码。
output_path = base_path / output_csv_name
combined_df.to_csv(output_path, index=False, encoding='utf-8-sig')
print(f"\n合并后的数据已保存至: {output_path}")
完整代码示例
将上述步骤整合到一个函数中,便于复用。
from pathlib import Path
import pandas as pd

def combine_nested_csv_files(base_directory: str, output_csv_name: str = "combined_data.csv"):
    """
    递归查找指定父目录及其所有子目录中的CSV文件,
    并将其合并为一个单一的CSV文件。

    Args:
        base_directory (str): 包含所有子文件夹和CSV文件的父目录路径。
        output_csv_name (str): 合并后输出的CSV文件名。
                                 该文件将保存在 base_directory 下。
    """
    base_path = Path(base_directory)

    if not base_path.is_dir():
        print(f"错误: 基础目录 '{base_directory}' 不存在或不是一个目录。")
        return

    csv_files = list(base_path.rglob('*.csv'))

    if not csv_files:
        print(f"在目录 '{base_directory}' 及其子目录中未找到任何CSV文件。")
        return

    all_dataframes = []
    print(f"开始处理目录: {base_directory}")

    for file_path in csv_files:
        try:
            df = pd.read_csv(file_path)
            all_dataframes.append(df)
            print(f"  - 已成功读取: {file_path}")
        except pd.errors.EmptyDataError:
            print(f"  - 警告: 文件为空,跳过: {file_path}")
        except Exception as e:
            print(f"  - 错误: 读取文件失败: {file_path}, 错误信息: {e}")

    if not all_dataframes:
        print("没有成功读取任何CSV文件,无法进行合并。")
        return

    print("\n所有CSV文件已读取完毕,开始合并...")
    try:
        combined_df = pd.concat(all_dataframes, ignore_index=True)
        print(f"成功合并了 {len(all_dataframes)} 个CSV文件。")

        output_path = base_path / output_csv_name
        combined_df.to_csv(output_path, index=False, encoding='utf-8-sig')
        print(f"合并后的数据已保存至: {output_path}")
        print("合并完成。")
    except Exception as e:
        print(f"合并或保存数据时发生错误: {e}")

# --- 示例用法 ---
# 假设您的项目结构如下:
# YourProject/
# ├── script.py
# └── Sessions/
#     ├── day1/
#     │   └── weather/
#     │       └── weather1.csv
#     ├── day2/
#     │   └── weather/
#     │       └── weather2.csv
#     └── day3/
#         └── weather/
#             └── weather3.csv
#
# 调用函数:
combine_nested_csv_files('Sessions', 'weather_All.csv')

# 如果您的父目录在更深的路径,例如:
# combine_nested_csv_files('/path/to/your/Sessions', 'weather_All.csv')
注意事项与最佳实践
- 效率优化: 避免在循环内部频繁地使用pd.concat()。每次concat都会创建一个新的DataFrame,对于大量文件或大文件,这会消耗大量内存和CPU时间。本教程中采用的“先收集后合并”策略是更高效的做法。
- 错误处理: 在读取CSV文件时,可能会遇到各种问题,如文件不存在、文件损坏、编码错误或文件为空。使用try-except块可以优雅地处理这些异常,避免程序崩溃。pd.errors.EmptyDataError专门用于处理空文件。
- 内存管理: 对于包含数百万行或数十GB数据的超大CSV文件,即使是“先收集后合并”的策略也可能导致内存不足(MemoryError)。在这种情况下,可以考虑以下替代方案:
- 分块读取和合并: 使用pd.read_csv(chunksize=...)分块读取每个文件,然后将块合并到目标文件,而不是一次性加载所有数据到内存。
- 使用Dask: Dask是一个并行计算库,可以处理超出内存限制的数据集,其API与Pandas非常相似。
- 列名一致性: pd.concat()默认会根据列名进行合并。如果不同CSV文件的列名不完全一致,pandas会自动填充NaN值。如果需要严格的列名匹配或重命名,您可能需要在读取每个DataFrame后进行预处理。
- 编码问题: CSV文件的编码多种多样(如UTF-8、GBK、Latin-1等)。如果pd.read_csv()报错,很可能是编码问题。尝试在pd.read_csv()中指定encoding参数,例如pd.read_csv(file_path, encoding='gbk')。同样,to_csv()也建议明确指定encoding。
- 文件路径: 确保base_directory参数指向正确的父目录。如果脚本和Sessions目录不在同一位置,需要提供完整的绝对路径。
总结
通过本教程,您已经学会了如何利用Python的pathlib和pandas库高效地合并多层子文件夹中的CSV文件。这种方法不仅自动化了重复性任务,还通过优化合并策略和错误处理,提高了代码的健壮性和效率。掌握这些技能将大大提升您在数据处理和分析工作中的生产力。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
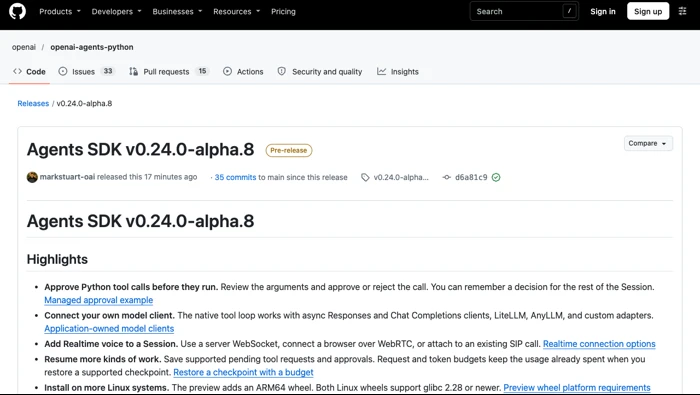
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
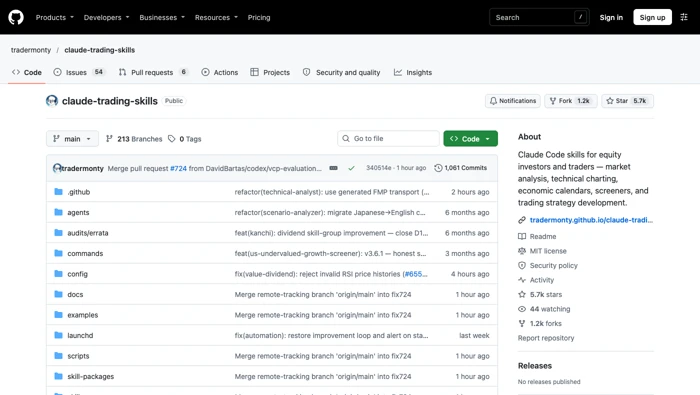
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



