

基于自定义迭代序号对齐合并多个 DataFrame 的完整教程
本文介绍如何根据用户指定的iteration字符串列表,分别从多个DataFrame中提取对应行并横向拼接,实现灵活、可控的跨表对齐合并,适用于性能测试数据对比等场景。

本文介绍如何根据用户指定的 iteration 字符串列表,分别从多个 DataFrame 中提取对应行并横向拼接,实现灵活、可控的跨表对齐合并,适用于性能测试数据对比等场景。
在实际数据分析(尤其是存储/数据库性能测试)中,常需将不同轮次、不同配置下的指标(如 IOPS、延迟)按特定 iteration 标识进行横向比对。但这些 iteration 值往往不完全一致,也无法直接使用 merge 或 join 的默认逻辑(如 inner/outer)。此时,按用户定义的顺序与索引显式对齐成为关键需求。
Pandas 提供了高效且可复用的解决方案:通过 set_index → reindex → reset_index 三步完成“按指定顺序拉取并保持对齐”,再结合 pd.concat(..., axis=1) 实现列方向拼接。
✅ 核心实现步骤
- 定义对齐函数:将 iteration 设为索引,按目标列表重排行序(缺失项自动填充 NaN),最后恢复 iteration 为普通列;
- 分别对齐各 DataFrame:传入各自对应的 iteration 列表;
- 水平拼接结果:使用 axis=1 将对齐后的 DataFrame 并排组合。
import pandas as pd

def align(df, lst):
    return (df.set_index('iteration')
              .reindex(lst)  # 严格按 lst 顺序取行,缺失则为 NaN
              .reset_index())

# 示例数据(已简化)
df1 = pd.DataFrame({
    'iteration': ['1_1', '2_2', '3_3', '4_4', '5_5', '6_6', '7_7', '8_8', '9_9'],
    'IOPS': [46090, 12, 49164, 98311, 196604, 249843, 298974, 348108, 397230],
    'Latency': [0.7300, 0.0221, 0.1236, 0.1318, 0.2076, 0.1467, 0.1578, 0.1604, 0.1707]
})

df2 = pd.DataFrame({
    'iteration': ['1_1', '2_2', '3_3', '4_4', '5_5', '6_6'],
    'IOPS': [46074, 12, 49159, 98307, 298976, 397265],
    'Latency': [0.6977, 0.0279, 0.1921, 0.2189, 0.2337, 0.2622]
})

# 按需指定每张表要提取的 iteration 序列
out = pd.concat([
    align(df1, ['1_1', '2_2', '3_3', '9_9']),
    align(df2, ['1_1', '2_2', '5_5', '6_6'])
], axis=1)

print(out)输出结果:
  iteration    IOPS  Latency iteration    IOPS  Latency
0       1_1   46090   0.7300       1_1   46074   0.6977
1       2_2      12   0.0221       2_2      12   0.0279
2       3_3   49164   0.1236       5_5  298976   0.2337
3       9_9  397230   0.1707       6_6  397265   0.2622
? 注意:reindex 保证输出行数等于目标列表长度,且严格按列表顺序排列;若某 iteration 在原始 DataFrame 中不存在,对应位置将为 NaN(可根据需要后续用 fillna() 处理)。
? 扩展:批量处理多个 DataFrame
当涉及 3 个及以上 DataFrame 时,推荐使用 itertools.starmap + zip 统一调度,提升代码可维护性:
from itertools import starmap

dfs = [df1, df2]  # 待处理的 DataFrame 列表
iters = [
    ['1_1', '2_2', '3_3', '9_9'],  # df1 对应的 iteration
    ['1_1', '2_2', '5_5', '6_6']   # df2 对应的 iteration
]

out = pd.concat(starmap(align, zip(dfs, iters)), axis=1)
⚠️ 注意事项与最佳实践
- 确保 iteration 列类型一致:避免因字符串/数字混用导致匹配失败(建议统一为 str);
- 检查重复值:若 iteration 在某 DataFrame 中存在重复,set_index 会引发 ValueError,需先去重或聚合;
- 列名冲突管理:若多个 DataFrame 含有同名列(非 iteration),拼接后将自动添加 .x, .y 后缀;如需自定义,可在 align() 内重命名列(例如 df.rename(columns={'IOPS': 'IOPS_df1'}));
- 性能提示:对超大表,reindex 比 isin + loc 更高效,因其底层基于哈希索引查找。
掌握该模式后,你不仅能精准比对任意子集的测试结果,还可轻松扩展至多工具、多环境、多参数组合的自动化分析流水线。
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
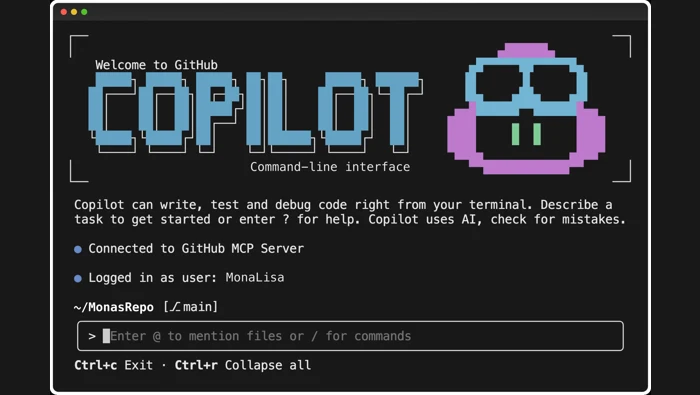
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
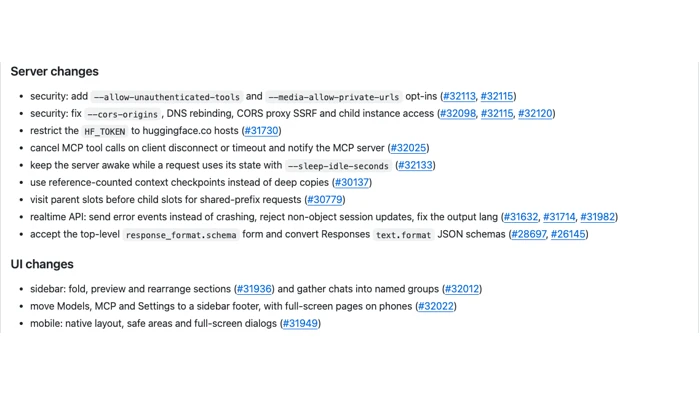
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
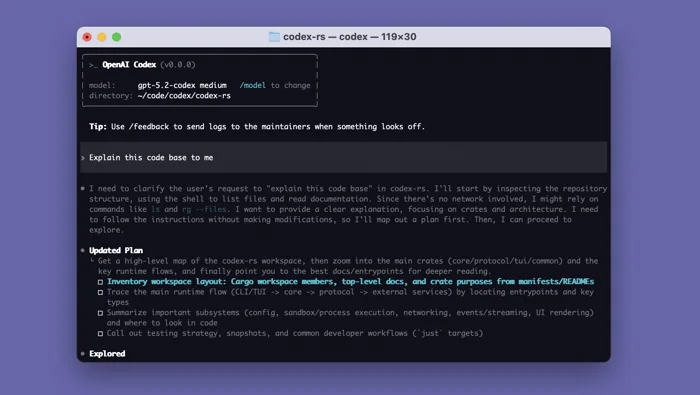
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



