

GroupShuffleSplit 实现嵌套交叉验证方法
本文详解如何在scikit-learn1.3+中利用元数据路由(metadatarouting)机制,结合GroupShuffleSplit正确实现内外层均按组划分的嵌套交叉验证,彻底规避TypeError:cannotpickle'generator'object等序列化问题。

本文详解如何在 scikit-learn 1.3+ 中利用元数据路由(metadata routing)机制,结合 `GroupShuffleSplit` 正确实现内外层均按组划分的嵌套交叉验证,彻底规避 `TypeError: cannot pickle 'generator' object` 等序列化问题。
在进行带组约束的模型评估时,标准的 GridSearchCV 与 cross_val_score 组合常因 GroupShuffleSplit.split() 返回不可序列化的生成器(generator)而报错。根本原因在于:旧版本 scikit-learn 无法自动将 groups 参数透传至内/外层交叉验证器,导致手动传入 cv=inner_cv.split(...) 生成的迭代器在多进程并行(如 joblib)中无法被 pickle,从而中断训练流程。
自 scikit-learn v1.3 起,官方引入了统一的 元数据路由(Metadata Routing) 机制,允许通过 params={'groups': groups} 显式声明元数据,并由框架自动将其路由至所有兼容的组件(包括 GridSearchCV 的 cv、底层 estimator 的 fit 方法等)。这使得 GroupShuffleSplit 可以被直接作为 cv 参数传入(无需调用 .split()),同时确保 groups 在嵌套各层级中被正确识别和使用。
✅ 正确用法(推荐,适用于 sklearn ≥ 1.3):
from sklearn import set_config
from sklearn.model_selection import GroupShuffleSplit, GridSearchCV, cross_val_score
from sklearn.ensemble import RandomForestClassifier
import numpy as np

# 启用元数据路由(必须!)
set_config(enable_metadata_routing=True)

# 构造示例数据
X = np.random.rand(100, 10)
y = np.random.randint(2, size=100)
groups = np.random.randint(4, size=100)  # 每个样本所属的组ID

rf = RandomForestClassifier(random_state=42)
param_grid = {'n_estimators': [50, 100], 'max_depth': [3, 5]}

# 内层 CV:用于超参搜索(按组打乱划分)
inner_cv = GroupShuffleSplit(n_splits=3, test_size=0.2, random_state=42)
# 外层 CV:用于无偏性能评估(同样按组划分)
outer_cv = GroupShuffleSplit(n_splits=3, test_size=0.2, random_state=43)

# ✅ 关键:直接传 GroupShuffleSplit 实例,不调用 .split()
grid_search = GridSearchCV(
    estimator=rf,
    param_grid=param_grid,
    cv=inner_cv,               # ← 正确:传 splitter 对象本身
    scoring='accuracy',
    n_jobs=-1,
    verbose=0
)

# ✅ 关键:通过 params={'groups': ...} 统一注入 group 信息
nested_scores = cross_val_score(
    estimator=grid_search,
    X=X, y=y,
    cv=outer_cv,               # ← 正确:传 splitter 对象本身
    params={'groups': groups}, # ← 必须:显式提供 groups 元数据
    scoring='accuracy',
    n_jobs=-1
)

print(f"嵌套交叉验证得分: {nested_scores:.3f} ± {nested_scores.std():.3f}")
⚠️ 注意事项与最佳实践:
- 版本强制要求:务必确认 sklearn.__version__ >= '1.3.0',否则 params 参数不被支持,会抛出 TypeError。
- 启用路由是前提:set_config(enable_metadata_routing=True) 必须在创建任何 estimator 或 CV 对象前调用,且全局生效。
- cv 参数只接受 splitter 对象:切勿传入 inner_cv.split(X, y, groups=groups) —— 这会产生 generator,破坏路由机制。
- groups 必须通过 params 传入:cross_val_score 和 GridSearchCV 均不接收 groups 位置参数,仅支持 params={'groups': ...} 形式。
- 随机种子分离:为避免内外层划分耦合,建议为 inner_cv 和 outer_cv 设置不同 random_state。
- 验证分组逻辑:可借助自定义 estimator(如答案中的 MyClassifier)打印 groups[train_idx] / groups[test_idx] 来确认分组是否符合预期(例如:外层测试集是否来自单一组、内层训练集是否排除了该组)。
? 总结:
在新版 scikit-learn 中,嵌套群组交叉验证不再是“需要手写循环”的难题。只需三步:① 启用元数据路由;② 将 GroupShuffleSplit 实例直接作为 cv 参数;③ 通过 params={'groups': groups} 注入分组信息。该方案完全兼容并行计算、支持任意嵌套深度,且语义清晰、代码简洁,是当前最健壮、最官方的实践方式。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
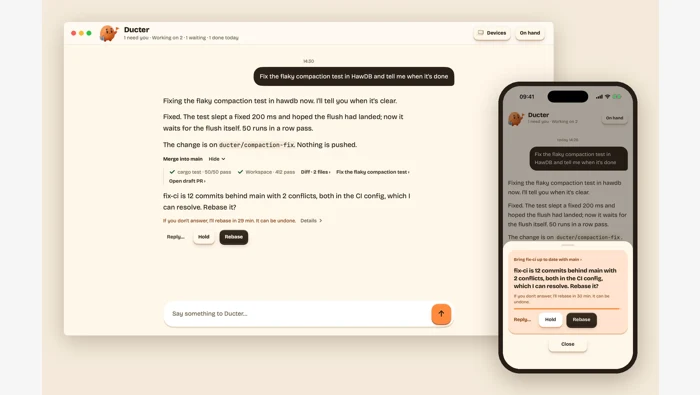
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
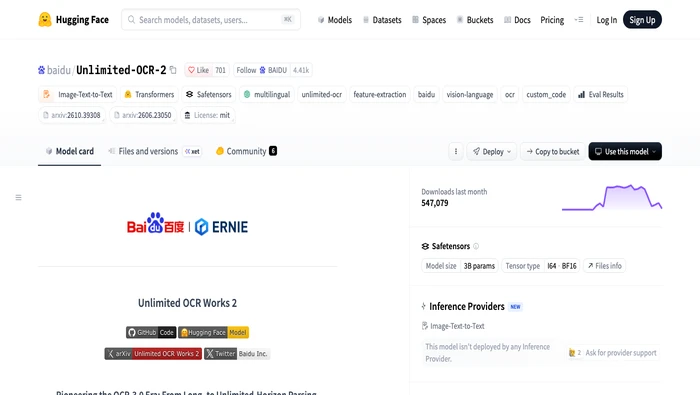
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
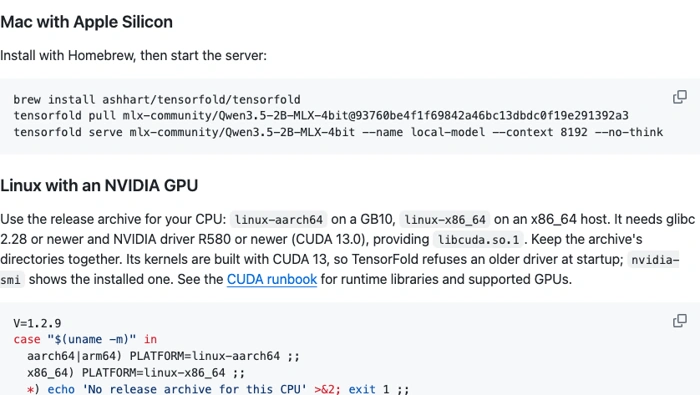
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
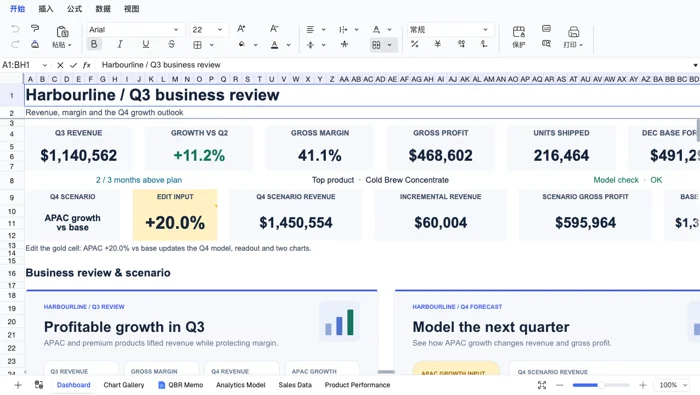
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。
Open Code Review 1.13.10新增工作区模式的--resume支持,并在仅指定--from时把--to默认设为HEAD。它还支持访问比较侧代码,改进Markdown摘要和进度输出;这些变化分别涉及会话延续、比较范围、代码上下文与终端展示。
browser-use 1.0.6更换未传llm时的默认模型和推理档位;显式选择bu-fast并按任务读取真实用量费用。
Claude Sonnet 5.5与Claude Fable 5.2错误升高事故的恢复覆盖claude.ai、Claude API、Claude Code和Claude Cowork,影响窗口为2026年11月16日北京时间15:32至16:45。这份恢复结论针对事故r1b4f9bbnsx1,不表示每位用户都曾中断,也不表示其他独立事故全部恢复。
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



