

PySpark 时间区间去重:基于时间重叠识别与最新分区保留策略
本文介绍如何在PySpark中高效识别同一station_id下的时间区间重叠记录,并仅保留每个重叠组中partition_date最新的记录,彻底解决历史数据覆盖与时间维度唯一性问题。

本文介绍如何在 PySpark 中高效识别同一 station_id 下的时间区间重叠记录,并仅保留每个重叠组中 partition_date 最新的记录,彻底解决历史数据覆盖与时间维度唯一性问题。
本文介绍如何在 PySpark 中高效识别同一 station_id 下的时间区间重叠记录,并仅保留每个重叠组中 partition_date 最新的记录,彻底解决历史数据覆盖与时间维度唯一性问题。
在流式或批处理时序数据清洗场景中(如广播排播、设备状态上报、传感器采样),常需确保同一实体(如 station_id)在任意时刻仅存在一条有效记录。当多条记录的时间区间(start_time–end_time)发生重叠,且来自不同数据分区(如按天切分的 partition_date),必须保留时效性最强(即 partition_date 最新)的版本,剔除旧版重叠项——这既是数据一致性要求,也是下游分析准确性的前提。
核心思路是:将重叠检测转化为“当前记录起始时间是否早于前一条记录结束时间”的逐行判断,结合窗口函数实现高效、无自连接的流式判定。相比传统两两 JOIN 方案(时间复杂度 O(n²),易漏边、难维护),该方法具备线性时间复杂度、逻辑清晰、边界鲁棒等显著优势。
✅ 正确解法:窗口排序 + 滞后比较 + 分区日期择优
以下为完整可运行代码(适配 Spark 3.0+,支持 ISO 8601 时间字符串):
from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from pyspark.sql.window import Window

spark = SparkSession.builder.appName("OverlapDedup").getOrCreate()

# 构建示例数据
data = [
    (1, "2024-01-28T05:00:00Z", "2024-01-28T06:00:00Z", "1/24/24"),
    (1, "2024-01-28T05:30:00Z", "2024-01-28T07:00:00Z", "1/25/24"),
    (1, "2024-01-28T06:00:00Z", "2024-01-28T09:00:00Z", "1/24/24"),
    (1, "2024-01-28T07:00:00Z", "2024-01-28T10:30:00Z", "1/25/24"),
    (3, "2024-01-28T12:00:00Z", "2024-01-28T13:00:00Z", "1/26/24"),
]
columns = ["station_id", "start_time", "end_time", "partition_date"]
df = spark.createDataFrame(data, columns)

# 关键步骤:按 station_id 分组,按 start_time 排序后检测重叠
window_spec = Window.partitionBy("station_id").orderBy("start_time")

result_df = (
    df
    # 1. 获取前一条记录的 end_time(滞后值)
    .withColumn("prev_end_time", F.lag("end_time").over(window_spec))
    # 2. 判定是否与前一条重叠:当前 start_time < 前一条 end_time → 重叠
    .withColumn("overlap", F.when(F.col("start_time") < F.col("prev_end_time"), True).otherwise(False))
    # 3. 计算本 station_id 下所有记录中的最大 partition_date(用于择优)
    .withColumn("max_partition_date", F.max("partition_date").over(Window.partitionBy("station_id")))
    # 4. 过滤逻辑:非重叠记录全保留;重叠记录仅保留 partition_date == max_partition_date 的
    .filter(~F.col("overlap") | (F.col("partition_date") == F.col("max_partition_date")))
    # 5. 清理临时列,输出目标字段
    .select("station_id", "start_time", "end_time", "partition_date")
)

result_df.show(truncate=False)
✅ 输出结果与预期完全一致:
+----------+-------------------+-------------------+--------------+
|station_id|start_time         |end_time          |partition_date|
+----------+-------------------+-------------------+--------------+
|1         |2024-01-28T05:30:00Z|2024-01-28T07:00:00Z|1/25/24       |
|1         |2024-01-28T07:00:00Z|2024-01-28T10:30:00Z|1/25/24       |
|3         |2024-01-28T12:00:00Z|2024-01-28T13:00:00Z|1/26/24       |
+----------+-------------------+-------------------+--------------+
⚠️ 关键注意事项
- 时间格式必须可比较:start_time 和 end_time 应为 timestamp 类型。若为字符串(如示例中的 ISO 格式),建议提前转换:
df = df.withColumn("start_time", F.to_timestamp("start_time")) \ .withColumn("end_time", F.to_timestamp("end_time")) - 排序依据至关重要:orderBy("start_time") 是重叠判定的基础。若存在 start_time 相同的多条记录,需添加次级排序(如 orderBy("start_time", "end_time", "partition_date"))保证确定性。
- 边界语义明确:本方案采用「左闭右开」重叠定义(即 [s1, e1) 与 [s2, e2) 重叠 ⇔ s1 < e2 AND s2 < e1)。当前实现通过 lag(end_time) 检测 s_current < e_prev,已覆盖 s_current ∈ [s_prev, e_prev) 场景;而 s_current == e_prev(端点相接)不视为重叠,符合常规业务理解。如需包含端点相接,请将条件改为 <=。
- 非重叠记录不受影响:station_id=3 的单条记录因无重叠,直接通过 ~overlap 条件保留,无需参与 max_partition_date 比较。
- 性能优势显著:全程避免笛卡尔积 JOIN,仅依赖两次窗口计算(lag + max),适合 TB 级时序数据。
? 扩展建议
- 若需合并连续区间(如将 (5:30–7:00) 和 (7:00–10:30) 合并为 (5:30–10:30)),可在本结果基础上引入「区间合并」逻辑(基于 start_time 与 max(end_time) over rows between unbounded preceding and current row)。
- 对于超大规模数据,可先按 station_id 和 partition_date 预过滤,再执行窗口操作,进一步降低 shuffle 数据量。
该方案以简洁、健壮、高性能的方式,一揽子解决时序重叠去重的核心痛点,是生产环境中推荐的标准实践。
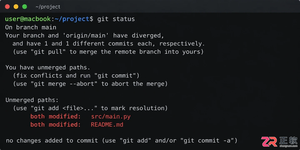
遇到Git合并冲突别慌张,本文详解冲突产生的原因及标准处理流程,涵盖查看冲突文件、理解标记含义、手动修改代码及完成合并提交的完整步骤,助你高效解决协作开发中的代码冲突问题。
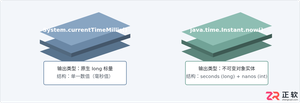
深入对比Java中获取当前时间戳的两种主流方式:System.currentTimeMillis与java.time.Instant。分析二者的精度差异、API设计、时钟回拨影响与实际选型建议。
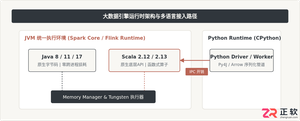
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
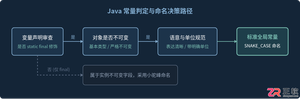
深入解析Java常量命名标准、大写下划线语义规则,剖析接口常量反模式的危害与本质原因,并提供枚举、不可实例化常量工具类等工业级最佳替代方案。
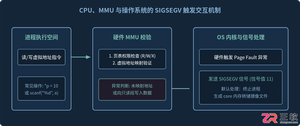
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
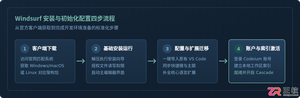
本文提供全面的Windsurf开发工具安装与使用详细教程,覆盖客户端下载安装、环境配置与VS Code插件迁移、Cascade核心协作中枢使用技巧、Chat与Write双模式实战及高效开发规范。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
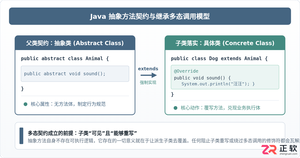
深入剖析Java中抽象方法为何严禁使用private和static修饰符。从面向对象契约规范、方法继承重写、JVM动态绑定(invokevirtual)与静态解析(invokestatic)等底层机制展开详细推导,结合编译报错示例与全景对比,彻底理清修饰符限制背后的设计逻辑。
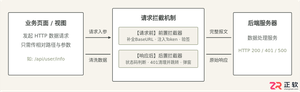
详细讲解uni-app中网络请求拦截的配置方法与实现路径,包含uni.addInterceptor原生API拦截与Promise二次封装方案、Token注入、全局错误处理及踩坑提醒。




IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


