

如何高效将 JSON 数据批量导入 Django 模型(SQL 数据库)
如何高效将 JSON 数据批量导入 Django 模型(SQL 数据库) 本文详解 Django 中将 JSON 文件数据批量写入数据库的正确方法,重点解决单次循环中仅保存最后一条记录的问题,并推荐使用 bulk_create() 实现高性能、低开销的一次性批量插入。 在 Django 开发中,从外
如何高效将 JSON 数据批量导入 Django 模型(SQL 数据库)
本文详解 Django 中将 JSON 文件数据批量写入数据库的正确方法,重点解决单次循环中仅保存最后一条记录的问题,并推荐使用 bulk_create() 实现高性能、低开销的一次性批量插入。
在 Django 开发中,从外部 JSON 文件导入数据到数据库,是个高频操作。但不少新手容易踩一个坑:在循环里创建了模型实例,却把保存操作放错了位置,结果数据库里只孤零零躺着最后一条记录,前面的数据全丢了。
比如下面这段典型的“问题代码”:
for item in data:
    my_model_instance = MyModel(...)  # 每次覆盖引用
my_model_instance.sa ve()  # ❌ 只保存最后一次迭代的对象
问题出在哪?关键在于,.sa ve() 必须放在循环内部,每创建一个实例就立刻保存。但更优的方案是:先把所有实例“攒”起来,然后一次性入库。这正是 Django ORM 的 bulk_create() 方法大显身手的地方。
这个方法会把成百上千条记录,打包成一条或极少数几条 SQL INSERT 语句发送给数据库。比起在循环里调用 N 次 .sa ve()(意味着 N 次数据库连接和事务),性能提升可不是一星半点,尤其是在处理大量数据时,效率差异能达到数十倍。
那么,具体该怎么写呢?下面是一个优化后的、可直接使用的视图函数示例:
from django.shortcuts import render
import json
from .models import MyModel
import os

def display(request):
    # 构建 JSON 文件绝对路径(注意:建议使用 settings.BASE_DIR 更健壮)
    json_file_path = os.path.join(
        os.path.dirname(__file__), '..', '..', 'jsondata.json'
    )

    try:
        with open(json_file_path, 'r', encoding='utf-8') as f:
            data = json.load(f)

        # ✅ 使用列表推导式批量构建模型实例
        model_instances = [
            MyModel(
                end_year=item.get('end_year'),
                intensity=item.get('intensity'),
                sector=item.get('sector'),
                topic=item.get('topic'),
                insight=item.get('insight'),
                url=item.get('url'),
                region=item.get('region'),
                start_year=item.get('start_year'),
                impact=item.get('impact'),
                added=item.get('added'),
                published=item.get('published'),
                country=item.get('country'),
                relevance=item.get('relevance'),
                pestle=item.get('pestle'),
                source=item.get('source'),
                title=item.get('title'),
                likelihood=item.get('likelihood'),
            )
            for item in data
        ]

        # ✅ 批量写入数据库(自动跳过空列表,支持 batch_size 参数分批)
        MyModel.objects.bulk_create(model_instances, batch_size=1000)

    except FileNotFoundError:
        data = []
        # 可选:记录日志或抛出自定义异常
        # import logging; logging.error("JSON file not found: %s", json_file_path)
    except json.JSONDecodeError as e:
        data = []
        # 处理 JSON 格式错误
        raise ValueError(f"Invalid JSON format: {e}") from e
    except Exception as e:
        # 建议捕获更具体的异常(如 IntegrityError),便于调试
        raise

    return render(request, 'display.html', {'data': data})
代码写好了,但魔鬼藏在细节里。想让这段代码足够健壮,能上生产环境,有几个关键点必须注意:
- ✅ 使用 .get(key) 替代直接 item[‘key’]:这能有效避免因为 JSON 里某个字段意外缺失而导致的
KeyError崩溃,让程序更从容。 - ✅ 指定 encoding=‘utf-8’:处理包含中文或其他非 ASCII 字符的数据时,这行代码能救命,确保不会出现乱码。
- ✅ 善用 batch_size 参数:当数据量极大(比如超过一万条)时,设置
batch_size=1000可以分批插入,既能避免单条 SQL 语句过长导致数据库报错,也能防止内存被瞬间吃光。 - ⚠️ bulk_create() 不触发 sa ve() 方法和信号:这是个重要的限制。如果你在模型的
sa ve()方法里写了自定义逻辑,或者依赖pre_sa ve/post_sa ve信号来做点事情(比如自动更新某个时间戳),那么bulk_create()会绕过它们。这种情况下,就需要考虑其他方案,比如使用model_to_dict()配合表单保存,或者手动在批量创建后触发相关逻辑。 - ⚠️ 留意主键与默认值:对于自增主键(
AutoField),bulk_create()会自动处理好。但是,对于模型中字段定义的default值(例如default=timezone.now),bulk_create()不会自动计算并填充。你需要在创建实例时,就显式地传入这些值。 - ✅ 路径安全是底线:示例中使用了相对路径来定位 JSON 文件,这在开发中或许方便,但在生产环境是隐患。最佳实践是,通过
settings.BASE_DIR来构建绝对路径,将数据文件放在项目结构内明确的位置进行管理。
把这些要点都做到位,你的 JSON 数据导入流程就不仅仅是“能用”,而是具备了生产环境所需的健壮性、可维护性与高性能。从源头避免数据丢失,让批量操作真正快起来,这才是高效开发该有的样子。
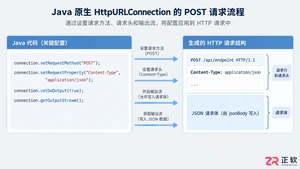
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
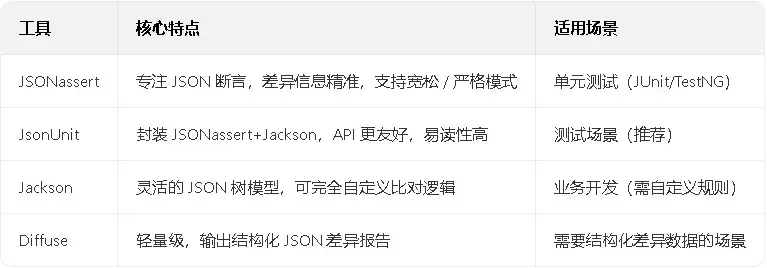
断言工具专为测试场景设计,支持宽松模式并精准定位差异;单元工具基于断言工具和杰克逊库封装,提供更友好的断言接口;杰克逊库作为主流处理库,可通过节点树模型自定义比对逻辑,适用于业务开发中精细控制差异的场景。
通过AJAX异步请求服务器获取JSON格式的表格数据,解析JSON对象后遍历数据条目,动态拼接成包含表格标签的HTML字符串,最后调用编辑器实例的setContent()方法将HTML写入编辑器,完成表格在编辑器内的初次渲染。
使用nlohmann/json库解析GeoJSONFeatureCollection,需逐层防御性访问features、geometry和properties,坐标数组维度不确定,需判断。坐标系和精度问题在解析层无法解决,应暴露原始坐标数组供上层处理。性能敏感时避免重复解析和深拷贝,可缓存并视口裁剪。
pandas.json_normalize 这个函数,说起来挺有意思的——很多人以为它能一键把嵌套 JSON 拍扁成表格,结果往往发现列名变成了一串带点的“火车”(比如 profile.address.city),真正棘手的问题却一个都没解决。字段缺失怎么办?列表嵌套怎么炸开?多层结构怎么拆?答案其





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



