

Python大数据量训练报MemoryError怎么搞_设置批处理或启用稀疏矩阵
Python大数据量训练报MemoryError怎么搞_设置批处理或启用稀疏矩阵 训练时直接报 MemoryError,说明数据一次性加载进内存撑爆了 这通常不是模型本身的问题,而是数据处理流程的“内存墙”。Python的默认习惯,比如把整个数据集(无论是numpy.ndarray还是pandas.
Python大数据量训练报MemoryError怎么搞_设置批处理或启用稀疏矩阵
训练时直接报 MemoryError,说明数据一次性加载进内存撑爆了
这通常不是模型本身的问题,而是数据处理流程的“内存墙”。Python的默认习惯,比如把整个数据集(无论是numpy.ndarray还是pandas.DataFrame)一股脑儿塞进RAM,在面对高维特征、海量样本(想象一下百万行乘万列的矩阵)或者经过OneHotEncoder编码后膨胀出的超宽矩阵时,MemoryError几乎就成了必然结局。
解决问题的核心思路其实很清晰,就两条:一是避免全量数据同时进入内存(采用批处理或流式加载),二是确保稀疏数据结构不被意外转换成稠密格式(警惕那些隐式的.toarray()调用)。
- 检查预处理器的“小动作”:重点关注
OneHotEncoder的sparse参数(新版是sparse_threshold),确保它输出稀疏矩阵。更稳妥的做法是,直接使用scipy.sparse矩阵,并搭配支持稀疏输入的模型(例如设置solver='saga'的LogisticRegression)。 - 慎用数据转换:在训练前,尽量避免调用
df.values或np.array(df),这些操作会强制进行稠密化转换。优先考虑df.to_sparse()或直接构建scipy.sparse.csr_matrix。 - 注意拆分时的开销:使用
sklearn.model_selection.train_test_split时,对于超大数组,设置shuffle=False可以避免内部为打乱顺序而创建额外的索引副本,从而节省内存。
MemoryError 是因数据全量加载进内存导致,非模型问题;应采用批处理/流式加载避免全量载入,并用 OneHotEncoder(sparse=True) 保持稀疏结构。
fit_generator 没了,用 tf.data.Dataset 或自定义迭代器喂模型
如果你身处Keras/TensorFlow生态,那么fit_generator已成为历史。不过别担心,它的替代方案——tf.data.Dataset——设计得更优雅、更高效,能实现真正的流式数据供给,几乎不占用额外内存。
这里有个关键点容易被误解:设置batch_size不等于解决了内存问题。很多人设置了batch_size=32却依然报错,根源在于他们还在用pd.read_csv('big.csv')这样的语句一次性将整个文件读入内存。真正的解决方案,是把数据读取逻辑也“流式化”,封装进生成器里:
立即学习“Python免费学习笔记(深入)”;
def data_generator():
    for chunk in pd.read_csv('huge_data.csv', chunksize=10000):
        X_chunk = chunk.drop('label', axis=1).values.astype('float32')
        y_chunk = chunk['label'].values.astype('int32')
        for i in range(0, len(X_chunk), 32):
            yield X_chunk[i:i+32], y_chunk[i:i+32]

dataset = tf.data.Dataset.from_generator(
    data_generator,
    output_signature=(
        tf.TensorSpec(shape=(None, X_dim), dtype=tf.float32),
        tf.TensorSpec(shape=(None,), dtype=tf.int32)
    )
).prefetch(tf.data.AUTOTUNE)
- 分清
chunksize和batch_size:前者控制从磁盘每次读取的行数,影响I/O和单次内存峰值;后者才是每次送入模型训练的样本数量。 - 善用
.prefetch:务必加上.prefetch(tf.data.AUTOTUNE),让数据准备和模型训练重叠进行,避免GPU等CPU读数据造成的卡顿。 - 优化操作位置:像重采样、标准化这类计算密集型操作,不要放在生成器函数内部,应该移到
Dataset的map()方法中并行处理,效率更高。
scikit-learn 模型不支持真流式?那就用 partial_fit + 分块训练
对于scikit-learn阵营,处理大数据集的王牌是那些支持partial_fit方法的模型,比如SGDClassifier、PassiveAggressiveClassifier和MiniBatchKMeans。它们不要求一次性提供全部数据,而是可以分批次地更新模型权重。
不过,使用partial_fit时有几个细节必须留意:
- 首次调用需指定类别:第一次调用
partial_fit时,必须通过classes参数传入所有可能的类别标签(例如clf.partial_fit(X_batch, y_batch, classes=np.unique(y_full))),否则后续数据块中间出现新类别会导致错误。 - 预处理器的状态管理:像
StandardScaler也提供了partial_fit,但需要手动维护其状态。通常做法是,先用第一块数据拟合一次(scaler.partial_fit(X_chunk)),之后对每一块数据都使用scaler.transform(X_chunk)进行转换,切忌对每一块数据都重新拟合。 - 超参数调优的陷阱:不要直接将
GridSearchCV套用在支持partial_fit的模型上,因为其内部会反复调用fit,行为可能不符合预期。更可靠的方法是手动编写循环,在独立的验证集上评估性能。
稀疏矩阵不是万能的,模型和操作都得配合
成功创建了一个scipy.sparse.csr_matrix只是万&里长征第一步。后续很多看似平常的操作,都可能瞬间将其打回稠密原形,导致内存暴涨:
- 矩阵拼接:使用
np.hstack([sparse_A, sparse_B])会得到一个稠密的np.ndarray。正确姿势是scipy.sparse.hstack([sparse_A, sparse_B], format='csr')。 - DataFrame取值:即使原始的
DataFrame是稀疏存储的,调用df.iloc[:, :100].values也会返回稠密数组。应该使用df.iloc[:, :100].to_numpy(dtype=np.float32),并确认底层数据块仍然是稀疏结构。 - 文本向量化的优化:使用
sklearn.feature_extraction.text.TfidfVectorizer时,显式设置dtype=np.float32(默认的float64会占用双倍内存),同时利用max_features参数限制词表大小。否则,即使矩阵是稀疏的,百万量级的特征数也足以压垮内存。
还有一个常被忽略的权衡点:GPU加速库(例如RAPIDS cuML)虽然能极大提升训练速度,但目前多数实现只接受稠密数组作为输入。这意味着,如果你想利用GPU的算力,可能就不得不放弃稀疏表示,转而寻求更大的内存。这本质上是一个“要内存效率,还是要计算速度”的抉择。

深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。

刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
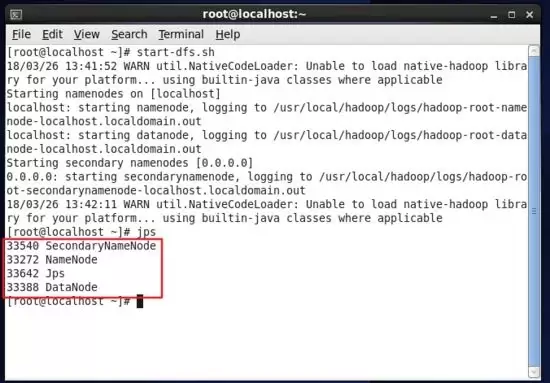
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。

要想确认麒麟OS中Python程序的运行状态以及资源占用情况,我们可以这样做:用ps -ef | grep python来筛选进程;通过top命令,按P键排序查看实时负载;使用pgrep -f "script.py"精准获取PID;借助lsof -p PID验证文件打开状态。另外,还可以结合syst
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内

在Debian系统上配置SSL证书通常涉及以下几个步骤:安装Web服务器:首先,你需要一个Web服务器,比如Apache或Nginx。这里以Apache为例。sudo apt updatesudo apt install apache2获取SSL证书:你可以从Let’s Encrypt免费获取SSL

要想让Python项目在统信UOS上正常运行,得先安装python3、python3-pip、python3-venv、python3-dev以及build-essential等组件。具体操作就是执行sudo apt install命令来一步到位完成安装,同时别忘了配置清华镜像源来给pip加速哦。在
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
