

如何在Python中按每10个文件为一组批量处理CSV文件
如何在Python中按每10个文件为一组批量处理CSV文件 本文介绍在Google Colab等环境中,对有序命名的CSV文件(如M0000.csv–M0099.csv)进行分块处理的方法:将100个文件按每10个一组归并,每组读取全部文本内容并存入独立列表,最终构建包含10个子列表的all_tex
如何在Python中按每10个文件为一组批量处理CSV文件
本文介绍在Google Colab等环境中,对有序命名的CSV文件(如M0000.csv–M0099.csv)进行分块处理的方法:将100个文件按每10个一组归并,每组读取全部文本内容并存入独立列表,最终构建包含10个子列表的all_text结构。
处理大批量有序文件时,一个常见的需求就是分组操作。比如,手头有从M0000.csv到M0099.csv整整100个文件,需要每10个文件归为一组,分别读取其中的全部文本内容。最终的目标,是得到一个名为all_text的列表,里面恰好包含10个子列表,每个子列表对应一组文件的全部文本。
听起来简单,但这里有个关键点需要特别注意:实现“每10个文件执行一次聚合操作”的核心,在于按序分组,而不是简单的条件触发。很多朋友第一反应可能会用文件序号取模(比如filenumber % 10 == 0),但这只能在第10、20、30个文件时触发某个动作,无法自然而优雅地构建出那个我们想要的、结构清晰的分组容器。更健壮、可读性也更高的做法,其实是利用整除运算来确定每个文件所属的组别索引,并动态地将其内容追加到对应的子列表里。
下面就是一个完整、即拿即用的解决方案,特别适配Google Colab和Google Drive的环境:
import glob
import pandas as pd

dir_path = 'drive/My Drive/Tri/'
all_text = []  # 最终结构:all_text[i] 是第i组(共10组)的文本列表

# 按文件名排序确保M0000.csv, M0001.csv, ..., M0099.csv顺序正确
file_list = sorted(glob.glob(dir_path + "M*.csv"))

# 遍历所有匹配文件,按每10个一组组织
for idx, file in enumerate(file_list):
    # 计算当前文件属于第几组(0-indexed:0~9)
    group_idx = idx // 10

    # 确保 all_text 至少有 group_idx + 1 个空列表
    if len(all_text) <= group_idx:
        all_text.append([])

    print(f"Processing {file} → Group {group_idx} (file #{idx + 1})")

    try:
        # 读取CSV文件全部行作为纯文本(忽略列解析,适配fwf格式)
        df = pd.read_fwf(file, header=None, on_bad_lines='skip', delimiter="\n")
        # 提取每行文本(去除NaN和空白),转为字符串列表
        texts_in_file = [str(row.iloc[0]).strip() for _, row in df.iterrows() if not pd.isna(row.iloc[0])]
        all_text[group_idx].extend(texts_in_file)
    except Exception as e:
        print(f"⚠️ Warning: Failed to process {file}: {e}")

# 验证结果
print(f"\n✅ Done! Generated {len(all_text)} groups.")
for i, group in enumerate(all_text):
    print(f"Group {i}: {len(group)} text lines (files {i*10}–{i*10+9})")
那么,这段代码有哪些值得细品的要点和需要注意的地方呢?
关键说明与注意事项
- 分组核心逻辑:
idx // 10是整个分组操作的灵魂。它使得序号0–9的文件归入第0组,10–19归入第1组,以此类推,直到90–99归入第9组。这完美契合了题目要求的10组结构,清晰又直接。 - 动态列表扩容:代码没有预先分配一个固定大小的列表,而是通过判断动态地向
all_text中添加新的空子列表。这样做的好处是避免了内存浪费,也防止了因文件数量不确定而可能出现的索引越界错误。 - 文本读取方式:这里使用了
pd.read_fwf(..., delimiter="\n")来读取文件。这种设置将每一行都视为一个独立的文本单元,完全符合“保存所有文本”的原始需求,尤其适合固定宽度格式或纯文本内容。 - 边界情况处理:如果实际文件数量不足100个,建议在循环开始前用
file_list = file_list[:100]进行截断,这样可以确保最后一组不至于因为文件缺失而变得不完整。 - 环境准备:在Google Colab中运行前,别忘了先挂载Google Drive,执行
from google.colab import drive; drive.mount('/content/drive')。 - 性能优化提示:如果处理的文件特别大,追求更高性能的话,可以考虑用Python原生的
open()函数逐行读取,来替代pandas的DataFrame操作,这样可以省去一些不必要的开销。
总的来说,这个方案结构清晰、鲁棒性强,既严格满足了all_text[0]到all_text[9]的索引需求,也为后续操作铺平了道路——无论是进行NLP清洗、文本向量化,还是批量保存,都可以非常方便地对每组文本进行统一处理。
立即学习“Python免费学习笔记(深入)”;
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
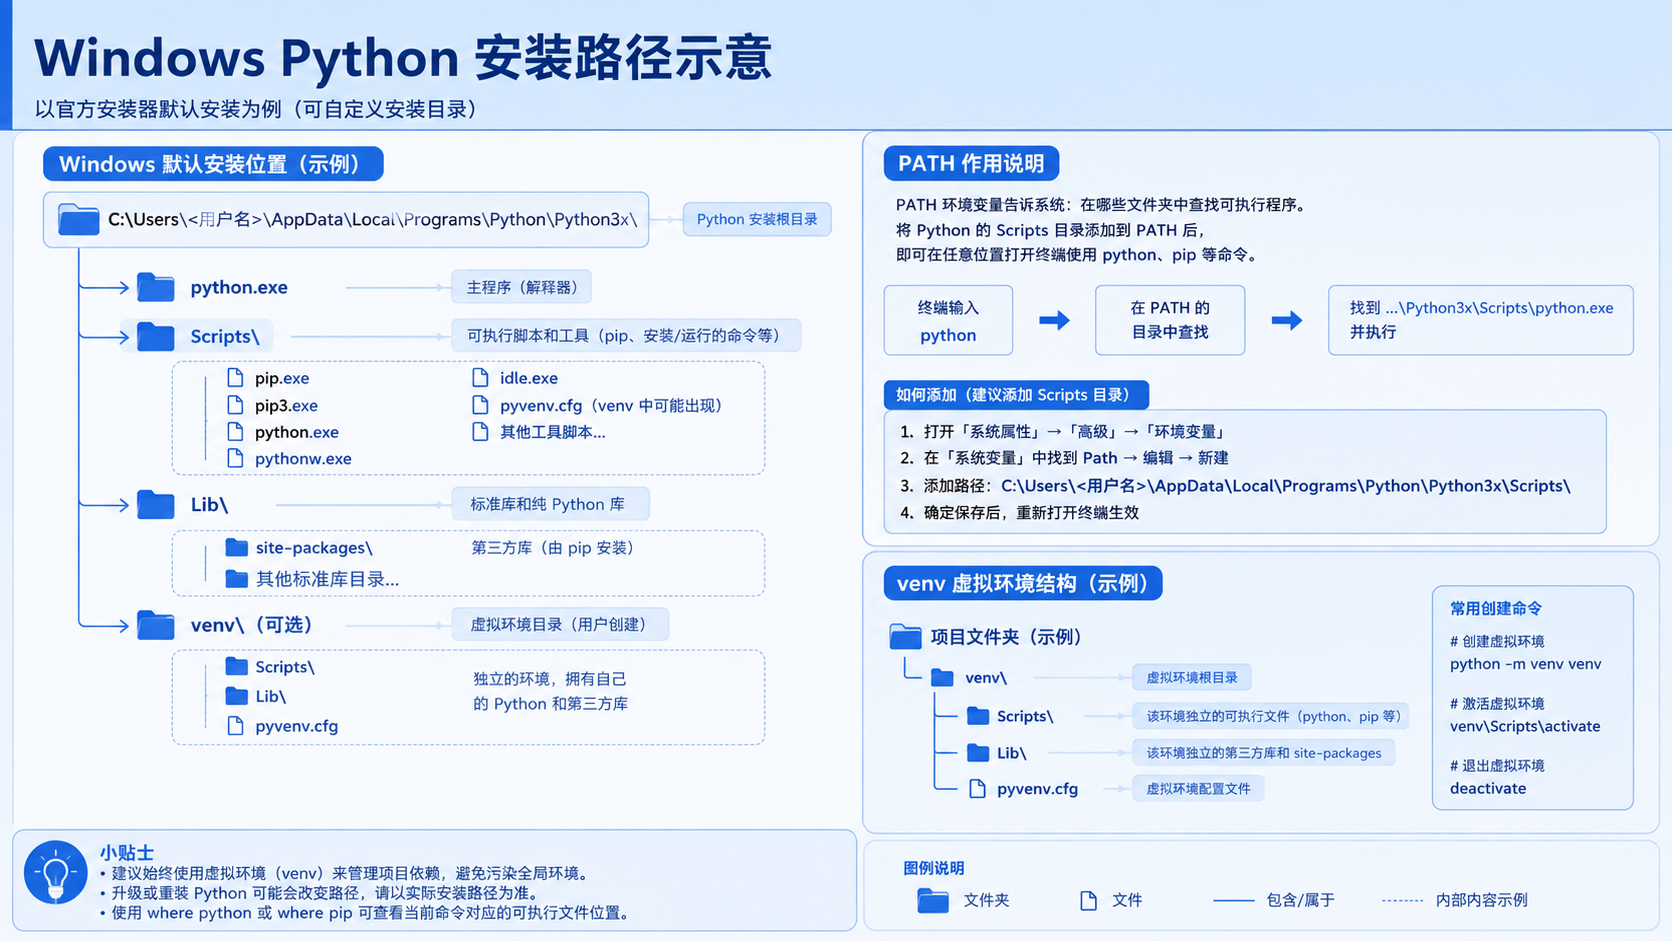
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
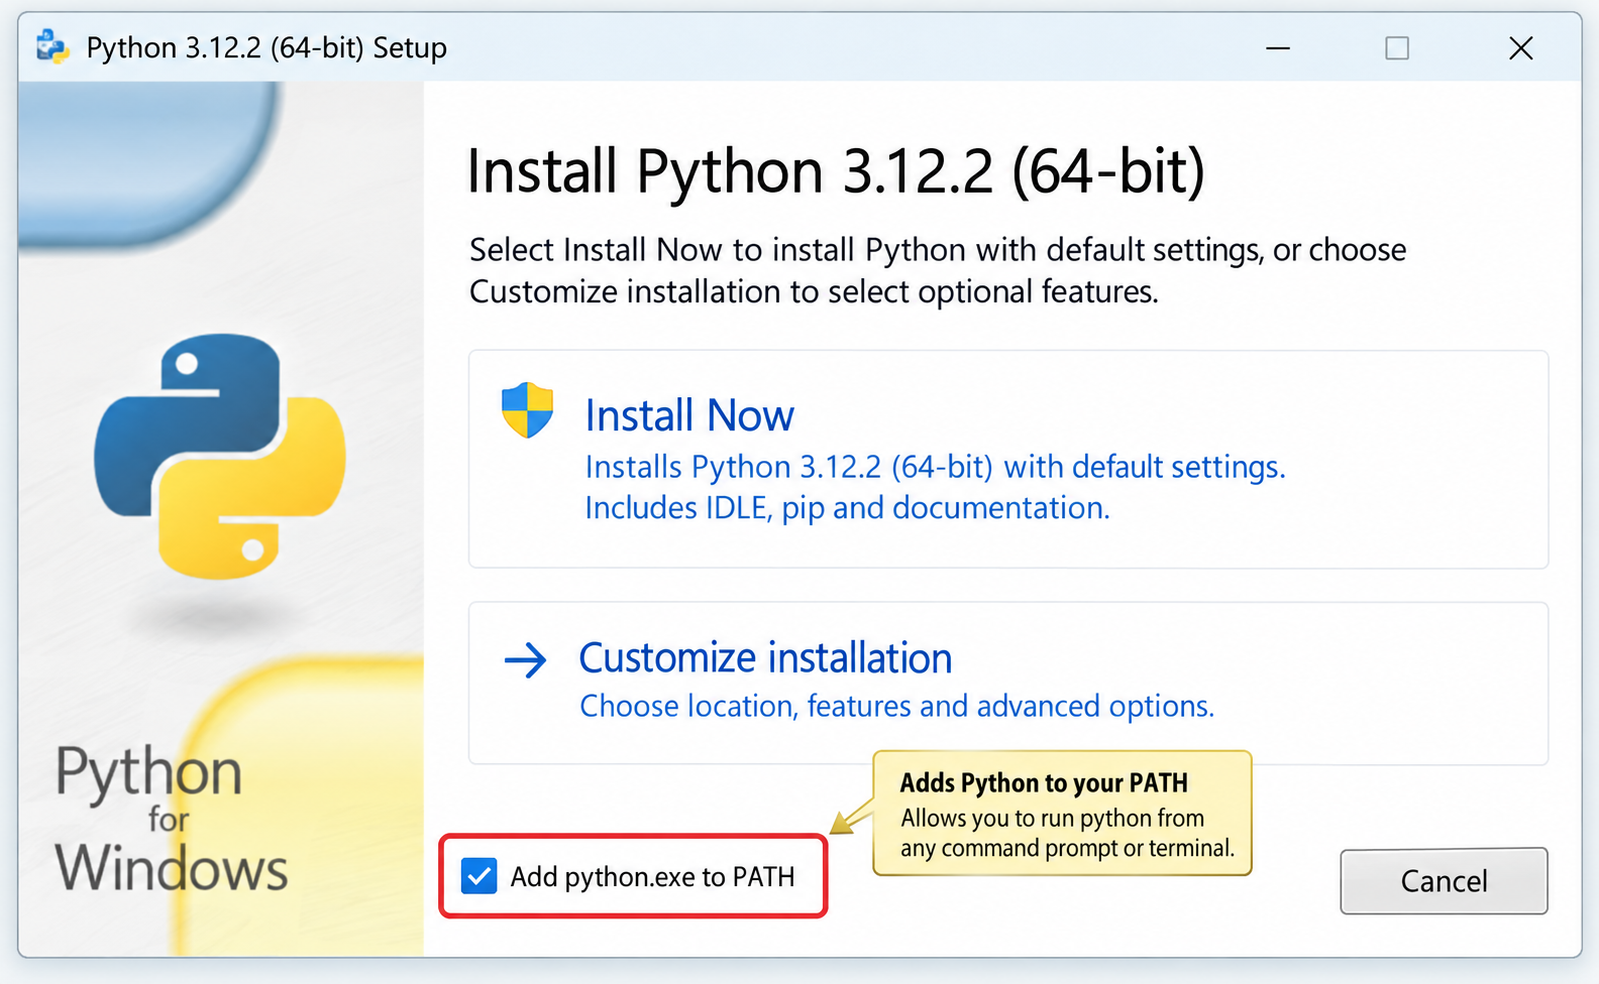
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
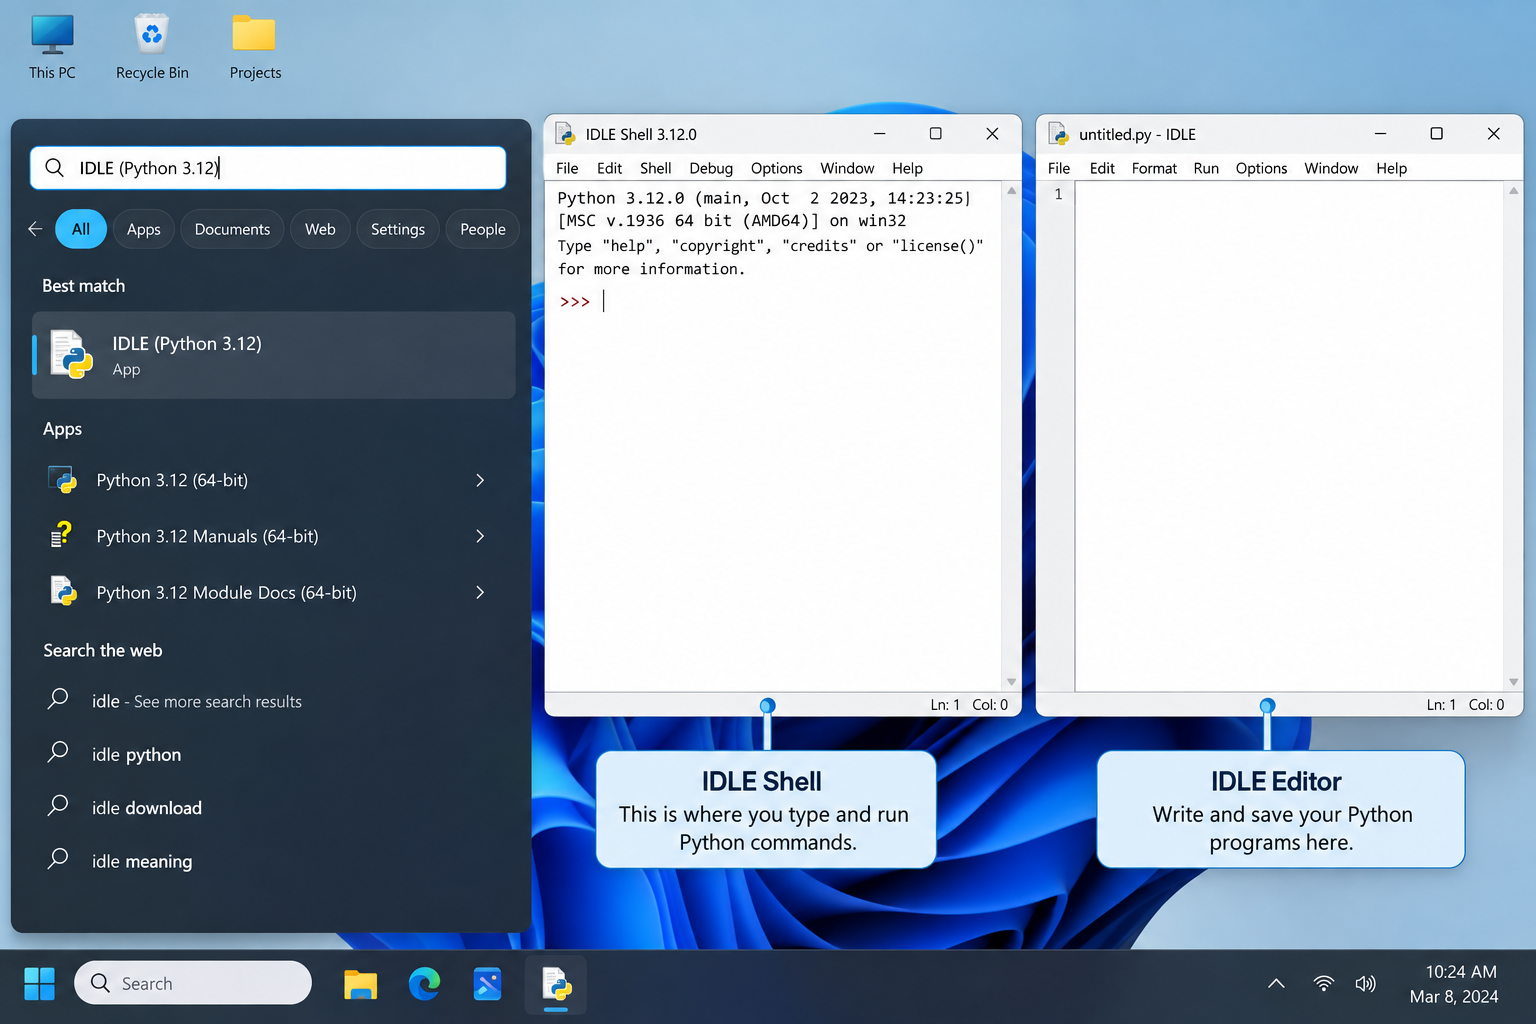
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
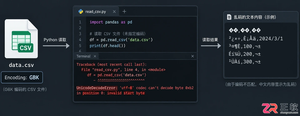
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
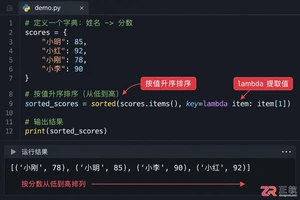
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
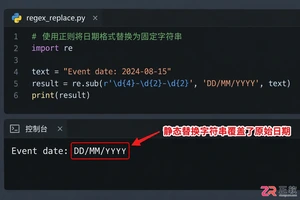
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
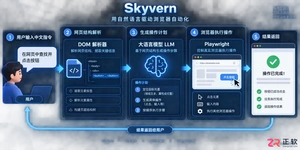
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。