

c++如何解析和生成JWT数据格式【进阶】
C++如何解析和生成JWT数据格式【进阶】 在C++项目中处理JWT,尤其是解析环节,常常会遇到一些看似简单却令人头疼的“坑”。很多开发者习惯性地将JWT的三段字符串直接丢给标准Base64解码器,结果往往就是报错和验证失败。今天,我们就来聊聊这些常见问题的根因和标准解法。 JWT 解析失败时 op
C++如何解析和生成JWT数据格式【进阶】
在C++项目中处理JWT,尤其是解析环节,常常会遇到一些看似简单却令人头疼的“坑”。很多开发者习惯性地将JWT的三段字符串直接丢给标准Base64解码器,结果往往就是报错和验证失败。今天,我们就来聊聊这些常见问题的根因和标准解法。
JWT 解析失败时 openssl 报错 “invalid base64” 怎么办
问题根源在于编码标准的不匹配。JWT规范要求其头部(header)、载荷(payload)和签名(signature)这三部分都采用URL-safe Base64编码。这种编码变体用短横线-和下划线_分别替换了标准Base64中的加号+和斜杠/,并且通常会省略填充符=。
而像OpenSSL的EVP_DecodeBlock这类标准库,它们只认传统的Base64字符集。直接把JWT的某一段原始字符串传给它,触发“invalid base64”错误也就不足为奇了。
所以,解码前的预处理是关键。这个预处理必须做两件事:还原字符和补全填充。一个常见的疏忽是只做了字符替换,却忘了处理填充长度。JWT每段的长度模4后,余数可能是0、2或3,必须按RFC 4648的规则补上等号:
- 长度 % 4 == 0 → 无需补充
- 长度 % 4 == 2 → 补充
== - 长度 % 4 == 3 → 补充
=
来看一个C++17的示例实现,思路就很清晰了:
std::string url_safe_b64_decode(const std::string& s) {
    std::string raw = s;
    // 第一步:还原字符
    std::replace(raw.begin(), raw.end(), '-', '+');
    std::replace(raw.begin(), raw.end(), '_', '/');
    // 第二步:按规则补足填充符
    switch (raw.length() % 4) {
        case 0: break;
        case 2: raw += "=="; break;
        case 3: raw += "="; break;
    }
    // 此时,raw才是标准Base64库能识别的字符串
    return raw;
}
经过这个函数处理后的字符串,才能交给OpenSSL或boost::beast::http::base64_decode进行解码。
用 openssl 验证 JWT signature 为什么总失败
签名验证失败,往往是因为复现签名生成的逻辑有偏差。这可不是简单地把两段字符串哈希一下再比对。正确的流程,是严格按照JWT签名生成时的步骤来一遍:
首先,获取经过URL-safe Base64编码(但未经解码)的头部和载荷字符串,用英文句点.连接起来。注意,这里说的连接是概念上的,用于形成待签名的消息。实际上,在调用HMAC或签名函数时,输入的是这两个字符串的原始字节流拼接,中间并不包含那个作为分隔符的.字符本身。这是RFC 7515明确规定的,也是容易混淆的第一个点。
其次,算法和密钥要匹配。HS256(HMAC SHA-256)使用的是原始的字节密钥;而RS256(RSA签名)则需要PEM格式的密钥对,用私钥签名,公钥验签。千万别把RSA私钥文件的内容当成字符串直接喂给HMAC函数。
最后,注意OpenSSL API的现代用法。旧的HMAC_CTX系列函数已经废弃,更推荐使用HMAC函数族。例如:
HMAC(EVP_sha256(), key, key_len, input, input_len, out, &out_len)
这里的input参数,指的就是前面拼接好的二进制数据,而不是Base64字符串。任何一个环节对不上,签名验证自然就通不过。
如何安全地解析 JWT payload 并提取 exp 字段防止越权
安全是JWT处理的生命线。一个致命的原则是:绝对不要在验证签名之前,就去解析载荷(payload)中的JSON内容。攻击者完全可以篡改exp(过期时间)、role(用户角色)等字段,如果程序先解析并相信了这些数据,防线就形同虚设了。
必须坚持“先验签,后解析”的铁律。即使验签通过,在解析payload时也要保持防御性编程的心态:
- 类型校验:像
exp、iat(签发时间)这样的字段,标准规定必须是JSON数字类型(numeric date),不能是字符串。解析时要用json::get这类方法强制转换为整型,并捕获可能发生的() json::type_error异常。 - 时间比对:获取当前Unix时间戳(秒级)时,要确保精度和时区处理正确。在C++中,可以使用
std::chrono::system_clock::now().time_since_epoch().count() / 1000000000来获取。用这个值与exp字段进行比较。 - 缺失处理:如果必要的字段(如
exp)缺失,应将整个JWT视为无效。
整个流程的顺序应该是固定的、不可逆的:分割JWT字符串 → 解码并检查头部 → 验证签名 → 解码并解析载荷 → 检查exp/iat/nbf等声明。
C++ 里该选哪个 JWT 库而不是重复造轮子
除非是在极度受限的环境(如无第三方库的嵌入式开发),否则,自己从头实现完整的JWT逻辑并非明智之举。选择一个成熟、活跃的库能省去大量麻烦。目前社区里比较靠谱的选择主要有两个:
cpp-jwt(GitHub:Thalhammer/cpp-jwt):这是一个以头文件为主的库,依赖OpenSSL和nlohmann/json。它支持HS、RS、ES等多种算法,API设计也比较清晰。不过需要注意,它不自动处理时钟偏移(clock skew),你需要自己为时间校验添加合理的宽容值(leeway)。jwt-cpp(GitHub:Thalhammer/jwt-cpp):请注意,这不是cpp-jwt的分支,而是一个独立的项目。它同样基于OpenSSL,但近期更加活跃,并且提供了一个validate类来方便地封装时间窗口、受众(audience)等声明的检查,对于新项目来说更值得推荐。
这里有几个避坑提示:尽量避免使用已经归档(archived)或长期无人维护的库,例如旧的jwtpp。这些库可能只支持到C++11,并且对JWK(JSON Web Key)、密钥轮换(key rotation)、ECDSA等现代特性的支持非常弱,在生产环境中容易因算法协商失败而导致服务不稳定。
最后,有一个最容易被忽略的事实:所有这些C++ JWT库,都只负责JWT本身的编码、解码和验证。它们并不内置HTTP能力。这意味着,从HTTP请求头中提取Token、实现Token的刷新逻辑、以及管理Token的存储(比如放在内存缓存还是Redis中),所有这些“外围”工作,都需要开发者自己来完成。很多时候,这部分基础设施的复杂度,甚至会超过JWT解析本身。
C++类构造与析构函数详解 C++这门语言,可以说是从C语言这棵大树上衍生出的高级果实,如今的应用普及度有目共睹。作为一种静态类型的通用编程语言,它厉害的地方在于融合了多种编程哲学——无论是传统的面向过程,还是主流的面向对象,乃至数据抽象、泛型编程这些高级概念,它都能很好地支持。正因为这份卓越的扩展
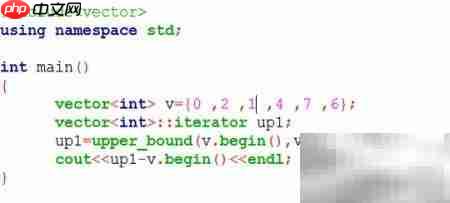
C++中std::upper_bound用法解析 在C++标准模板库(STL)的算法工具箱里,upper_bound() 绝对算得上是一把精准的“探针”。它的核心任务很明确:在一个已经排好序的区间 [first, last) 内,帮你快速定位到第一个**严格大于**指定值 value 的那个元素。这
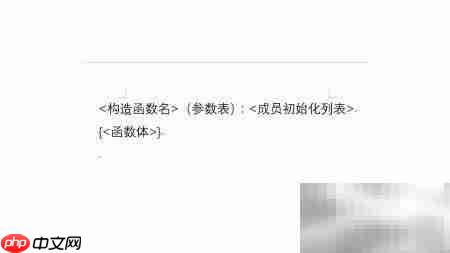
C++中“常”概念全景解析:从对象、成员到指针与引用 在C++的世界里,“常量性”是一个强大的保障机制。它不仅仅是一个const关键字那么简单,而是构建健壮、安全程序的重要基石。今天,我们就来系统梳理一下围绕“常”的一系列概念:常成员、常对象、常指针与常引用。理解它们,是写出高质量C++代码的关键一

命名空间的基本概念与常见引入问题在C++等编程语言中,命名空间(namespace)是一种将代码标识符(如变量、函数、类名)封装在特定名称下的机制,其主要目的是避免命名冲突,尤其是在大型项目或使用多个第三方库时。使用“using namespace”指令可以将指定命名空间中的所有名称引入当前作用域,

理解递归的基本原理在C语言中,递归是一种函数调用自身的编程技术。要掌握它,首先需要理解其核心思想:将一个复杂的大问题,分解为一个或几个与原问题相似但规模更小的子问题,直到子问题足够简单,可以直接求解。这个过程通常包含两个关键部分:递归出口和递归体。递归出口定义了问题何时不再继续分解,即最简单、可直接
递归函数的基本概念与适用场景在C语言编程中,递归是一种函数调用自身的编程技巧。它并非适用于所有问题,但在处理某些具有自相似结构的问题时,能提供极其清晰和优雅的解决方案。递归的核心思想是将一个大规模问题分解为一个或多个同类型但规模更小的子问题,直到子问题简单到可以直接求解。典型的适用场景包括树形结构的
理解内存管理的基石在Objective-C的编程世界中,内存管理是开发者必须掌握的核心技能之一。它直接关系到应用的性能、稳定性与资源利用效率。与一些采用自动垃圾回收机制的语言不同,Objective-C在很长一段时间里,依赖一套基于引用计数的、需要开发者部分介入的管理规则。这套规则的核心思想是明确的
理解 dealloc 的角色与时机在 iOS 应用开发中,内存管理是保障应用性能与稳定性的基石。dealloc 方法是 Objective-C 中对象生命周期结束时的关键回调,它标志着对象即将被系统回收内存。正确理解其触发时机至关重要:当一个对象的引用计数降为零时,运行时系统会自动调用该对象的 de
内存管理的基石在Objective-C的世界里,内存管理是开发者必须掌握的核心技能之一。作为一门在手动引用计数(MRC)时代诞生的语言,Objective-C要求程序员对对象的生命周期有清晰的认识。dealloc方法正是这一生命周期中至关重要的终点站。它是一个实例方法,当对象的引用计数降为零时,系统
native2ascii 工具的基本定位在Ja va应用程序的国际化与本地化开发过程中,处理非拉丁字符集是一个常见且关键的环节。Ja va内部使用Unicode字符集来统一表示全球各种语言的文字,但其属性文件(.properties)在历史上要求使用ASCII编码,或者更准确地说,要求非ASCII字






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
