

PHP新手选择AI模型成本考量【教程】
PHP调用AI API的真实成本取决于token预估、超时设置、并发控制和缓存策略;须用官方tokenizer精确计数,cURL设超时与错误检查,批量请求优化,并启用Redis/APCu缓存命中关键路径。 对于PHP开发者而言,一个常见的误解是认为成本主要取决于选择了哪个AI模型。实际上,PHP本身
PHP调用AI API的真实成本取决于token预估、超时设置、并发控制和缓存策略;须用官方tokenizer精确计数,cURL设超时与错误检查,批量请求优化,并启用Redis/APCu缓存命中关键路径。
对于PHP开发者而言,一个常见的误解是认为成本主要取决于选择了哪个AI模型。实际上,PHP本身并不训练模型,也不负责推理计算,它更像是一个“调度员”或“联络官”。真正的开销大头,往往隐藏在API调用策略、token消耗的精细计算、并发控制以及错误处理机制之中。如果选错了调用方式,或者忽略了这些底层细节,成本翻倍甚至失控,绝非危言耸听。
怎么算清一次请求的真实 cost?别只看单价
首先,必须澄清一个关键点:中文文本的token数量,远非简单的strlen()或mb_strlen()函数可以估算。一个200字的中文段落,实际消耗的token数很可能超过300个。只有使用官方提供的tokenizer工具(例如OpenAI的tiktoken)进行预计算,得出的数字才具备参考价值。依赖字符长度估算,最终只会导致预算被严重低估。
- 精确预估是第一步:务必在PHP环境之外,使用官方tokenizer库进行预判。或者,在发起正式的
/v1/chat/completions请求前,先调用像/v1/embeddings(使用model=text-embedding-ada-002这类低成本模型)这样的端点来预检token消耗。 - 输入输出都要计费:在摘要、问答、内容审核等场景中,计费涵盖输入文本和AI生成的输出文本两部分。
max_tokens参数设置过小会导致回答被截断,设置过大则意味着为未使用的额度白白付费。 - 警惕会话成本膨胀:使用支持历史上下文的对话接口(例如
gpt-3.5-turbo)时,每一轮对话都会额外增加约50–100个token的管理开销。长会话的成本会呈指数级上升,这一点需要特别留意。
cURL 不设超时,等于给账单开后门
网络请求配置是成本控制的隐形战场。如果在使用cURL发起请求时,没有正确配置CURLOPT_TIMEOUT(总超时)和CURLOPT_CONNECTTIMEOUT(连接超时),一旦AI服务响应缓慢或完全卡住,PHP进程就会无限期挂起等待。这不仅会拖垮服务器并发能力,对于按使用时长计费(尤其是流式响应接口)的服务来说,更是在持续浪费资金。
- 推荐配置值:将
CURLOPT_TIMEOUT设置为15秒(包含网络传输和AI处理时间),CURLOPT_CONNECTTIMEOUT设置为5秒,这在多数场景下是一个平衡点。 - 错误检查不可或缺:必须配合设置
CURLOPT_FAILONERROR => true,并在代码中检查HTTP状态码。否则,像429(请求过多)、503(服务不可用)这类错误响应可能会被当作成功结果处理,导致重复请求和计费。 - 避免使用简单函数:不要贪图方便使用
file_get_contents()函数,它既无法灵活控制超时,也难以设置请求头中的Authorization等认证字段。
批量请求不是“多发几次”,而是结构重设计
面对大量处理任务,低效的做法是使用循环逐条调用curl_exec()。例如,处理100条文本摘要,这种方式耗时可能超过10秒,且极易触发API的频率限制。高效的做法是进行结构重构:如果服务商支持,将多条文本整合进一个batch参数中一次性发送;或者,使用GuzzleHttp库的Pool功能进行可控的并发请求。通过这类优化,成本有望压缩至原来的30%甚至更低。
- 了解服务商能力:目前,OpenAI的聊天接口并不原生支持批量文本输入,但像Hugging Face的Inference API等服务支持以
inputs: ["...", "..."]数组格式提交批量请求。 - 批量前的自检:在自行将多条数据拼接成JSON数组发送前,务必计算总token数是否超过模型上限(例如
gpt-3.5-turbo通常为16k token)。 - 并发数需谨慎:并发请求数并非越高越好。如果PHP-FPM工作进程数乘以单进程并发连接数,超过了后端API的速率限制,立刻就会收到429错误。建议从较低的并发数(如3-5)开始测试,并密切关注响应头中的
X-RateLimit-Remaining字段。
缓存不是可选项,是成本防火墙
业务中是否存在相同问题被反复提问、同类文档需要反复摘要、固定提示词模板被频繁使用的情况?如果答案是肯定的,那么不加缓存机制,就等于在重复计算上持续烧钱。缓存在这里扮演的是“成本防火墙”的角色。
立即学习“PHP免费学习笔记(深入)”;
- 实施缓存策略:可以使用
md5($prompt . $input_text)生成唯一键,将AI响应结果存储到Redis或APCu中。根据业务特点设置合理的TTL(生存时间),例如1小时,通常能覆盖大部分热点数据的生命周期。 - 注意数据安全:绝对禁止缓存包含用户敏感隐私信息(如身份证号、手机号,即使脱敏后)的请求和响应。必须在哈希生成缓存键之前,对数据进行清洗或脱敏处理。
- 监控与分析:当请求命中缓存时,直接返回结果,跳过昂贵的API调用。同时,务必在日志中记录
cache_hit: true等信息,这有助于后续分析哪些类型的提示词(Prompt)消耗了最多的预算,从而进行针对性优化。
说到底,真实成本的波动往往不取决于模型名称是否带有“-turbo”或“-preview”后缀,而是深藏在并发策略的优劣、token预估的偏差以及缓存机制的漏洞里。越早将精细化的curl_setopt()配置和tokenizer预检流程整合到日常开发规范中,就越能避免在某天面对账单时措手不及。这才是成本可控的关键所在。
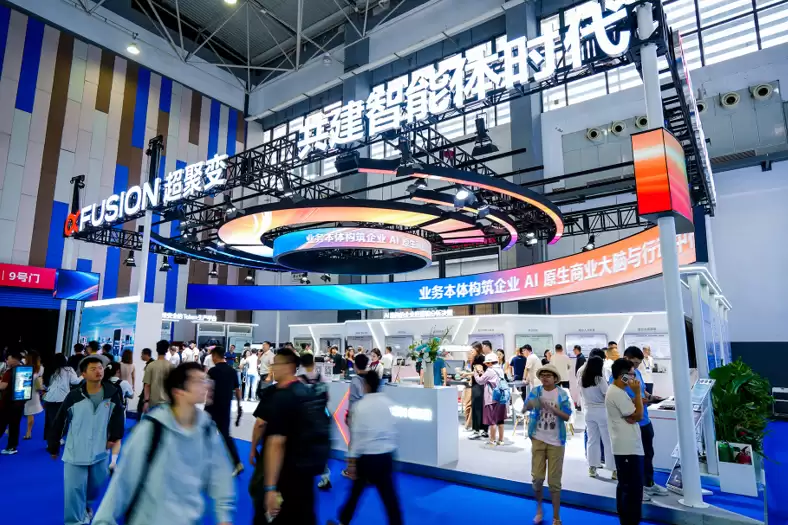
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。

从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
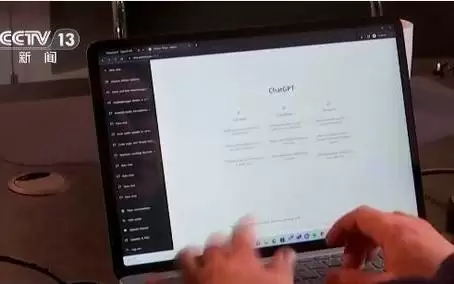
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
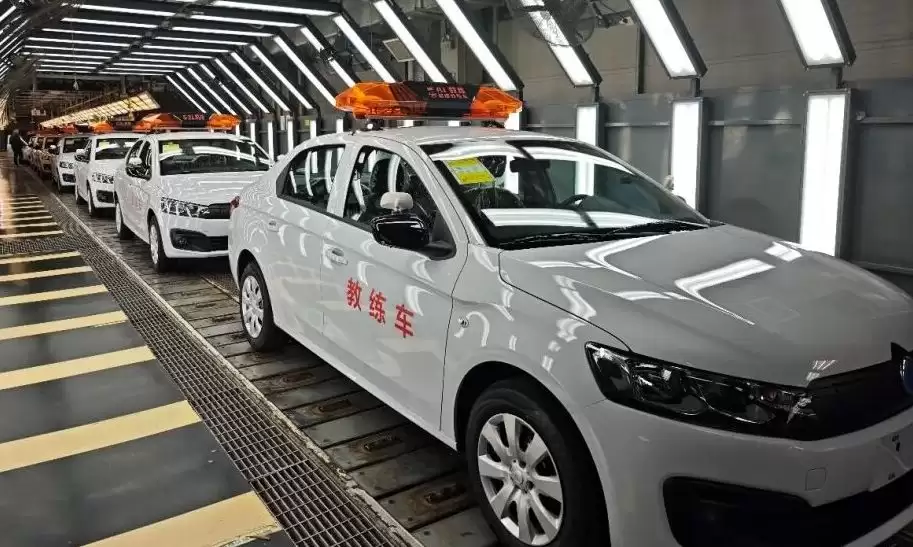
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
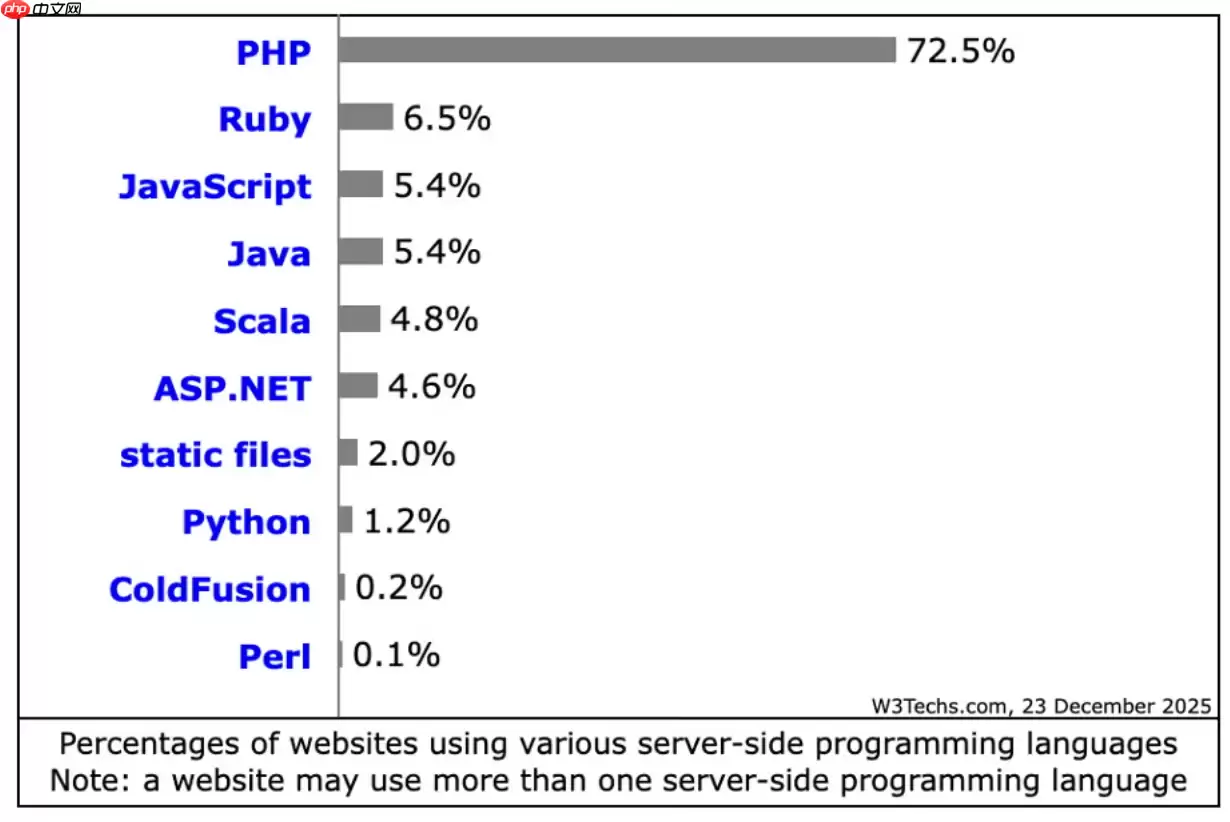
PHP在2026年仍适用于现代网站构建,在常规Web服务和内容密集型站点中较Python、Java等保持优势。其JIT编译优化性能,安全补丁及时,全面支持云原生,拥有成熟框架生态,整体成本较低。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
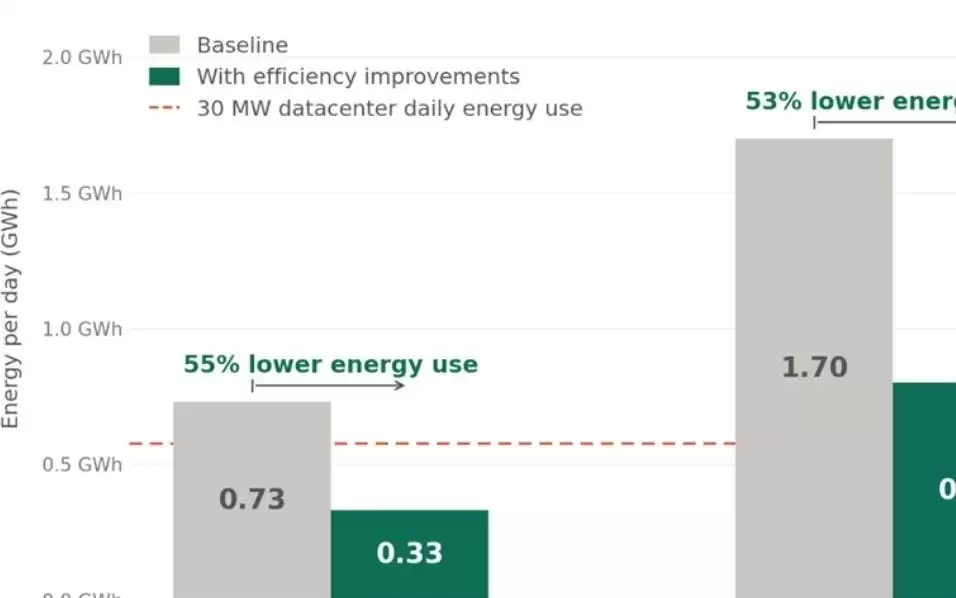
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
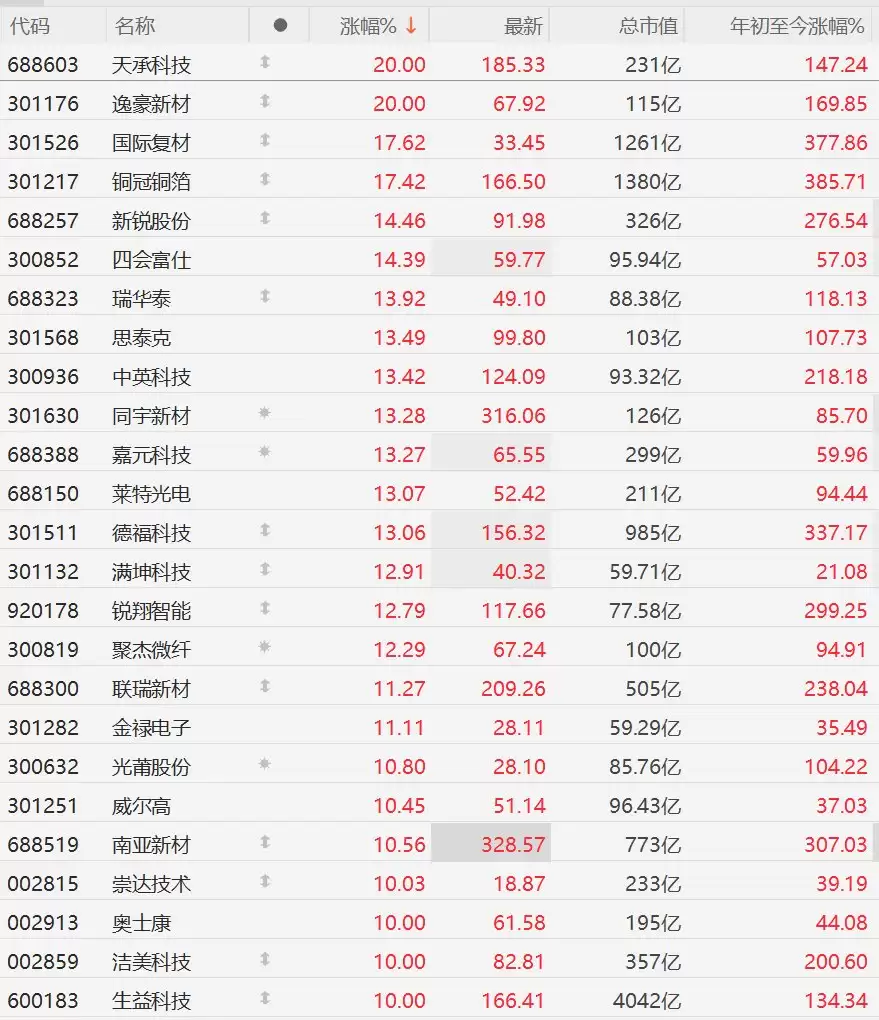
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
