

C++应用在CentOS如何监控
C++应用在 CentOS 的监控实践 一 系统层监控 想要摸清一个C++应用在CentOS上的运行状况,系统层的监控是第一步,也是最直观的一步。这就像给应用做一次全面的“体检”,从CPU、内存到磁盘I/O,各项指标一目了然。 实时与多维资源查看 工欲善其事,必先利其器。CentOS生态里有一系列经
C++应用在 CentOS 的监控实践
一 系统层监控
想要摸清一个C++应用在CentOS上的运行状况,系统层的监控是第一步,也是最直观的一步。这就像给应用做一次全面的“体检”,从CPU、内存到磁盘I/O,各项指标一目了然。
实时与多维资源查看
工欲善其事,必先利其器。CentOS生态里有一系列经典工具,能帮你从不同维度透视系统状态:
- top/htop:这是观察进程动态的“仪表盘”,可以实时查看进程的CPU、内存占用以及线程情况。想只看你的应用?用
top -p $(pidof your_app)或 htop 的过滤功能即可。 - vmstat:它提供的是系统级的综合快照,涵盖进程、内存、CPU、I/O等核心指标,命令
vmstat 1 10表示每隔1秒采样一次,共10次。 - iostat:当怀疑瓶颈在磁盘时,它就是你的放大镜。带上
-x参数,可以查看更详细的扩展统计信息,例如iostat -x 1 10。 - sar:来自 sysstat 工具包,堪称系统活动的“历史学家”。不仅能看实时数据,还能回溯历史,分析趋势。例如,
sar -u -r -b 1 60会连续60秒,每秒采集一次CPU、内存和I/O的使用情况。 - dstat:一个整合了 vmstat、iostat、netstat 等多类信息的“瑞士军刀”,彩色输出,一目了然。试试
dstat -c -m -d -n来同时监控CPU、内存、磁盘和网络。 - nmon:提供了交互式界面,操作简单,还支持将数据导出为CSV格式,方便后续分析。启动命令
nmon -f -s 5 -c 12会以后台模式运行,每5秒采样一次,共采样12次。 - Glances:一个跨平台的现代化监控工具,通过一个简洁的界面,集成了大量系统信息,对新手非常友好,直接输入
glances即可。
安装与快速上手
大部分工具都可以通过Yum包管理器一键安装:
sudo yum install -y sysstat htop nmon dstat glances
安装好后,就可以用上面提到的命令示例开始你的监控之旅了。
使用要点
看数据不能只看热闹,更要看门道。需要重点关注以下几类关键指标,并结合业务实际情况设定合理的告警阈值:
- CPU:用户态和系统态的使用率是否过高?是否存在大量等待I/O的CPU时间(wa%)?
- 内存:关注实际占用物理内存的RSS和虚拟内存大小的VSZ。内存使用率是否持续增长?
- 文件描述符:应用打开的文件描述符数量是否接近
ulimit -n设置的系统限制? - 磁盘I/O:重点关注
await(I/O请求平均等待时间)是否飙升,以及rrqm/s(每秒合并的读请求数)等指标。 - 网络:吞吐量是否正常?是否存在异常丢包或重传?
二 应用性能剖析
系统监控告诉你“哪里不对劲”,而性能剖析则要深入代码内部,找出“为什么不对劲”的根源。
perf 采样分析
perf 是基于Linux内核性能子系统的强大工具,利用硬件性能计数器,可以以极低的开销定位到热点函数、缓存命中率、分支预测失败等底层瓶颈。
- 记录性能数据:
sudo perf record -g -p $(pidof your_app) -o perf.data sleep 30这条命令会监控指定进程30秒,并记录调用图(-g)信息到 perf.data 文件。 - 生成文本报告:
perf report -n --stdio可以生成一个详细的函数耗时排名报告。 - 生成火焰图:这是可视化性能瓶颈的神器。流程通常是:
perf script | stackcollapse-perf.pl | flamegraph.pl > flame.svg。生成的SVG图片可以直观展示函数调用栈和耗时比例。
gprof 插桩分析
gprof 是一种编译时插桩的分析工具,适合对单线程程序或进行初步的性能分析。它能统计每个函数的调用次数和耗时。
- 使用方法:编译时加上
-pg选项:g++ -pg -O2 app.cpp -o app。运行程序后,会生成 gmon.out 文件,再通过gprof app gmon.out > report.txt生成分析报告。
Valgrind 内存与缓存分析
Valgrind 是一个重量级但极其有用的工具集,尤其擅长发现内存问题。
- Memcheck:用于检测内存泄漏、越界访问、使用未初始化内存等问题。命令如:
valgrind --tool=memcheck --leak-check=full ./your_app。 - Cachegrind/Callgrind:用于分析CPU缓存命中率和函数调用关系。
- 重要提示:Valgrind 会通过模拟CPU来工作,因此会显著降低程序运行速度(通常慢10-20倍)。它更适合在测试或问题定位阶段使用,不建议在线上性能压测时使用。
编译器与构建优化
监控和剖析是为了优化。在构建发布版本时,合理的编译器选项能直接提升性能:
- 使用
-O2或-O3进行优化。 - 使用
-march=native生成针对当前CPU架构的最佳指令集。 - 使用
-flto(链接时优化)进行跨模块优化。 - 对于需要调试或剖析的版本,务必加上
-g选项以保留调试符号,否则看到的将是难以理解的地址信息。
三 内存与资源泄漏定位
对于C++程序,内存泄漏是“隐形杀手”。除了Valgrind,还有更高效的长期监测方案。
Valgrind Memcheck
这是定位内存泄漏的“金标准”。它会将泄漏分类为“明确丢失”、“间接丢失”、“可能丢失”等,并给出完整的调用栈,让修复工作有的放矢。
- 示例:
valgrind --leak-check=full --log-file=valgrind.log ./your_app
gperftools(tcmalloc + heap profiler)
来自Google的性能工具集,更适合需要长时间运行的服务。
- tcmalloc:替代系统默认的malloc,提供更高效的内存分配和线程本地缓存,本身就能提升性能。
- heap profiler:可以在运行时动态开启堆内存剖析,检测内存泄漏和查看内存分配热点。
- 使用示例:
- 编译链接:
g++ app.cpp -ltcmalloc -o app - 运行并开启剖析:
HEAPPROFILE=/tmp/heapprof ./app(程序会定期生成heap文件) - 分析报告:
pprof --text ./app /tmp/heapprof.0001.heap
- 编译链接:
代码层埋点与资源统计
最好的监控是预防。在代码层面做好以下工作,能极大提升可观测性:
- RAII(资源获取即初始化):利用C++对象生命周期自动管理资源(文件句柄、锁、内存等),这是避免泄漏的基石。
- 高精度计时:在关键代码路径使用
std::chrono进行打点,量化性能。 - 结构化日志:集成 spdlog、log4cpp 等日志库,输出带请求ID、耗时、错误码的JSON格式日志。务必配置日志轮转策略,防止日志文件占满磁盘。
四 运行稳定性与自愈
监控的终极目标之一是保障服务稳定。进程意外退出时,能自动恢复是基本要求。
进程守护与自动拉起
首选方案:systemd
在现代CentOS系统中,使用systemd管理服务是标准且强大的方式。
- 创建服务文件
/etc/systemd/system/your_app.service:
[Unit]
Description=Your C++ App
After=network.target

[Service]
ExecStart=/usr/local/bin/your_app
Restart=always
User=appuser

[Install]
WantedBy=multi-user.target
- 启用并启动服务:
sudo systemctl daemon-reload
sudo systemctl enable --now your_app
这样,当进程异常退出时,systemd会自动将其拉起(Restart=always)。
备用方案:Shell守护脚本
在没有systemd的环境下,可以编写一个简单的Shell监控脚本,结合cron定时任务来检测和拉起进程。需要注意的是,在脚本中通过ps或pgrep查找进程时,要小心过滤掉脚本自身的进程,并且所有路径都应使用绝对路径。
五 监控落地与告警建议
将零散的监控点串联成体系,并设置合理的告警,才能真正发挥价值。
指标与阈值示例
以下是一些通用的关键监控项与阈值建议,可根据实际情况调整:
- 进程存活:进程不存在即为严重告警,需立即处理。
- CPU使用率:持续超过80%可视为警告,持续超过90%则为严重告警,需排查计算瓶颈或无限循环。
- 内存占用(RSS):持续接近容器或系统内存上限,或超过预设阈值的80%,触发警告。
- 文件描述符数量:接近
ulimit -n设置的系统软限制时,触发警告。 - 磁盘:磁盘I/O等待时间(await)明显升高,或磁盘空间使用率超过85%,触发警告。
- 网络:出现异常的丢包率、重传率,或带宽出现不符合规律的突增,需要关注。
采集与可视化
- 短期深度排查:优先使用 perf、Valgrind、gperftools 等工具,获取函数级、代码行的细粒度性能数据。
- 长期趋势观测:利用 sar、nmon 收集历史数据,并集成到 Grafana + Prometheus 或 Zabbix 等监控平台中,配置丰富的图表和灵活的阈值告警规则。
日志与追踪
- 推行结构化日志(如JSON格式),便于后续使用ELK(Elasticsearch, Logstash, Kibana)等工具进行聚合分析和故障排查。
- 在关键的业务和代码路径进行打点,记录耗时和状态。
- 建立规范的日志轮转与归档机制,平衡问题排查需要和存储成本。
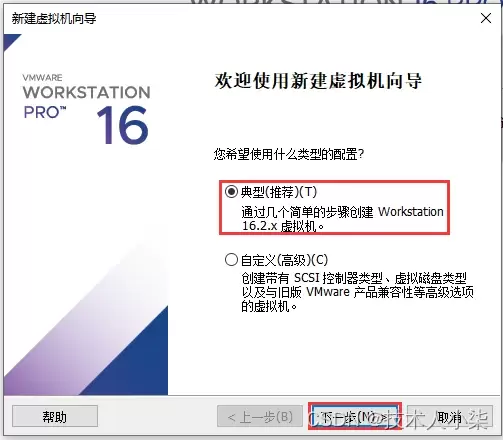
本文详细讲解如何在VMware Workstation中从零开始安装CentOS 7虚拟机。内容涵盖ISO镜像准备、典型配置创建、硬件参数分配(磁盘与内存)、安装器操作及首次启动后的版本与网络验证。通过规范化的步骤指引,帮助读者快速搭建稳定可用的Linux学习环境,并解决常见的启动与网络故障。
Linux系统管理员密码的终极恢复方案:详解救援模式 在服务器运维的世界里,Linux系统的霸主地位毋庸置疑。不过,无论是资深管理员还是新手,都可能遇到一个尴尬又紧急的状况:系统管理员密码意外丢失。别慌,一个强大却常被忽视的内置“后门”——系统救援模式——就能派上用场。它不仅能重设密码,更像是系统故

命名空间的基本概念与常见引入问题在C++等编程语言中,命名空间(namespace)是一种将代码标识符(如变量、函数、类名)封装在特定名称下的机制,其主要目的是避免命名冲突,尤其是在大型项目或使用多个第三方库时。使用“using namespace”指令可以将指定命名空间中的所有名称引入当前作用域,

理解递归的基本原理在C语言中,递归是一种函数调用自身的编程技术。要掌握它,首先需要理解其核心思想:将一个复杂的大问题,分解为一个或几个与原问题相似但规模更小的子问题,直到子问题足够简单,可以直接求解。这个过程通常包含两个关键部分:递归出口和递归体。递归出口定义了问题何时不再继续分解,即最简单、可直接
递归函数的基本概念与适用场景在C语言编程中,递归是一种函数调用自身的编程技巧。它并非适用于所有问题,但在处理某些具有自相似结构的问题时,能提供极其清晰和优雅的解决方案。递归的核心思想是将一个大规模问题分解为一个或多个同类型但规模更小的子问题,直到子问题简单到可以直接求解。典型的适用场景包括树形结构的
理解内存管理的基石在Objective-C的编程世界中,内存管理是开发者必须掌握的核心技能之一。它直接关系到应用的性能、稳定性与资源利用效率。与一些采用自动垃圾回收机制的语言不同,Objective-C在很长一段时间里,依赖一套基于引用计数的、需要开发者部分介入的管理规则。这套规则的核心思想是明确的
理解 dealloc 的角色与时机在 iOS 应用开发中,内存管理是保障应用性能与稳定性的基石。dealloc 方法是 Objective-C 中对象生命周期结束时的关键回调,它标志着对象即将被系统回收内存。正确理解其触发时机至关重要:当一个对象的引用计数降为零时,运行时系统会自动调用该对象的 de
内存管理的基石在Objective-C的世界里,内存管理是开发者必须掌握的核心技能之一。作为一门在手动引用计数(MRC)时代诞生的语言,Objective-C要求程序员对对象的生命周期有清晰的认识。dealloc方法正是这一生命周期中至关重要的终点站。它是一个实例方法,当对象的引用计数降为零时,系统
native2ascii 工具的基本定位在Ja va应用程序的国际化与本地化开发过程中,处理非拉丁字符集是一个常见且关键的环节。Ja va内部使用Unicode字符集来统一表示全球各种语言的文字,但其属性文件(.properties)在历史上要求使用ASCII编码,或者更准确地说,要求非ASCII字
理解 native2ascii 工具的基本用途在软件开发,特别是涉及国际化处理的场景中,开发者常常需要处理不同编码的文本资源。native2ascii 是 Ja va 开发工具包(JDK)中提供的一个命令行实用程序,其主要功能是将包含本地字符编码(非ASCII字符)的文件,转换为包含 Unicode






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
