

Skill的本质不就是提示词?吹什么?
当我们谈论大模型生态中的“Skill”或“自定义指令”时,一个最常见的质疑就是:这不就是一段高级点的提示词吗?技术含量在哪?今天,我们不谈噱头,从模型的工作原理和工程实践两个层面,把这件事掰开揉碎了讲。 1. 模型的视角:没有“技能”,只有“提示” 理解Skill,必须从大模型本身如何看待它开始。一
当我们谈论大模型生态中的“Skill”或“自定义指令”时,一个最常见的质疑就是:这不就是一段高级点的提示词吗?技术含量在哪?今天,我们不谈噱头,从模型的工作原理和工程实践两个层面,把这件事掰开揉碎了讲。
1. 模型的视角:没有“技能”,只有“提示”
理解Skill,必须从大模型本身如何看待它开始。一个根本的、也是最重要的前提是:模型压根没有“Skill”或“模式切换”的概念。
举个例子,比如一个名为「首席蒸馏官」的Skill文件,里面可能包含了398行的Markdown文本,详细定义了身份、工作流和规范。但当这个Skill被加载时,底层发生的事情极其朴素:这398行文本被完整地塞进了模型的“上下文窗口”(context window)里,变成了一串连续的token序列。然后,就没有然后了。
大模型内部不存在一个独立的“Skill执行引擎”。它不会识别到“哦,我现在加载了蒸馏官模式,应该切换到另一套逻辑”。模型处理这些token的方式,与处理你手动输入的“帮我写个总结”这句话,在原理上没有任何区别。对于Transformer架构而言,这些token没有标签,没有内置的优先级,也没有所谓“系统指令必须优先遵守”的硬编码标记。
那么,模型为何还会遵循Skill里的指令?根源在于训练。尤其是在RLHF(基于人类反馈的强化学习)阶段,模型被海量数据训练出了一个固定的模式:当对话开头出现类似系统提示的格式化文本时,后续的生成内容应该尽可能地遵循这些指令。实际上,同样一段指令,用“系统提示”格式发送,与用“用户消息”格式发送,模型的遵循程度确有差异,这正是因为训练数据中这两种位置的指令遵循率存在统计上的偏差。
所以,从纯模型推理的视角来看,第一个技术事实非常明确:Skill就是一段占据上下文窗口前段位置的提示词。它的效力来源于训练形成的条件反射,并通过Self-Attention机制,持续影响后续每一个token的生成概率。如果你有足够的token预算,把同样的内容直接粘贴进对话框,效果也八九不离十。
2. 控制的机制:不是“执行”,而是“牵引”
既然本质是提示词,那么一段Skill文本到底是如何具体控制模型输出的呢?这得拆解Transformer生成下一个token的过程来看,可以简化为四个核心步骤。
第一步是分词。Skill的所有文本会被切分成一个个token。一个复杂臃肿的Skill可能占据数千个token,这些token直接消耗掉模型宝贵的工作记忆容量。很多人在设计初期容易犯的错误,就是想把所有细节都塞进去,结果输出质量不升反降。原因就在这里:臃肿的Skill会挤占留给用户问题和模型思考的空间,写得多是有代价的。
第二步是位置编码。当前主流的RoPE编码有个特性:距离当前生成位置越近的token,在注意力计算中的关联权重天然越高。Skill文本位于序列的最前端,随着对话轮数增加,Skill指令与当前生成位置的距离会被拉远,其影响力随之被稀释。这就是为什么在长对话的后期,模型经常会“忘记”你最初设定的人设或规则。
第三步是自注意力计算,这是核心中的核心。模型在生成下一个字时,会“回头看”前面所有的字,但并非一视同仁,而是有选择地重点关注某些字。哪些字会被重点关注?答案是那些与当前生成任务在语义上高度相关、信息密度高的token。像“请产出高质量内容”这样的空洞指令,与任何具体任务的相关性都很低,因此几乎分不到什么注意力权重,写了等于白写。
第四步是输出概率。最后一层Transformer会输出一个巨大的概率分布。Skill里如果写明“不使用感叹号”,会发生什么?模型在训练中学过,否定指令对应的目标token概率应被抑制,因此“!”这个token对应的输出分数会被压低。
但这里有个反直觉的点:模型为了理解“不使用感叹号”这个指令,首先需要“注意”到“感叹号”这三个字,这反而在某种程度上激活了与感叹号相关的神经表征。这就是为什么纯粹的否定式指令往往效果不佳,你说“别写感叹号”,有时反而提醒了模型感叹号的存在。
把这四步串联起来,就能得出一个关键洞察:Skill并非被“执行”,它起到的是一种“引力场”的作用。它通过自身token在注意力计算中的持续存在,微妙地拉拽着后续生成token的概率分布,让输出朝期望的方向偏移。因此,设计Skill的本质,是在设计这个引力场的形状与强度。
3. 生态的价值:区别在模型“之外”
如果只看输入模型的部分,Skill和一段手写的复杂提示词确实没有区别。真正的价值增量,发生在模型外部,体现在工程化和可管理性上。
还是以「首席蒸馏官」Skill为例。打开它的文件,除了核心的Markdown指令,你还会看到类似这样的YAML元数据:
name: “首席蒸馏官”
version: “2.0.0”
triggers: [“蒸馏”, “CDO”, “帮我蒸馏”]
allowed-tools: [Read, Write, WebFetch, Edit, Bash]
这部分内容,根本不会进入模型的上下文窗口。它们是给运行模型的“智能体”或“中间件”看的,负责处理一系列工程问题:什么时候自动加载这个Skill?加载后模型允许调用哪些工具?如何进行版本管理和更新?
这就好比一段Ja vaScript代码能在V8引擎中运行,但当你把它打包成npm包时,增加的package.json文件、入口声明、依赖管理等,不是给V8看的,而是给整个Node.js生态看的。引擎只认代码,生态需要元数据。
Skill相比纯提示词多出来的东西,可以拆解为:
触发路由机制:实现按需加载,避免长期无效占用上下文。
权限边界声明:限制加载后模型能调用的工具,保障安全。
模块化结构:支持大型Skill的懒加载,提升效率。
标准化元数据:包括名称、版本、标签,使得Skill可以被索引、发现、分享和版本控制。
这些功能的共同点在于,它们在模型之外运行,解决的是规模化、安全性和可维护性的问题。模型本身并不会因为这种封装而变得更聪明,但你的工作流会因此变得高度可控、易于协作。
4. 实操指南:如何写好一个有效的Skill
理解了底层原理,实操层面的要诀就顺理成章了。以下几点是经过大量实践验证的经验总结:
信息密度是最高准则。每个token都在燃烧宝贵的上下文预算。诸如“你是一个专业的、认真的、高质量的内容生产者”这样的描述,浪费了20个token说了一句模型无法具体理解的废话。什么是专业?高质量指什么?模型没有概念。有效的做法是转化为具体、可校验的指令,例如:“## 输出格式要求:1. 必须有三级标题;2. 核心论点分点阐述;3. 关键数据加粗。” 一个清晰的好示例,胜过十段抽象的描述,因为它直接提供了模型可以延续的文本模式。
善用Markdown的结构力量。模型在预训练时见过海量的Markdown文档,结构本身就承载着语义。用“##”标记的标题、用“-”开头的列表、用“>”包裹的引用块,这些模式已被深度编码进模型参数中。在注意力计算时,这些结构化的内容天然容易获得更高的权重。因此,关键规则用标题突出,枚举项用列表,示例用引用块,遵循率远高于一坨无结构的纯文本段落。
精心设计首次触发语。自回归模型有一个显著特性:第一个输出token的选择,会强烈地影响后续所有token的生成走向。当模型要说出第一句话时,Skill中为首次触发预设的文本是它最近的参考模板。例如,“我是首席蒸馏官,专注知识提炼”锚定的是冷静、专业的调性。如果写成“哈喽!很高兴见到你!有什么可以帮你的吗?”,那么整场对话的基调都会被拉向活泼甚至浮夸,因为模型会自我强化这个初始风格。
否定指令需搭配正面引导。如前所述,单纯的“不要用感叹号”可能适得其反。更优的策略是“正面引导+否定约束+正确示例”三层加固:先说明“句末使用句号”,再补充“禁止使用感叹号”,最后给出一句符合要求的例句。这种组合拳的效果,远胜于单一的禁止命令。
大Skill必须支持模块化懒加载。一个400行的Skill完整加载可能占据3000多个token,在上下文窗口充裕时看似不多。但考虑到实际的对话场景中往往还存在系统指令、多轮历史、用户上传的文档等,窗口很快会捉襟见肘。成熟的解决方案是进行模块化拆分:主文件只保留最核心的路由逻辑和通用守则(可能仅80行),具体的、复杂的流程放到子文件中,通过工具调用按需读取。这样可以将常驻内存的token占用大幅降低,省出来的空间,全部留给用户的真实需求和模型的思考过程,这才是提升最终效果的关键所在。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
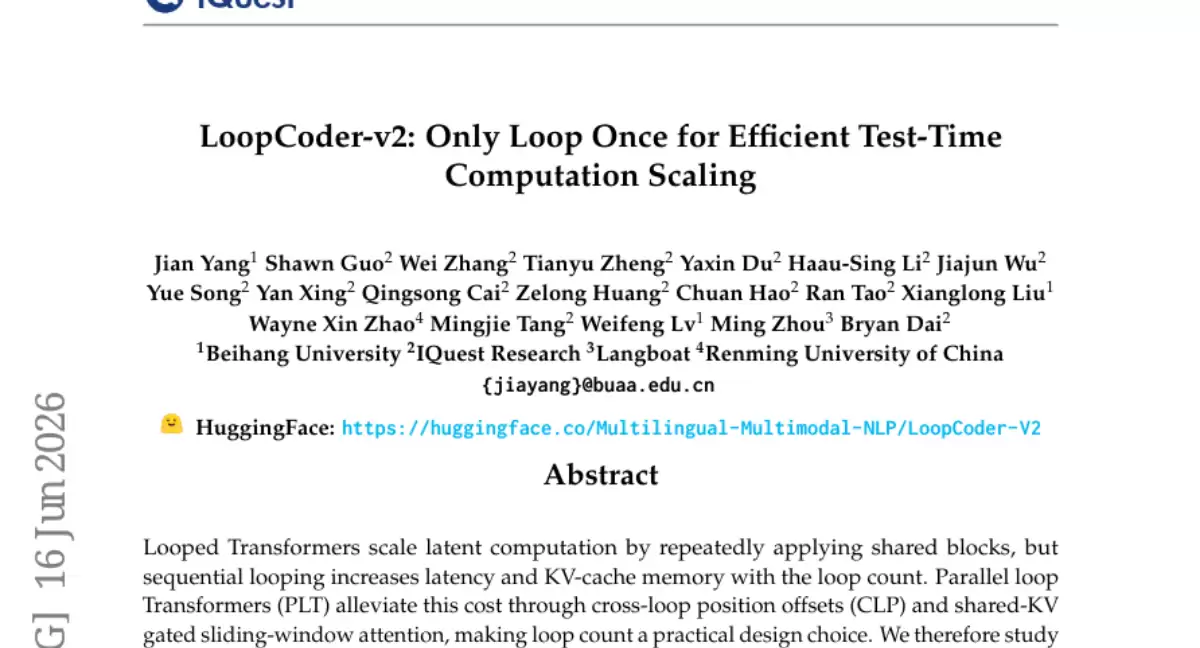
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
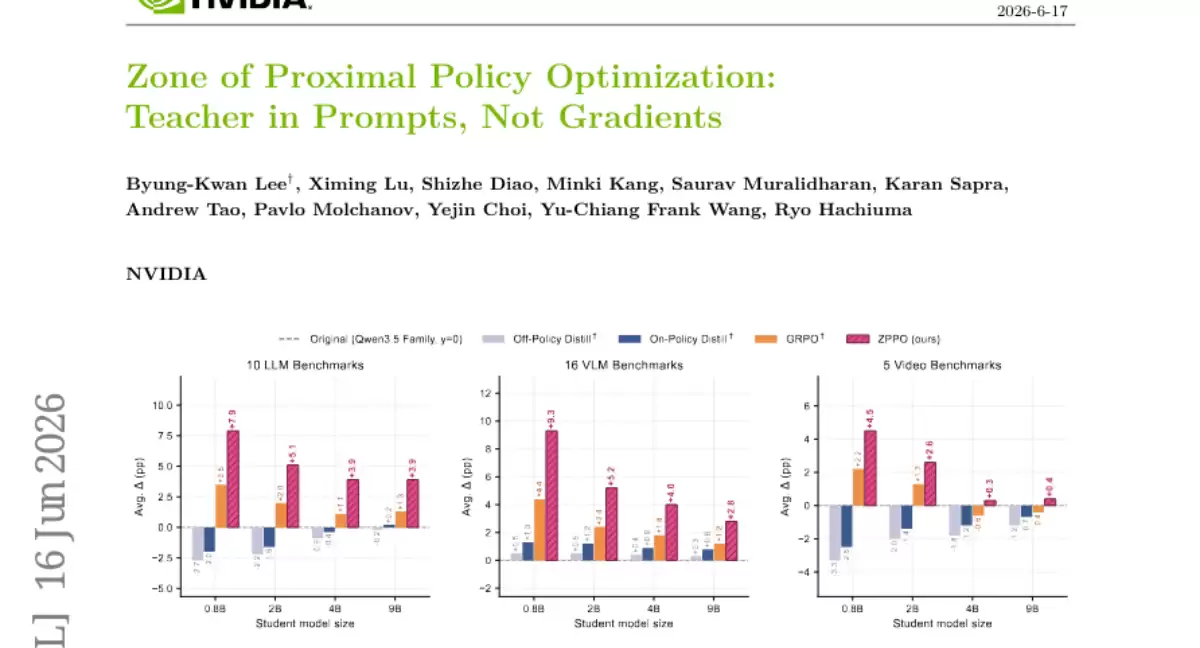
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
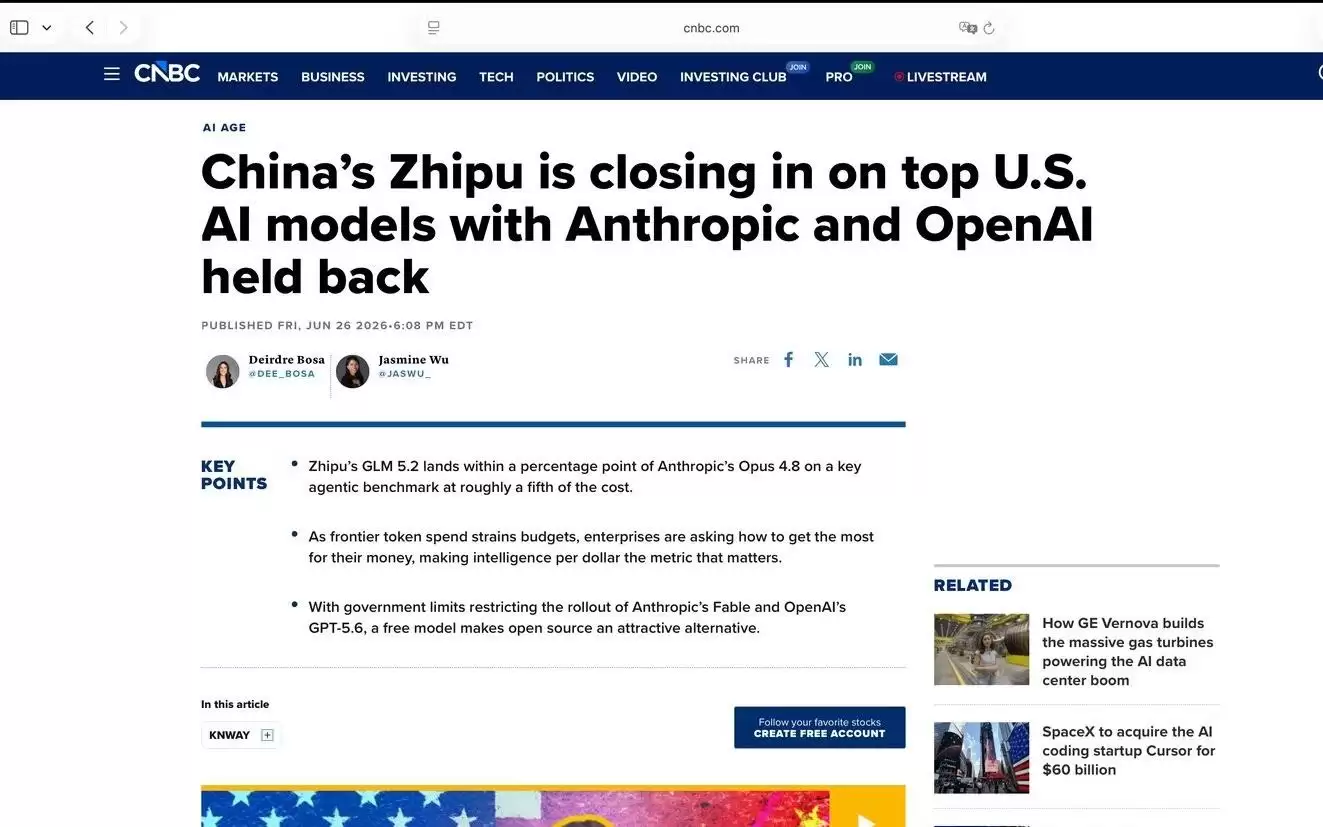
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
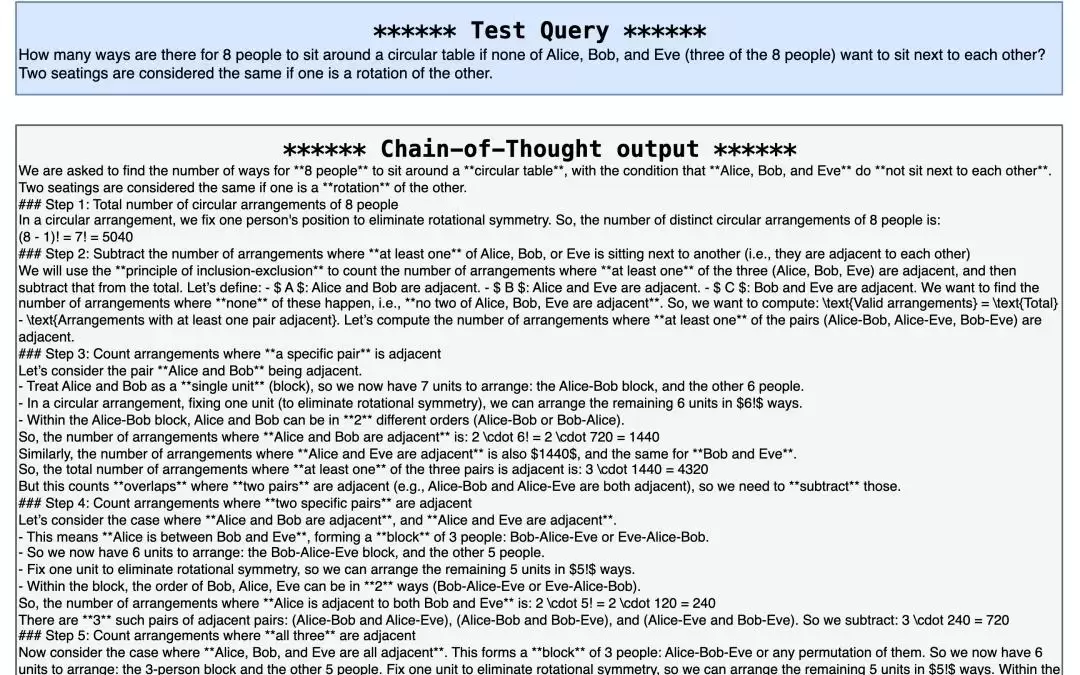
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
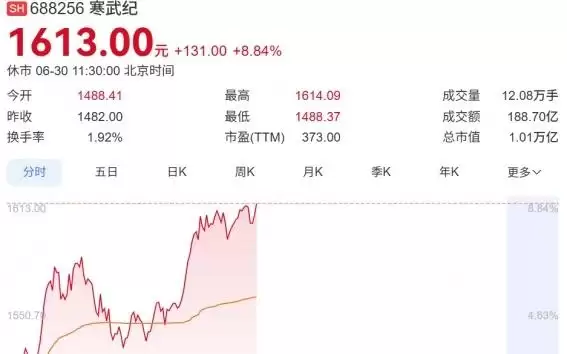
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。
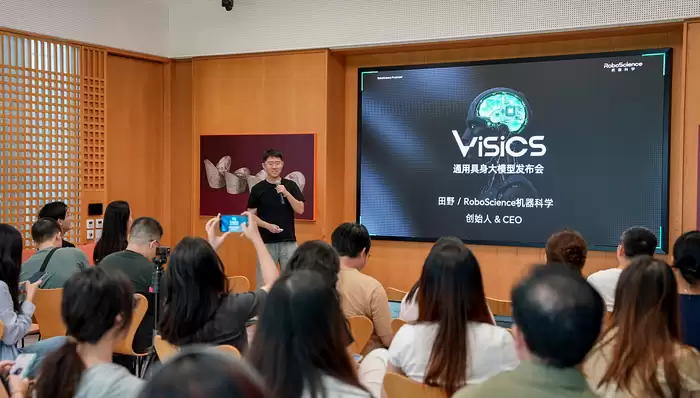
前苹果AI平台技术负责人田野回国创立RoboScience机器科学,发布VLOA架构,通过物体轨迹解耦硬件,利用互联网视频和仿真生成海量数据,将单条数据成本降至几分钱,实现机器人读说明书拼装家具等复杂任务。
纳睿雷达发布两款新品:S波段全极化多功能有源相控阵雷达可实时监测超460公里范围内中小尺度强对流天气并预警灾害;超精细化短时临近AI气象大模型实现0-24小时致灾强对流天气精准预报,分辨率达分钟级街道级。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,