

C++STL进阶:手写priority_ueue与仿函数机制详解
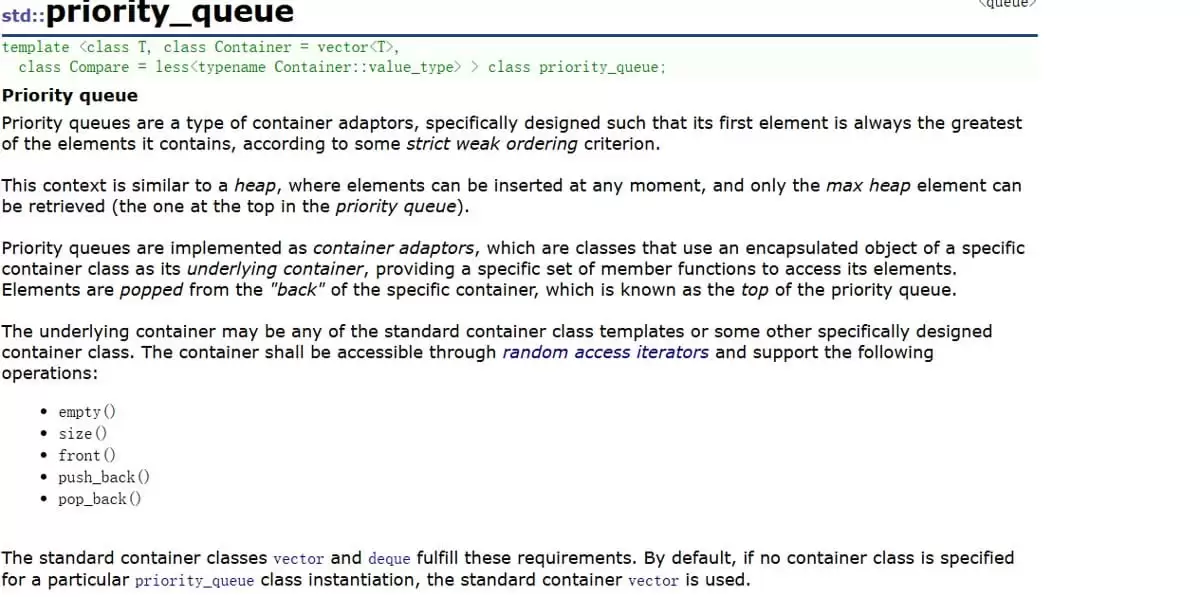
1. 引言:什么是priority_queue 在C++标准库的众多容器中,priority_queue(优先级队列)是一个既实用又充满设计巧妙的组件。它不像vector或list那样直接存储数据,而是一个“容器适配器”。这意味着它站在巨人的肩膀上,复用现有容器的能力,并赋予其全新的行为逻辑。 简单
1. 引言:什么是priority_queue
在C++标准库的众多容器中,priority_queue(优先级队列)是一个既实用又充满设计巧妙的组件。它不像vector或list那样直接存储数据,而是一个“容器适配器”。这意味着它站在巨人的肩膀上,复用现有容器的能力,并赋予其全新的行为逻辑。
简单来说,你可以把它想象成一个智能的“排队系统”:每次有人离开队伍(pop),走掉的总是当前队伍里“优先级最高”的那位,而不是先来后到。这种特性使其在需要频繁获取最大或最小元素的场景中,比如任务调度、数据流的中位数查找,效率极高。
1.1 基本概念
从接口上看,priority_queue的核心操作非常简洁:
- 插入(
push):时间复杂度为 O(log N)。 - 删除堆顶(
pop):时间复杂度为 O(log N)。 - 查看堆顶(
top):时间复杂度为 O(1)。
关键在于,每次执行pop,弹出的永远是当前队列中优先级最高的元素。至于什么是“高优先级”,则由你定义的比较规则来决定。
1.2 底层结构
它的高效并非魔法,而是源于其底层数据结构——堆(Heap)。默认情况下,priority_queue使用std::vector作为底层容器,并在其上维护一个堆结构:
- 大顶堆:父节点的值总是大于或等于子节点的值,因此
top()返回的是最大值。 - 小顶堆:父节点的值总是小于或等于子节点的值,因此
top()返回的是最小值。
堆的性质通过两个核心操作来维持:向上调整(Heapify Up)用于插入元素后恢复堆序,向下调整(Heapify Down)用于删除堆顶元素后恢复堆序。
这里有一个初学者容易困惑的点:priority_queue的默认比较行为是“反直觉”的。默认使用std::less仿函数,结果却构建了一个大顶堆(值大的优先级高);而使用std::greater时,反而构建了小顶堆(值小的优先级高)。在实现时,我们需要严格遵循这一设计。
1.3 比较器的默认行为
priority_queue的灵活性很大程度上来自于它的模板参数Compare。这个参数用于定义元素间的优先级比较规则。
- 如果不显式指定,默认使用
std::less。 std::less本身是一个仿函数(Functor),其内部就是调用operator<。- 在默认的
std::less下,priority_queue表现为大顶堆。
因此,如果你需要一个小顶堆,只需显式传入std::greater即可。当然,你也可以传入任何自定义的仿函数,来实现更复杂的优先级逻辑。
注意:比较器并非必须手动编写,它有默认行为。 是否显式提供,完全取决于你是否需要改变默认的排序规则。下文我们会通过显式构造来深入演示仿函数是如何工作的。
2. priority_queue的核心实现
理解了它的外在行为,我们不妨深入内部,看看一个简易版的priority_queue是如何搭建起来的。这能帮助我们更好地理解其设计哲学。
2.1 成员变量与默认构造
2.1.1 结构框架与默认构造
首先,我们定义类的骨架。可以看到,它采用了模板来提供高度的可配置性。
template, class Compare = Less > // 这里的Container和Compare模板参数,正是为了清晰地展示底层结构 class priority_queue { public: priority_queue() = default; // 使用编译器生成的默认构造函数 private: Container _con; // 底层容器 };
这里引入了两个关键模板参数:Container(底层容器类型)和Compare(比较仿函数类型)。它们正是“适配器模式”和“仿函数机制”的体现,我们稍后会详细展开。
2.1.2 迭代器区间构造
除了默认构造,一个实用的构造函数是接受一个迭代器区间,并用其中的元素初始化堆。
templatepriority_queue(InputIterator first, InputIterator last) :_con(first, last) // 先用区间初始化底层容器 { // 底层容器有了数据,但逻辑上还不是堆,需要“建堆” // 这里采用效率更高的“向下调整建堆法” for (int i = (_con.size() - 1 - 1) / 2; i >= 0; i--) { adjust_down(i); } }
为什么选择向下调整建堆?因为它的时间复杂度是O(N),优于逐个插入的向上调整建堆法O(N log N)。建堆的核心是adjust_down函数:
void adjust_down(size_t parent) {
    Compare com; // 实例化比较器
    size_t child = parent * 2 + 1; // 先默认左孩子
    while (child < _con.size()) {
        // 如果存在右孩子,且右孩子“优先级更高”,则让child指向右孩子
        if (child + 1 < _con.size() && com(_con[child], _con[child + 1])) {
            child++;
        }
        // 关键比较:如果父节点“优先级低于”选出的孩子节点,则交换
        // 在大堆中:parent < child 时,com(parent, child)为true,交换
        // 在小堆中:parent > child 时,com(parent, child)为true,交换
        if (com(_con[parent], _con[child])) {
            swap(_con[parent], _con[child]);
            parent = child;
            child = parent * 2 + 1;
        }
        else {
            break; // 父节点已满足堆序,调整结束
        }
    }
}
2.2 push插入数据
插入操作的逻辑很直观:先把新元素放到数组末尾,然后执行向上调整,使其“上浮”到正确位置。
void push(const T& x) {
    _con.push_back(x);
    adjust_up(_con.size() - 1); // 从最后一个位置开始向上调整
}
向上调整算法adjust_up是adjust_down的逆向过程:
void adjust_up(size_t child) {
    Compare com;
    while (child > 0) {
        size_t parent = (child - 1) / 2;
        // 如果孩子节点“优先级高于”父节点,则交换
        if (com(_con[parent], _con[child])) {
            swap(_con[parent], _con[child]);
            child = parent;
        }
        else {
            break;
        }
    }
}
2.3 pop删除数据
删除堆顶元素是优先级队列的核心。技巧在于,不能直接删除首元素,那样会破坏结构。标准做法是:
void pop() {
    assert(!empty());
    // 1. 将堆顶元素与末尾元素交换
    std::swap(_con[0], _con[_con.size() - 1]);
    // 2. 删除现在的末尾元素(即原堆顶)
    _con.pop_back();
    // 3. 对新的堆顶元素执行向下调整,恢复堆序
    adjust_down(0);
}
2.4 top / empty / size
这些接口的实现最为直接,因为它们不改变堆结构:
const T& top() const { return _con[0]; } // 堆顶即优先级最高者
bool empty() const { return _con.empty(); }
size_t size() const { return _con.size(); }
看到这里,你可能已经注意到,整个实现高度依赖于两个设计:适配器模式(通过Container参数选择底层容器)和仿函数机制(通过Compare参数定义优先级规则)。这正是priority_queue设计精妙之处,下面我们来详细剖析。
3. 适配器模式与priority_queue的设计
3.1 什么是适配器模式
适配器模式,顾名思义,就是“转换接口”的设计模式。生活中最常见的例子就是电源适配器:把墙上的220V交流电,转换成手机需要的5V直流电。
在软件设计中,容器适配器也是如此。它不自己管理内存,而是“包装”一个已有的底层容器(如vector、deque),通过限制或改变其接口,提供一种全新的数据结构语义。stack和queue也是容器适配器的典型代表。
3.2 priority_queue的适配器设计
回顾我们的类模板声明:
template, class Compare = Less > class priority_queue { Container _con; // ... };
Container:指定底层容器类型,默认是vector。你也可以换成deque等支持随机访问和尾插尾删的容器。Compare:指定比较仿函数类型,默认是Less(对应大顶堆)。
这种设计的精妙之处在于:模板参数的缺省值让普通用户无需关心细节即可使用(priority_queue),同时又为高级用户保留了完全的定制能力(可以指定底层容器和比较规则)。这就是“适配”思想的完美体现。
4. 仿函数
如果说适配器模式决定了priority_queue的“身体”,那么仿函数就赋予了它灵活的“灵魂”。
4.1 什么是仿函数
仿函数,也叫函数对象,本质是一个类,但它重载了函数调用运算符operator(),使得该类的对象可以像函数一样被调用。
一个最简单的比较仿函数定义如下:
templateclass Less { public: bool operator()(const T& x, const T& y) { return x < y; } }; template class Greater { public: bool operator()(const T& x, const T& y) { return x > y; } };
4.2 仿函数的用法
4.2.1 作为比较器,控制容器或算法的行为
这是仿函数最经典的用途。通过将“比较规则”作为参数传入,我们可以轻松定制容器或算法的行为,而无需修改其内部代码。
示例1:控制优先级队列是大堆还是小堆
int main() {
    // 默认使用 Less → 大堆
    ZL::priority_queue pq1;
    // 显式指定 Greater → 小堆
    ZL::priority_queue, Greater> pq2;

    pq1.push(100); pq1.push(5); pq1.push(200); pq1.push(10);
    while (!pq1.empty()) {
        cout << pq1.top() << " "; // 输出:200 100 10 5
        pq1.pop();
    }
    return 0;
}
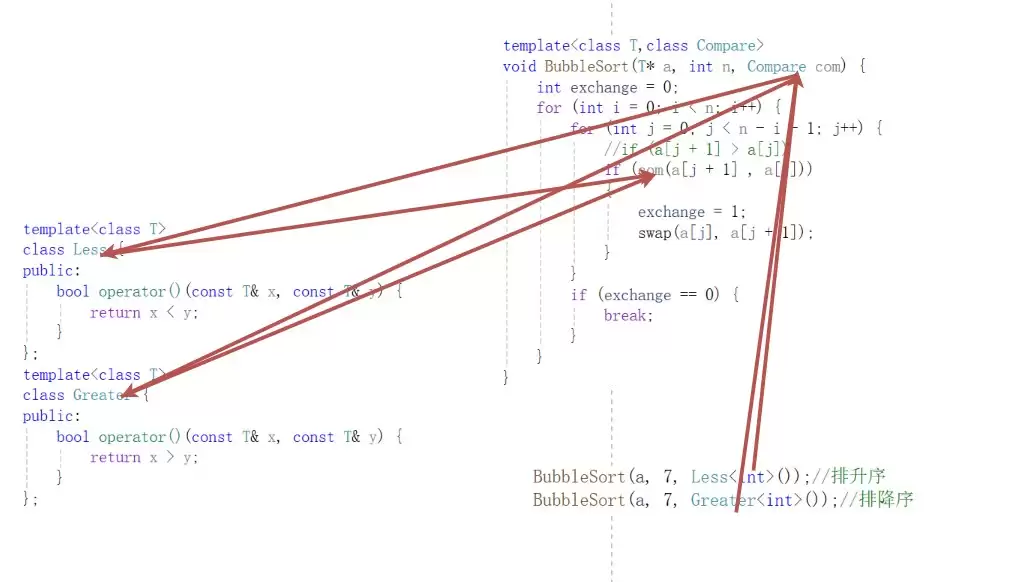
示例2:控制排序算法的升降序
templatevoid BubbleSort(T* a, int n, Compare com) { for (int i = 0; i < n; ++i) { for (int j = 0; j < n - i - 1; ++j) { // 比较规则由传入的仿函数对象决定 if (com(a[j + 1], a[j])) swap(a[j], a[j + 1]); } } } int main() { int a[] = { 1,3,4,5,6,3,2 }; BubbleSort(a, 7, Less ()); // 升序排序 BubbleSort(a, 7, Greater ()); // 降序排序 // ... }
4.2.2 作为判断条件或转换规则
仿函数的能力不限于比较。任何需要“可调用对象”的场景,它都能胜任。
示例1:作为判断条件(查找第一个偶数)
struct IsEven {
    bool operator()(int x) {
        return x % 2 == 0;
    }
};
int main() {
    int a[] = { 1,3,2,9,1,3,4,5 };
    // 使用 find_if 算法,配合仿函数作为谓词
    auto it = find_if(a, a + 7, IsEven());
    cout << *it << endl; // 输出:2
    return 0;
}
示例2:作为转换规则(将偶数乘以2)
struct DoubleIfEven {
    int operator()(int x) {
        return (x % 2 == 0) ? x * 2 : x;
    }
};
int main() {
    vector v = {1, 2, 3, 4, 5};
    // 使用 transform 算法,对每个元素应用仿函数进行转换
    transform(v.begin(), v.end(), v.begin(), DoubleIfEven());
    // v 变为 {1, 4, 3, 8, 5}
    return 0;
}
4.2.3 处理指针时自定义比较逻辑
这是一个非常实用的场景。当我们存储的是指针时,默认比较的是指针地址,而非指针所指对象的内容。仿函数可以轻松解决这个问题。
// 假设 Date 类已重载了 operator<
struct PDateLess {
    bool operator()(const Date* p1, const Date* p2) {
        return *p1 < *p2; // 比较的是Date对象本身,而非指针地址
    }
};

int main() {
    ZL::priority_queue, PDateLess> q1;
    q1.push(new Date(2018, 10, 29));
    q1.push(new Date(2018, 10, 28));
    q1.push(new Date(2018, 10, 30));
    while (!q1.empty()) {
        cout << *q1.top() << " "; // 按日期顺序弹出
        delete q1.top();
        q1.pop();
    }
    return 0;
}
这里自定义仿函数的意义在于“纠正”默认行为:让优先级队列比较Date对象的内容,而不是存储它们的指针地址。
4.3 仿函数存在的意义
那么,为什么C++要引入仿函数,而不是一直使用函数指针呢?从根本上说,仿函数是现代C++为了摒弃函数指针的诸多缺陷而提供的更优解决方案。下面的表格清晰地对比了两者的差异:
| 面临的问题 | 使用函数指针的痛点 | 使用仿函数的优势 |
|---|---|---|
| 算法需要多种行为 | 需要编写多个函数,或传递函数指针,效率低且通常无法内联优化。 | 将行为封装成类,编译器可以轻松内联operator()调用,几乎没有额外开销。 |
| 需要携带状态 | 普通函数无法在多次调用间保持状态(除非使用全局或静态变量,但这会破坏封装)。 | 仿函数是类,可以拥有成员变量,自然地在多次调用间维护状态信息。 |
| 类型安全 | 函数指针的类型检查相对较弱,容易传递错误类型的函数。 | 仿函数是具体的类类型,模板参数推导和类型检查更为严格。 |
| 与模板结合 | 函数指针作为模板参数语法不直观,且能力有限。 | 仿函数作为类型,可以无缝作为模板参数,使用起来非常自然。 |
| 复杂规则封装 | 复杂的比较或操作逻辑难以复用和组合。 | 一个仿函数类可以实例化多个对象,在程序各处复用,也易于通过继承或组合来构建更复杂的逻辑。 |
正是这些优势,使得仿函数(以及后来出现的lambda表达式)成为现代C++泛型编程和STL设计中不可或缺的一环。理解了它,你也就掌握了priority_queue乃至整个STL灵活性的钥匙。
解决 Visual Studio 2022 安装时 UAC 权限不足问题,包括正确使用管理员权限启动安装程序、确认账户类型以及应对组织策略限制的建议。
掌握 Visual Studio 2019 安装技巧,通过工作负载和单个组件的合理选择,避免安装冗余工具,提升开发效率。
了解 Visual Studio 2022 安装移动开发组件时的空间占用逻辑。掌握如何根据实际需求勾选工作负载,利用安装器估算功能,管理下载缓存以优化磁盘空间使用。
Visual Studio 2019 支持与 2017 并行安装。迁移时应先盘点工作负载与扩展,使用项目副本验证兼容性,避免盲目接受单向迁移。确认构建、测试及 CI 流程在新环境中稳定运行后,再制定切换计划,确保开发效率与项目安全。
详解如何在低配电脑上高效安装 Visual Studio 2022,包括硬件评估、工作负载精准选择、组件按需补充及存储优化策略,帮助开发者节省空间并提升运行效率。
当 Visual Studio 2022 的某个工作负载出现文件缺失或状态异常时,无需修复整个实例。本文详解如何通过 Installer 移除并重装单一工作负载,包括如何准确定位问题组件、执行两次修改操作、验证功能恢复以及何时升级为全局修复,确保开发环境稳定且配置不受影响。
当 Visual Studio 2019 出现安装失败、组件异常或更新错误时,可通过 Visual Studio Installer 进行修复。本文详细说明了修复功能的适用范围、操作步骤及常见问题处理,帮助用户快速恢复开发环境。
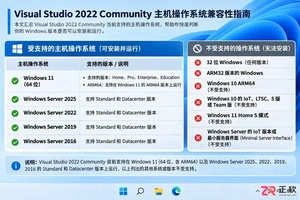
了解 Visual Studio 2022 社区版支持的 Windows 11 版本、Windows Server 版本及架构限制。区分 IDE 安装环境与目标开发平台,避免在 S mode、IoT 或不受支持的系统上尝试安装。
详解 Visual Studio 2019 离线安装包的制作与分发流程,包括使用 --layout 创建本地缓存、通过共享文件夹或 U 盘分发,以及在目标机器上使用 --noWeb 参数进行离线安装的具体步骤。
指导用户在 Visual Studio 2026 安装过程中自定义下载缓存路径,明确区分 IDE 本体、下载缓存及共享组件的位置设置,并说明首次安装后的路径修改限制。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



